台鐵訂票祕書:門診行程與已訂車票自動對帳的畫面

幫我訂今晚回花蓮的票:做一個台鐵訂票祕書

在花東跨院支援門診,最花心神的其實不是看診,是回程的火車票。下診時間不固定,玉里、關山、臺東各有各的班次窗口,加上夏天傍晚的花東線,坐錯邊就是整路被太陽曬🥵 這種事就該交給 Claude。這幾天我們把「訂票祕書」做起來了,今天真的用它訂了回花蓮的票。 這篇的重點 為什麼一張車票會需要一個系統:門診表、停診公告、台鐵訂票紀錄三份資料要對得起來 門診行程 × 車票總覽:哪一天缺哪一段車票,打開一眼看出來,勾一勾批次訂完 座位側別是推算出來的:環島路網的海側是不變量,配上各車種的座號餘數表就能判定曬不曬 不只避曬:邊緣列、輪椅座正後方的桌板位、到站出口最近的車廂,全部進同一個評分 建置用到的工具:本機瀏覽器自動化、交通部 TDX 開放資料、Cloudflare Tunnel、DPAPI、ntfy 有人問了一句「這樣用可以嗎」,於是我把台鐵條款、鐵路法修法沿革和 32 件相關判決全部讀完,並據此改掉了訂票邏輯 為什麼這個專案不開源:自我約束只存在於我這台電腦上,工具放出去就管不到別人拿去做什麼了 一張車票,為什麼會需要一個系統 我的支援門診固定在幾條路線上:週一玉里來回,隔週三花蓮到關山、關山再到臺東、傍晚回花蓮。看起來規律,實際訂票時要同時記住三件事: 哪幾天要去哪裡:門診是規則排的,但會有停診 哪幾段已經訂了、哪幾段還沒:台鐵的訂票紀錄頁面預設只顯示最近幾筆,一次要訂一個月的票就得自己數 那一班的座位坐哪邊:這是最後才想得到、卻最影響搭車體驗的一件事 以前是靠記憶加上翻訂票 App。做成工具之後,這三件事變成一個畫面。 門診行程 × 車票:先對帳,再訂票 打開祕書站的第一個畫面不是班次表,是未來四週的門診行程,每一段旅程旁邊掛著它的車票狀態。 這一頁背後接了三份資料: 門診日由排班規則生成(週一玉里、隔週三關山與東基,錨定在一個已知日期往後推) 停診直接讀我自己門診資訊頁背後的同一個 API。同一份資料兩個用途:對外公告停診,對內就不會排出一段不存在的行程 已訂車票去台鐵會員的訂票紀錄掃,把每筆訂單拆成「日期+起站+迄站」,跟行程比對 對得上的顯示 ✅ 加車次、訂票代碼與付款狀態;對不上的就是一個空的勾選框,寫著「未訂(預設 441 次)」。 缺的票勾一勾,丟進購物車,按一次全部訂完。 批次訂票的順序是嚴格排隊的:後端有一把工作鎖,一筆訂完才開始下一筆。原因很單純,訂票是操作同一個瀏覽器分頁,兩筆並行只會互相踩到。 要自己挑班次時,還有一個班次看板:選日期、看時刻、點「訂」,跳出張數、靠窗或走道、要不要避曬的選單。 座位:曬不曬是可以算出來的 這是整個專案最好玩的部分。訂票網站不會告訴你這個座位在哪一側,但這件事其實可以推。 海側與山側是不變量 台鐵環島路網是一個環。固定編組的列車兩端都有駕駛室,中途從不調頭,而環島線的「海」永遠在外圈。所以一個座位是海側還是山側,全線、雙向都不會變。 會變的是方位:花東線的海側朝東,南迴線的海側朝南,屏東與縱貫線南段的海側朝西。所以只要知道「海側」,再知道現在走到哪一段、幾點,就能判斷太陽在不在你這一邊。 座號的餘數決定一切 台鐵的座位編號有規律,座號除以 4 的餘數是 1 或 2 就是靠窗,3 或 0 是走道(例外:EMU3000 第 6 車騰雲座艙是 2+1 配置,餘數 0 才是那排單人靠窗座)。再往下一層,餘數也決定左右: ...
August 5, 2026 · 2 分鐘 · 332 字 · 陳柏威 Po-Wei Chen
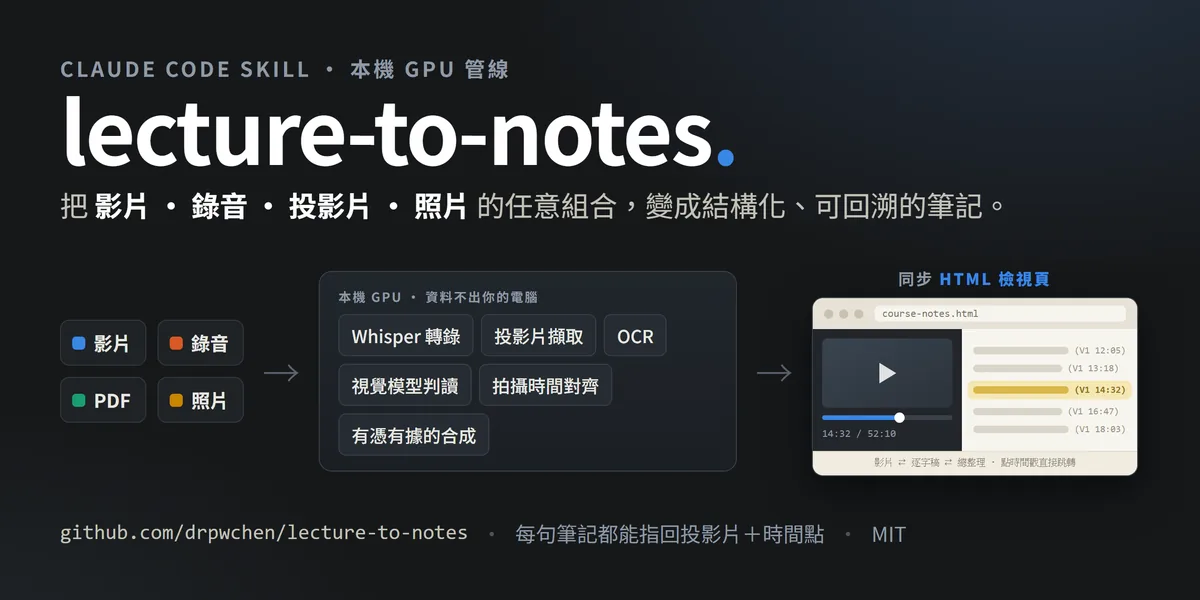
lecture-to-notes:把影片、錄音、投影片、照片的任意組合變成結構化、可回溯的筆記

把演講影片變成真的會回去看的筆記:lecture-to-notes 開源了

前陣子在臉書分享過用 AI 整理課程影片的成果,收到超乎想像的迴響,也一直有人問工具什麼時候放出來。整理了一陣子,今天正式開源:lecture-to-notes。 這篇的重點 為什麼課程錄影大家都在錄,卻沒有人回去看完 筆記不必是「文字+圖」的形狀:影片、逐字稿、總整理同步在一頁 手上有什麼就帶什麼來:錄影、錄音、投影片、照片,全部接上同一條時間軸 技術上堅持的幾件事:逐字稿永不自動改字、對時用證據不用猜 為什麼只有 OCR 不夠:沒有字的流程圖與超音波,怎麼判斷它重不重要 沒有 NVIDIA 顯卡也能跑的退階方案 教室後面的腳架森林 從以前就覺得復健科的課程很難做筆記。徒手治療、超音波掃描這種課,知識藏在「動作」裡,文字怎麼抄都抄不起來。所以現場永遠是滿滿的腳架,大家都在錄影,打算回去配飯複習。 但幾小時的影片,實際上根本不會回去看完。 想通的一個轉折:筆記不必是「文字+圖」的形狀 有了 AI 之後,我原本的思路是教它精準截圖,把影片塞回傳統「文字+圖片」的筆記形式。後來想通了:筆記不必拘泥於那個形狀。 直接做一個網頁,把影片跟逐字稿對上,想看哪段就跳到哪段。畢竟真正想知道的,是那個動作到底怎麼做——那只存在於影片裡。 所以最後的成品是三個層次疊在同一頁: 總整理拿來讀:結構化的重點筆記,配上當時的投影片 逐字稿拿來驗證:每句話都有時間戳 影片永遠在一鍵之外:影片播到哪,筆記自動高亮;點筆記的時間戳,影片直接跳過去 同一份內容還會輸出 markdown 進 Obsidian 筆記庫(之後語意搜尋找得到),以及 PDF 給不用這些工具的人。一堂課,三種耐久形態。 (截圖是一場頸椎超音波工作坊的實際輸出,日期與講者已馬賽克。) 手上有什麼就帶什麼來 真實的課程從來不會只有一支乾淨的錄影:有的講題錄了影、有的只錄到音、有的只用手機拍了投影片,會後主辦單位又補發一份 PDF 講義。 這個工具把資料夾原樣吃進去,自動判斷每個檔案扮演什麼角色,再把所有來源接上同一條時間軸——就算某張投影片從頭到尾沒出現在影片畫面裡,筆記引用到它的那一刻仍然指得回正確的時間點。 技術上堅持的幾件事 這個工具的設計目標不是「摘要一支影片」,而是可回溯(traceability):筆記裡每句話都要能指回逐字稿的某個時間點、以及當下螢幕上那張投影片。幾個為此堅持的設計: 貴的事情全部在本機跑 Whisper 轉錄、抽幀、OCR、投影片語意判讀,全部在自己的 GPU 上跑完,零 API 費用。大型語言模型只在最後一步負責「寫」,而且只能根據前面各階段已經組好的證據寫。就算不跑最後一步,你也已經拿到逐字稿、去重後的投影片集、和兩者的對應關係。 逐字稿永遠不自動改字 自動改錯字聽起來很誘人,我們實際做了兩版、量測、然後全部退役。現在可疑的詞只會被「標記」出來,逐字稿本身一個 byte 都不動。每個標記是一個問題,不是一個替換——因為改錯了你永遠不會發現。 對時:檔案時間是假說,交叉比對才是證據 一場演講常常不只一個裝置在錄:主錄影、手機片段、照片。要拼回同一條時間軸,最直覺的做法是相信每個檔案自己的拍攝時間——而手機時鐘會漂移、有些檔案只剩修改時間、按過暫停的錄影會謊報自己的開始時間。 所以管線把兩件事分開:拍攝時間當「主張」,重疊音訊的交叉比對當「證據」。兩者差超過 5 秒,就標記衝突並停下來問人,絕不自動修正。這擋掉的是「44 分鐘對錯位、但每一頁輸出看起來都很正常」的災難。 缺工具就大聲說,不悄悄降級 選用的模型都經過自己資料的評測(repo 裡附了 OCR 引擎的 A/B 測試架)。可選的套件沒裝,功能會關掉並明講你少了什麼——絕不悄悄換一個比較差的方法。悄悄降級產生的是「錯的輸出」而不是「少的輸出」,那是最貴的一類 bug。 那張投影片上沒有半個字,怎麼辦? 貼文發出來之後,有位朋友留言問:「請問您是把螢幕上的 PPT 以 OCR 方式彙整進入資料庫嗎?」這個問題剛好戳中我卡最久的一段,值得展開講。 ...

August 3, 2026 · 1 分鐘 · 183 字 · 陳柏威 Po-Wei Chen
讓 AI 自己調查自己為什麼一直犯錯:違規計數器 vs 週稽核全數通過的對比

讓 AI 自己調查自己為什麼一直犯錯

用 AI 工作一陣子的人,大概都遇過這件事:同一個錯,你講過了,規則也請它記下來了,過幾天它又犯一次。 而且我不是沒有防:規則寫進了它的記憶檔、違規有計數器、還有每月的定期檢視,該有的機制都在。但七月底,我看著我的 AI 助理第三次犯下同一個錯(最後兩次只隔一天),才認真面對一個事實:「記得」跟「會做」是兩回事。而更意外的是,後來的調查發現,問題甚至不在它不記得,是我們整套「記錯誤」的系統,量尺本身壞掉了。 這篇想分享的,就是我們最後長出來的一套「AI 自我糾錯系統」的設計,以及中間最有趣的一段:我讓 AI 自己調查自己,還特別交代它「不要相信寫交班單的那個 AI」。 事情是怎麼爆開的 這陣子我陸續把一些自己做的工具開源(工具箱總整理裡的那些)。發布開源軟體有一套禮儀:改了什麼要寫進更新紀錄(CHANGELOG)、打版本標籤(tag)、在 GitHub 上建立正式的發布頁(release)。這些規則早就寫在 Claude 的記憶檔裡。 七月底某天,我點開一個剛發布新版的 repo,首頁看起來什麼都沒有。我第一反應是「你沒寫 CHANGELOG」。它查了之後回報:CHANGELOG 其實寫了,tag 也打了,漏的是最後一步「建立 release」,而那恰好是訪客唯一看得到的一步。回頭一查,前兩個版本也都一樣。 隔天我請它把我全部十三個公開 repo 掃一遍,結果挖出十五個同樣的缺口。更妙的是,就在稽核到一半的時候,它又犯了第三次同型的錯。規則就寫在它的記憶裡,它也讀得到,然後照樣犯。 關鍵的一問:「你以後真的會用嗎?」 它的第一個提案很自然:寫一支腳本,把正確的發版流程整個包起來。 我問了一句:「你以後會固定呼叫這支腳本嗎?」 它想了一下,誠實地說:不會。腳本跟記憶檔的失效模式一模一樣,都要它先「想起來」才有用。這個答案讓我們改變了做法:與其多一個要記得的東西,不如加一道攔截(hook,上手系列第二篇講過的關卡概念):只要它想手動跑發版指令,動作會在當下直接被擋下來,只剩包好的正確流程能走。從「請你記得」變成「你想錯也錯不了」。 讓它調查自己,但不准相信自己 前面說過,揪錯的零件一直都在。所以問題比「沒有機制」更刁鑽:零件都在,錯還是溜過去了,到底卡在哪? 這裡我們用了一個我很喜歡的設計。當天犯錯的那個 AI session 把來龍去脈寫成一份調查交班單,但裡面明白寫著一條: 交班單裡的自我迴避條款 「不要把我的假設當成計畫——這份文件是犯錯者本人寫的,幾乎必然被它的立場影響。請先獨立驗證診斷,再決定要不要建任何東西。」 接著換一個全新的 session 接手調查,手上只有可以重跑的驗證指令,沒有前一位的結論。 做過品質改善的人應該覺得眼熟:根本原因分析(root cause analysis)的調查,本來就不該由事件當事人自己主導。當局者迷這件事,對 AI 一樣成立。 調查結果:推翻了兩個前提 獨立調查翻出來的東西,跟交班單猜的不一樣。 第一,AI 並沒有隱瞞錯誤。我原本合理懷疑:違規次數是它自己記的,它會不會少記?結果翻遍紀錄,低報只有零星幾筆,而且是「自首了但記錯地方」。其中一個規則檔裡,它老老實實記了十二次違規,好幾次我根本沒發現。誠實度不是問題。 第二,問題出在量測層。幾個具體的發現: 計數無法歸屬:違規次數記在「檔案」上,但一個檔案裡合併了十幾條規則。帳面上的「違規 4 次」,追不回是哪一條規則的 4 次,這個數字沒有行動意義。 偵測器本身有 bug:負責從歷史對話裡撈「使用者糾正過什麼」的程式,寫死了只看最近二十筆,而且漏看一整類訊息格式。回頭驗證時發現,最關鍵的那筆證據,它從結構上就不可能抓到。 記錯帳本:有三筆真正的違規,被寫進了另一本記「工具摩擦」的帳,正好躲過所有檢查。 還有一個反轉:交班單斷言「這些計數完全沒有版本紀錄,無從稽核」。錯了——記憶目錄其實一直有自己的 git 版本庫,一千多筆自動存檔,稽核軌跡從頭到尾都在,只是被上層設定蓋住,連 AI 自己都不知道。 換句話說:這個系統不缺零件,缺的是接線。計數器沒有人讀、偵測器壞著、帳本記錯棚。在量尺壞掉的情況下加更多自動化,只是把錯的數字算得更快而已。所以後面的修法幾乎沒有新建什麼大東西,都是把既有的零件接起來。 最後的設計:四條原則 修完之後,整套系統收斂成四條原則。它們不是 AI 專用的,你會發現每一條在醫院的品質管理裡都有對應物。 一、錯誤要記成「可歸屬的事件」,不是一個數字。每次違規記一行:日期+哪一條規則+一句事實。計數是用數的,不是用手改的。(對應:異常事件通報寫事件經過,不是只在統計表上加一。) ...

August 1, 2026 · 1 分鐘 · 99 字 · 陳柏威 Po-Wei Chen
AI 上手系列③:自動化流程不是設計出來的,是長出來的 — 起手五件事與重複第三次就升一級的階梯

自動化流程不是設計出來的,是長出來的:從一句話到一條產線

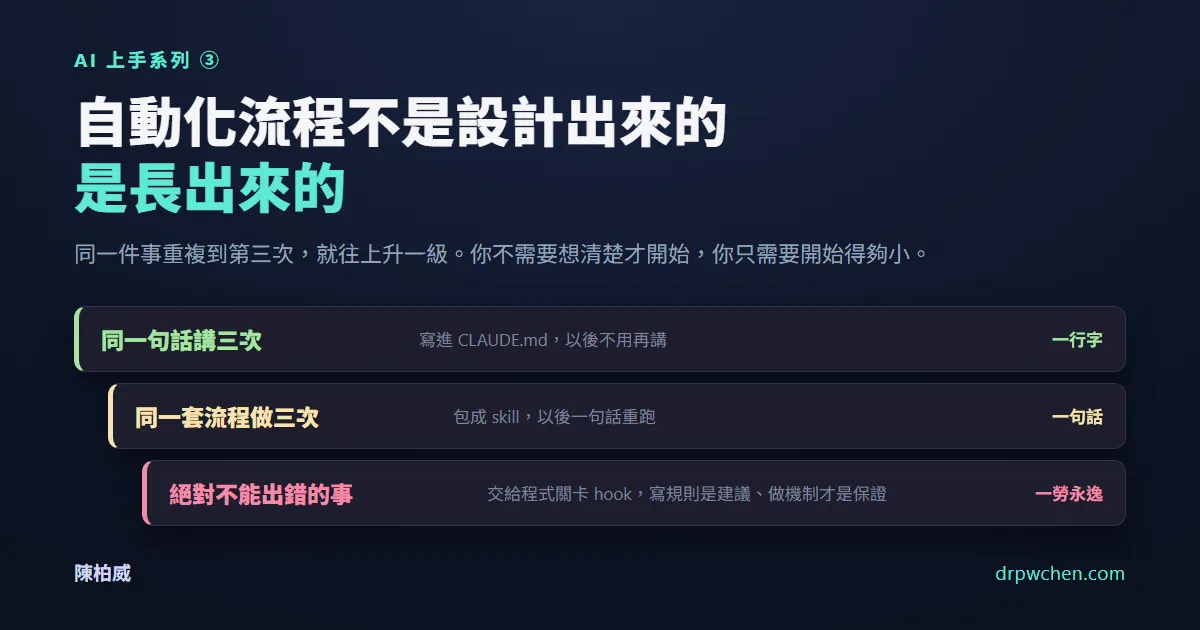
這是 AI 上手系列的第三篇。第一篇講怎麼裝起來,第二篇講怎麼跟它講話、怎麼設關卡。 第二篇的結尾我說:難的從來不是「怎麼問」,是「怎麼設計流程」。 這篇要把那句話收掉。答案可能跟你想的相反:流程不是設計出來的,是長出來的。 最常見的卡點:「我不知道要怎麼開始規劃」 我被問過很多次類似的問題:「你那套自動化好厲害,我要怎麼規劃我自己的?」 老實說,我從來沒有規劃過。我三月的時候只做了一件事:挑了一件每週都在重複的小事,叫它做一次。 今天回頭看,我的規則檔、十幾個 skill、一堆自動排程,沒有一個是事先設計的。每一個都是同一件事重複了幾次之後,才「升級」成現在的樣子。 所以如果你卡在「不知道怎麼開始」,好消息是:你不需要想清楚才開始,你只需要開始得夠小。 起手式:五件事講清楚,其他都不用 挑好那件小事之後,交代它的時候把這五件事講清楚。這不是我發明的,是把官方 best practices 濃縮成非工程師版本: ① 目標講清楚:你要什麼、給誰用、拿去做什麼。「幫我整理逐字稿」不如「整理成 SOAP 格式,這是要放進病歷系統的」。 ② 只補它不知道的:你們科的慣例、單位的格式、只有你知道的眉角。模型已經會的不用教:SOAP 是什麼不用解釋,你們科的 SOAP 長什麼樣才要講。每一句廢話都在稀釋它的注意力(原因寫在第二篇「為什麼它會越聊越笨」那節)。 ③ 界線先講:哪些檔案不准動、哪些事要先問過你。而且真正的紅線不要只用嘴巴講,第二篇的三層機制(hooks / permissions / CLAUDE.md)就是拿來放這個的。 ④ 訂「怎樣算做完」:這條是官方排第一優先的建議,也是我覺得投資報酬率最高的一條。給它一個它能自己跑的檢查: ❌「幫我整理這些逐字稿」 ✅「整理完自己檢查一遍:每一份都要有四段、每段都要有內容,缺的標出來給我」 ⑤ 先跑一個爛版本:不滿意再一句話改。迭代永遠比一次寫滿快。 就這樣。不用畫流程圖、不用寫規格書。 流程怎麼長大:重複第三次,就升一級 真正的重點來了。你的「流程」不是某天坐下來設計的,它是照一個很簡單的規則長出來的: 同一件事重複到第三次,就往上升一級。 你發現自己在… 升級動作 成本 同一句話講第三次(「回我繁體中文」) 寫進守則檔(AGENTS.md/CLAUDE.md) 一行字 同一套多步驟流程做第三次(先轉檔、再整理、再歸檔) 包成 skill:跟它說「把剛剛這整套存成一個 skill」 一句話 發現某件事絕對不能出錯(改到原始檔、送出病人資料) 交給程式關卡(hook / permissions) 要動手設定,但一勞永逸 三層的差別在第二篇講過了,這裡只補一句:寫在規則裡是建議,做成機制才是保證。 界線越重要,就該住在越下面那層。 這個階梯還有一個隱藏的好處:每一級都是你已經驗證過的東西。你不是在憑空設計一個 skill,你是把一套「已經手動跑成功三次」的流程存起來而已。設計可能會錯,重複不會。 驗收的習慣:這篇最重要的一節 起手式的第④點(訂「怎樣算做完」)值得單獨拉出來講,因為它不是五件事之一而已。它是整套方法裡唯一「做與不做會決定你能走多遠」的習慣。 驗收有三個層次,照順序養成: 層次一:單次驗收。 每個任務交代時就附上檢查方法,讓它做完自己查(「每一份都要有四段、缺的標出來給我」)。這是起手式教的。 層次二:可重跑的驗收。 把檢查存下來,變成隨時可以再按一次的按鈕。差別很大:單次驗收保證「這次做對了」,可重跑的驗收保證「以後改東西也不會弄壞它」。工程師管這個叫回歸測試(regression test),但概念本身跟程式無關:哪怕你的檢查只是「數一數每份紀錄都有四段」,能重跑,就有資格叫驗收。 層次三:驗收先行。 這是官方 best practices 裡明講的工作流:先寫檢查、確認它現在會失敗,再叫 AI 做到通過。聽起來像工程師的儀式,翻成白話就是:開工前先給它看一個「做對了長這樣」的具體例子。它有目標可以自己迭代,你也不會做完才發現彼此想的不一樣。 ...

July 27, 2026 · 1 分鐘 · 187 字 · 陳柏威 Po-Wei Chen
claude-pacer 狀態列示意圖:用量長條、context、模型與三層設計

AI 半夜跑任務跑到一半沒油?我幫它裝了油表和自動煞車

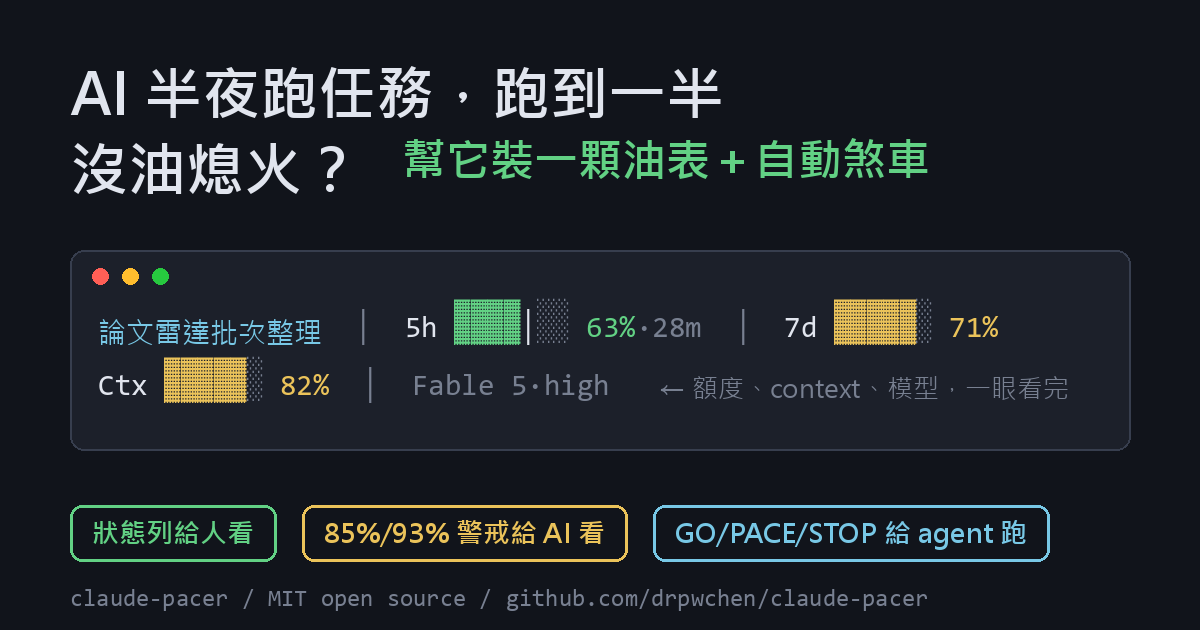
之前分享過幫 AI 裝省錢儀表板,那時候主要在看「花了多少錢」。用到現在,我發現真正會痛的其實不是錢,是額度:Claude Code 的訂閱制有 5 小時和 7 天兩個滾動視窗,用滿就是停給你看。 這篇來分享我們為此做的開源小工具:claude-pacer(github.com/drpwchen/claude-pacer)。 為什麼會想做這個? 起點是好幾次的半夜斷頭。 我很常睡前丟一個長任務給 Claude:批次整理講座逐字稿、跑論文雷達、掃描教科書轉筆記。想說睡醒收成果,結果凌晨兩點撞到 5 小時上限,任務被硬生生停掉,隔天起來看到的是做一半的殘局,還要幫它收拾。 AI 工作起來不知道累,但它完全沒有「額度快用完了,該先存檔」的概念。 另外還有幾個多工時的日常小困擾: 開了四五個視窗,忘記哪個在做什麼:每個終端長得一模一樣,切過去要先滾一下對話才想起來。 不知道還剩多少可以跑:現在派一批 agent 下去,會不會跑到一半全家斷頭? 忘記模型切在哪一個:早上開 Opus 處理難題,下午拿它跑雜事,額度就這樣蒸發了。 市面上不是已經很多狀態列工具了嗎? 對,而且都很好!ccusage、ccstatusline、CCometixLine 都是很成熟的作品,用它們完全沒問題。自動續跑的腳本也找得到,不過它們的做法是盯著畫面等「撞到上限」的訊息出現,再自動幫你按 continue:任務死在哪就斷在哪,檔案改到一半也照斷。 但我想要的多一點:狀態列是做給「人」看的,人半夜在睡覺;真正需要看到警戒的,是還在跑的那個 AI。撞牆之前它的行為就該先改變:85% 起不再開新的大工程,93% 把手上的步驟收乾淨再停,然後自己排好額度恢復後從同一個對話接續。所以 claude-pacer 是三層設計: 第一層:狀態列,給人看 一行看完所有狀態: 對話主題 │ 5h ▓▓▓┃░░ 42%·剩2h13m │ 7d ▓▓▓▓┃▓░ 71% │ Ctx ▓▓░░░░ 34% │ Fable 5·high 對話主題:用 Claude Code 自己生成的 session 標題,多開視窗每個都有名牌。 用量長條上疊一個時間記號 ┃:實心條超過記號,代表你燒得比時鐘快,該收手了;還沒到記號,就可以放心繼續派工。 Ctx:context window 滿度,快被 compact 之前先心裡有數。 模型+推理強度掛在最右邊,忘記切回來之前就會先看到。 寬度是自適應的,終端變窄會自動換緊湊版,手機上看也不會爆版。 第二層:budget-guard,給 AI 看 這層是整個工具的起心動念 ...

July 25, 2026 · 1 分鐘 · 137 字 · 陳柏威 Po-Wei Chen
AI 上手系列①:從零開始用 AI agent — 一行指令裝好、看懂 GitHub、叫 AI 幫你裝、跑出結果四步驟

從零開始用 AI agent:安裝、看懂 GitHub、跑起你的第一個工具

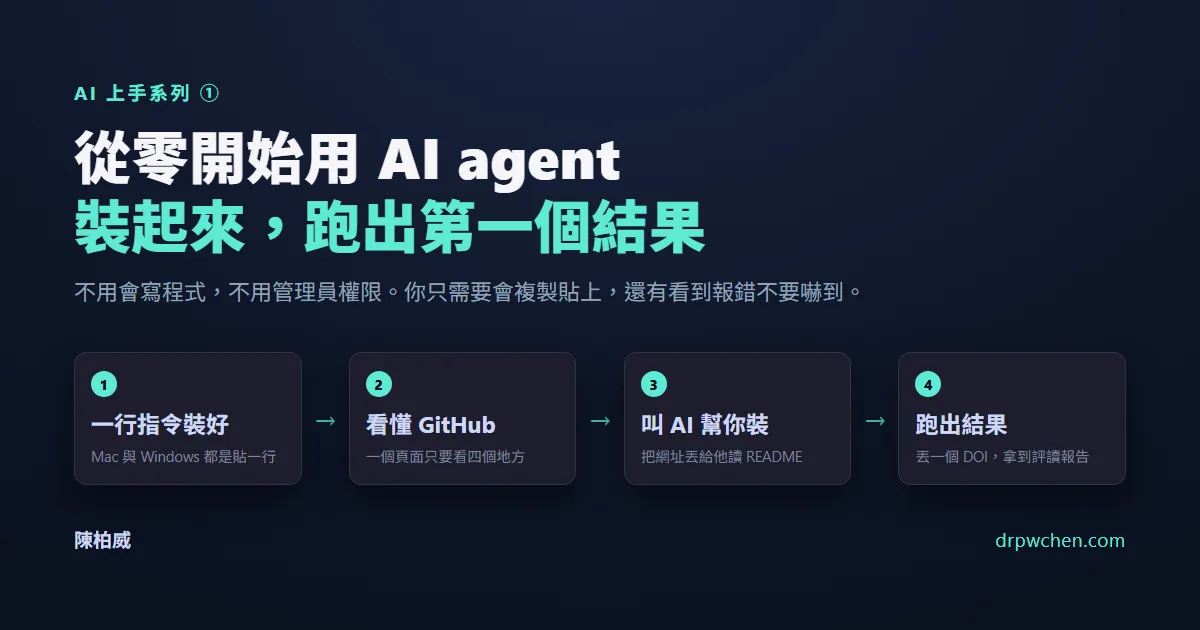
這是一篇會一直更新的文章。 我把自己做的工具都開源放在 GitHub 上,陸續有人跟我說:「東西看起來很厲害,可是我連第一步該幹嘛都不知道。」也有人問我:「GitHub 是什麼?我點進去看到一堆檔案,然後呢?」 所以這篇不是介紹工具,是帶你把第一個跑起來。 已經在用 Claude Code 的朋友,直接跳到 第 4 節。 最後更新:2026-11-12。這次改了三件事:權限的預設已經換成 auto mode、守則檔現在只要一份 AGENTS.md、工具清單補上七月之後開源的幾個。改了什麼、為什麼改,整理在 AI 上手系列,持續更新中。 先花 30 秒確認這篇適不適合你 讀完你會做到的事:在自己的電腦上,丟一個論文的 DOI 給 AI,十幾分鐘後拿到一份有引用查核、有證據等級的評讀報告。或者丟一本 PDF 教科書給他,讓他整理成一篇一篇帶出處的筆記。 你需要準備的: 一台電腦(Mac 或 Windows 都可以,醫院/公司電腦也行,不需要系統管理員權限) Claude 的付費訂閱,Pro 就夠了(約 US$20/月)。免費帳號不支援 Claude Code,這是硬條件。先訂好、在網頁上登入過一次再開始裝:我在課堂上看過有人裝到一半,才發現還沒訂閱 不需要會寫程式。真的。你需要的是「會複製貼上指令」跟「看到紅字錯誤訊息不要嚇到,把它整段貼回去問 AI」這兩件事而已 如果這兩件事你做得到,就繼續往下 👇 — 1. 同一個人,只是工具長大了 先講一段我自己的時間軸,因為我覺得這比任何教學都重要: 三月:第一次把 AI 搬到自己的電腦上,做了語意搜尋、把上課錄影自動轉成筆記。那時候我每做一件事都要手動貼一段「你只能根據我給的資料回答」的咒語,盯著它會不會亂講,每一步都要按確認,煩到快瘋掉 四到五月:慢慢把轉書、抽圖、OCR 磨成一條生產線,開始把重複的事變成一鍵 六月:一邊準備專科考試,一邊架了論文雷達、復健課程雷達,會自動推播新東西給我 七月:門診智慧病歷、額度守門、讓兩個 AI 互相審查對方的產出。開始在「管一群 AI」 八到十一月:開始到醫院各科和學會教 AI 上手課。學員卡住的地方,我都回頭改進這篇;工具也換了幾樣,有的是因為更好的出來了,有的是因為我發現它有問題 中間我沒有變聰明,是工具長大了,加上我學會把每個踩到的坑寫成一條規則。 ...

July 24, 2026 · 4 分鐘 · 841 字 · 陳柏威 Po-Wei Chen
AI 上手系列②:我怎麼跟 AI agent 講話 — hooks/permissions/CLAUDE.md 三層機制強度階梯

我怎麼跟 AI agent 講話:三個心法、四個元技能,還有一份不該一直長大的規則檔

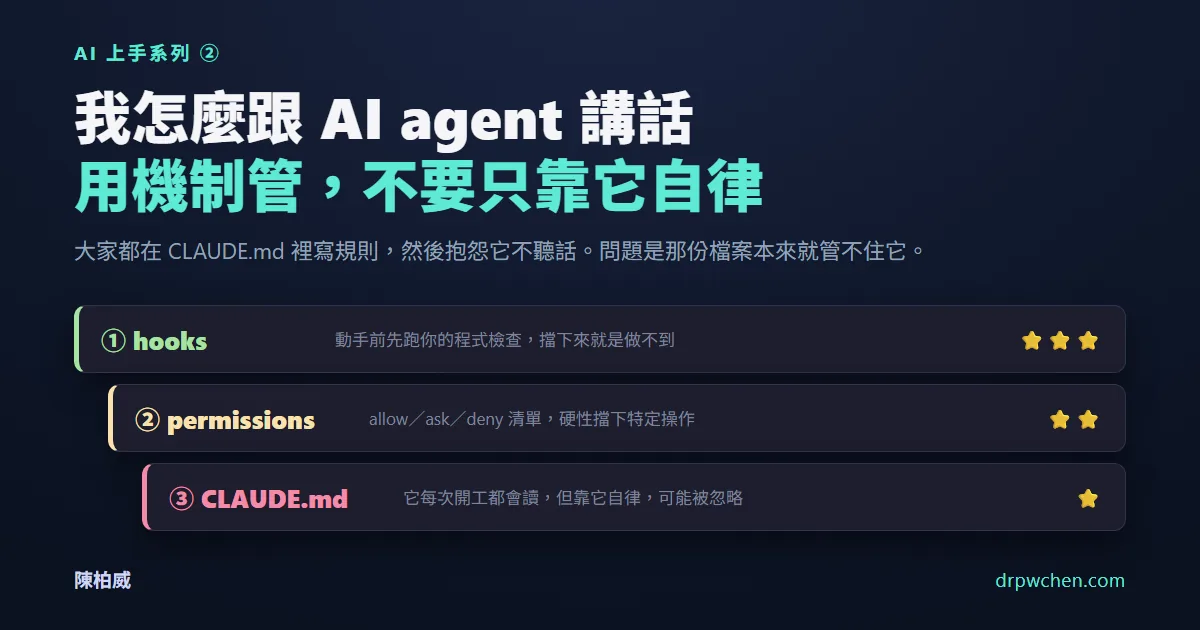
上一篇 《從零開始》 講的是怎麼裝、怎麼跑起來。 這篇講的是用得好,而這跟裝得起來,是完全不同的一件事。 我發現真正決定成效的不是你用哪個模型、不是你會不會寫程式,是你怎麼交代事情、怎麼設關卡。這篇的東西不綁特定工具,你用 ChatGPT 也適用(最後一節會講差在哪)。 三個心法 心法①:它像個很聰明、但記憶有限的新人 它知道很多,但它有一張有限的桌面。塞太多東西就會顧此失彼、會忘記你前面講什麼。 用交班來比喻最好懂:講重點、講清楚,別把整本病歷從頭念一遍。 所以你要主動幫它保持桌面乾淨:一個任務講清楚、講完就 /clear 重開,不要一路累積用不到的東西。 (為什麼會這樣、成本怎麼算,我在 AI Token 經濟學系列 寫了四篇,這裡先講結論。) 心法②:用機制管,不要只靠它自律 這是我覺得最多人做錯的一件事:大家都在 CLAUDE.md 裡寫規則,然後抱怨它不聽話。 問題是,那份檔案在官方的定位裡,是「參考資料」,不是「強制設定」。官方文件講得很白: Claude treats them as context, not enforced configuration. (Claude 把它當成脈絡,不是被強制執行的設定。) 真正能管住它的機制有三層,強度差很多: 層級 是什麼 強度 適合放什麼 ① hooks 在它要動手的那一刻,由你的程式攔下來檢查 ⭐⭐⭐ 程式性強制,模型無法忽略 「這件事絕對不准發生」 ② permissions settings.json 裡的 allow / deny / ask 清單 ⭐⭐ 硬性擋下,但只認工具與指令樣式 「這類操作要先問我 / 永遠不准」 ③ CLAUDE.md 一份它每次開工都會讀的文字說明 ⭐ 靠它自律,可能被忽略 「通常我們這樣做」的慣例與風格 ① hooks:把規矩變成程式 hook 是掛在它生命週期上的一段程式。最常用的是 PreToolUse:它要動手之前先跑你的檢查,你的程式回傳「拒絕」,這個動作就執行不了。 關鍵差別在這裡:被 hook 擋下來的動作,不會回頭讓模型去想替代方案。它不是「勸退」,是「做不到」。 ...

July 24, 2026 · 3 分鐘 · 464 字 · 陳柏威 Po-Wei Chen
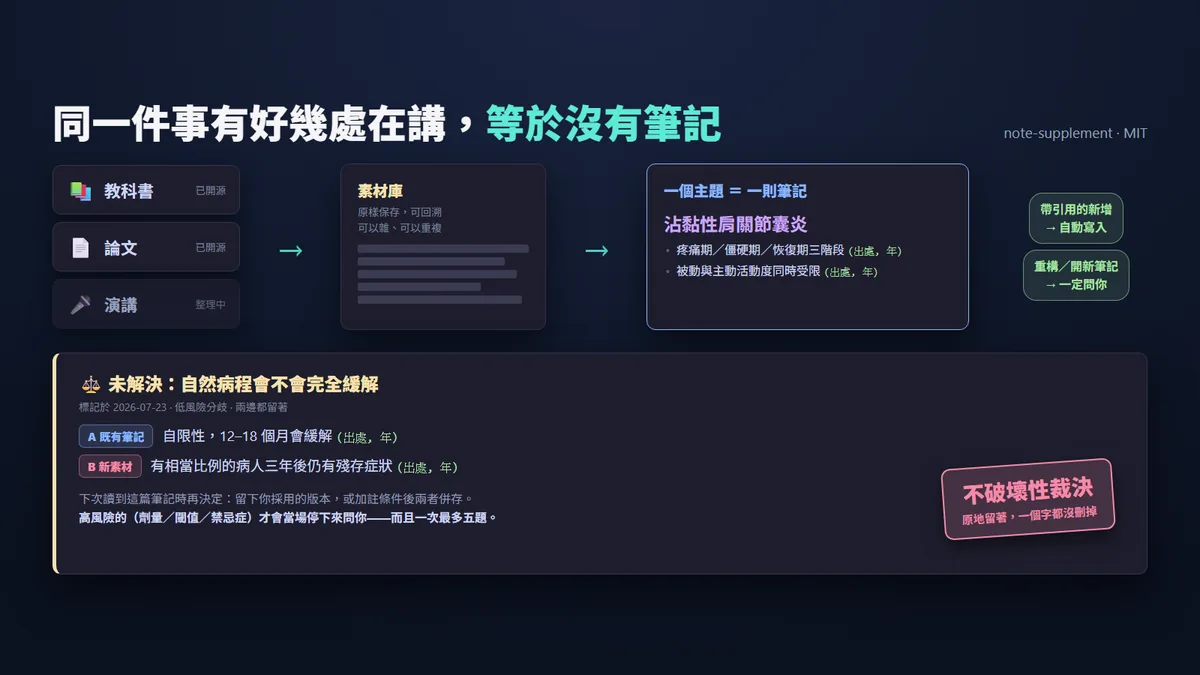
教科書、論文、演講三個來源匯進素材庫,再匯進單一的主題筆記;下方是一個保留新舊兩種說法的衝突區塊

太多筆記,等於沒有筆記:note-supplement 的設計

為什麼「太多筆記」跟「沒有筆記」是同一件事 先講一個我很早就認定、到現在也沒改過的規矩:我的筆記庫裡,一個主題只能有一則筆記。 不是因為潔癖。是因為同一件事如果有五個地方在講,我查東西的時候就得開五個檔案,還要自己判斷哪一版才算數。那個整理的工作沒有消失,只是原封不動地留給了未來的我。 而未來的我通常正在看診、正在趕投影片,沒空做這件事。資訊太多造成的混亂,跟資訊不足是同一種痛苦。 這條規矩在只有一個素材來源的時候很好守。難的是後來,來源越長越多,而且沒有一種會停下來等我: 教科書 → textbook-to-note,把自己的 PDF 教科書轉成有出處、有架構的筆記(repo) 論文 → paper-radar 追蹤、paper-fetch 抓全文、paper-review-and-digest 評讀與內容整理 演講 → 還沒整理好,是目前唯一還沒開源的一支 這些工具解決的都是同一件事:把外面的東西變成看得懂的素材。它們讓素材的產量變高了,但那條「一個主題一則筆記」的規矩沒有因此變好守,反而變難守。 所以整套架構是兩層,界線畫得很硬: 素材庫:外面進來的東西全部丟進去,原樣留著、隨時可以回頭溯源。它可以雜、可以重複、可以互相矛盾,因為它的職責只是「保存證據」。 主題筆記:屬於我自己的部分,一個主題永遠只有一則,放在獨立的資料夾、照同一份模板寫。它是我唯一信任、也唯一會拿去用的那一份。 素材不是筆記 這條界線一旦模糊掉,筆記庫就會退化成一個比較漂亮的下載資料夾。 而把素材的內容併回主題筆記的那個動作,就是這兩層的交界處。這篇要講的 note-supplement,做的就是那一件事。 那也是整條線裡我卡最久的一段。從零寫一份新筆記,AI 做不好你一眼就看得出來:架構亂、沒出處、內容空。但「把新素材補進一份已經存在的筆記」不一樣。我有幾千則筆記,每一則都是過去某個時間點的我認真查證過的結果。 為什麼「幫我更新筆記」這句話這麼危險 直覺做法是把新素材丟給 AI 說「幫我更新這篇筆記」。我吃過幾次虧才想清楚問題出在哪: AI 更新筆記真正的風險,不是它漏掉新內容,而是它會很安靜地改掉你舊筆記裡原本就對的東西。 而且你不會發現,因為輸出看起來仍然是一篇好筆記。 這兩種錯誤的代價完全不對稱: 漏掉新內容:可回復。下次讀到同一份素材、或同一個主題再出現,你還有機會補。 改壞舊內容:不可回復。因為那條內容你已經查證過了,你不會再去查第二次。它從此就以錯誤的樣子留在你的筆記庫裡,還帶著你自己給它的信任。 一旦看清這個不對稱,整個工具的設計就只剩一句話。 設計原則:新增很便宜,改動很昂貴 每一輪,note-supplement 會把素材跟既有筆記對三件事: 哪些是筆記沒有、可以補進去的 哪些是兩邊講得不一樣的 哪些是筆記本來就有、素材沒提到的(這些一律不動) 然後把每一項變更先分類,再決定誰有權限執行。 自動放行的:帶引用的新增 多一條有出處的內容,不會傷害筆記。所以「新增事實 bullet 且帶引用」這類變更直接寫入,記進 changelog。 (有一項後來被我從自動放行拿掉了:把散落的 bullet 收成表格。它看起來只是排版,實際上是把每個事實重新塞進欄位裡,這是改寫不是新增,而且欄位錯位這種壞法無聲無息,產出還比原本更整齊。現在它要問過才做。) 不做「破壞性」裁決的:事實矛盾 這一段是我改最多的地方,也是這個工具第一版最大的設計錯誤。 第一版的規則寫得很硬氣:只要有事實矛盾就送審,不管哪一邊的證據看起來多強,一律不自動裁決。 聽起來很負責。實際跑了一段時間,我發現兩件事: 一、待審清單不是安全機制,是拖延機制。 清單一長,人就會一路按過去,所謂「留給你判斷」,實際效果等於「自動套用,只是多按了幾下」。而且報告每一條後面都有一行「我的建議是⋯」,那行字會定錨,你多半就照著它按了。那不是我在判斷,是它在判斷,只是排版比較客氣。 二、不決定本身就是一種決定。 衝突躺在清單裡的那段期間,筆記裡那條可能已經過時的舊說法,仍然是唯一被寫在那裡、被我信任的版本。「不裁決」的實際效果是「舊的自動贏」,而這個政策我從來沒有主動選過它。 所以 v1.1 換了個立場:不是不裁決,是不破壞。 矛盾先分兩個軸分類: 類型:是同一本書、同一份 guideline 的新版取代舊版(那不是真的爭議)?是兩個各自可信的來源真的講不一樣?還是筆記那條根本沒出處、而素材那條有? 風險:這個值弄錯了會怎樣。劑量、閾值、禁忌症、紅旗徵象算高風險;盛行率、命名沿革、背景知識算低風險。這個軸是一個可以調的旋鈕,不同領域刻度不一樣,醫學筆記只是刻度最嚴的那一端。 然後照分類路由:新版取代舊版直接更新,但舊的值用刪除線原地留著、附上原本的出處和日期,一個字都沒有消失;低風險的分歧,直接在筆記裡就地寫成一個區塊: ...

July 23, 2026 · 2 分鐘 · 237 字 · 陳柏威 Po-Wei Chen
我的 AI 工具箱總整理:依需求分類的工具清單

我的 AI 工具箱總整理:想做什麼,就從這張清單找工具

2026-11 更新:拿掉了已經沒在用的筆記同步與早晨簡報、補上七月之後開源的工具、Codex 的分工改了。完整對照在這篇。 只想找我自己寫的工具? 這篇是我在用的所有工具(大多是別人做的)。我自己寫、開源的工具,依用途分組整理在工具頁,可以打關鍵字篩選。 最近在準備給治療師夥伴的 AI 上手講座,想說來個進階清單,把我平常用的工具、寫過的程式都列出來,這樣想做某件事的時候,可以快速對照「這個功能該找誰」。這也是我自己一直想整理的東西,趁這次一次寫完整。 這篇不挑受眾、不做刪減,從 AI 助手到家裡的備份系統全部列出來~用法是先找到你的需求分類,再看那一節的表。標 ⭐ 的是我自己寫、已經開源的程式,歡迎直接拿去用;標「免費」的都是我實際在免費額度內用的。(太愛免費了,全部幾乎都沒付錢 XD) 目錄 一、AI 主力與引擎 — AI 助手與協作主力・免費雲端與本機 AI 引擎 二、聲音與文件處理 — 語音轉文字・文字轉語音・OCR 三、學習與知識管理 — 筆記與個人知識庫・臨床資料去識別化・論文與臨床實證・考題練習 四、對外發布:網站與信箱 — 架網站與 Cloudflare・網域信箱與寄信 五、自動化與自架後盾 — 自動化排程與通知・家庭伺服器與智慧家庭・備份與不斷電 怎麼開始? 一、AI 主力與引擎 AI 助手與協作主力 工具 做什麼 免費? Claude Code 能讀寫檔案、執行程式、把事情「做完」的 AI 代理,我所有工作流的中心 訂閱制 claude.ai 網頁版,卡關時換乾淨對話問、手機臨時查 有免費層 Claude API 讓自己寫的程式直接呼叫 Claude,適合單次、不用動檔案的粗活(分類、篩選、翻譯) Max 方案每月附 $100 額度,超過按量計費 Gemini 查資料廣度強、原生吃 PDF 和圖片,當第二意見;訂閱 Google AI Pro 另外附 Colab 運算點數,我拿來跑開放權重的影片模型 有免費層 OpenAI Codex 我的審稿人:Claude 做完的東西給它挑毛病、給第二意見,不讓它動手實作 ChatGPT 免費帳號可用 herdr 多工終端管理器,讓好幾個 AI 任務同時在背景長跑、隨時切換 ✅ ⭐ claude-pacer Claude Code 的用量油表+自動煞車:狀態列顯示額度,快撞上限時先收尾、額度重置後自動續跑 ✅ 開源 ⭐ codex-pacer 同一套油表給 Codex 用:狀態列看額度、快用完先煞車 ✅ 開源 Claude Code 是這份清單裡少數我付錢、而且付得心甘情願的東西。它不只是聊天,這個部落格、下面所有我寫的工具,幾乎都是我跟他一起完成的。其他 AI 我當第二意見用:Gemini 查資料、Codex 挑毛病。兩家各看一次,抓到的錯不太一樣。要注意 Gemini 免費層的資料會被拿去訓練,敏感內容不要餵;Codex 記得先到設定把訓練關掉。 ...

July 20, 2026 · 4 分鐘 · 704 字 · 陳柏威 Po-Wei Chen
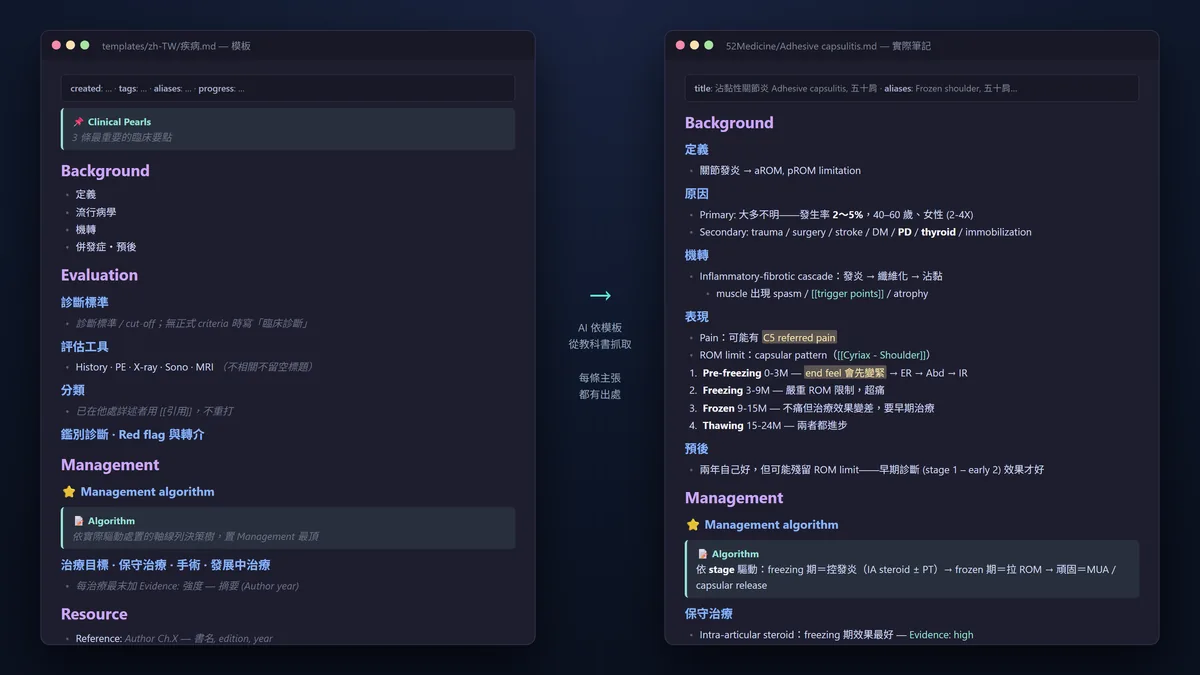
左邊是筆記模板,右邊是這套系統依模板產出的實際筆記,每條主張都標了出處

跨教科書 自動筆記生產流程:專科考試下的產物

緣起 我從醫學生時代就很愛做筆記,這些年累積了幾千份醫學筆記。但老實說,在資訊取得這麼容易、要學的東西又這麼多的現在,已經很難再把每一份筆記都按照自己的架構做到相同品質了。 另一方面,在現代資訊越來越多的時代,能信任的高品質來源反而變得珍貴,這時教科書就是很好的資訊來源。不過復健科專科考試指定參考書就有四十多本,同個概念可能散在好幾本書的不同章節裡。要真的把它們都念過,幾乎是不可能的事。 很幸運這年代有了 AI,這類大型語言模型 (LLM) 擅長處理的就是這樣的長上下文處理,可是一次丟給他幾百本教科書也不切實際。這時就搭配好的內容搜尋與資料庫管理,並且把我做筆記的流程講清楚、調教給 AI,能夠避免幻覺下,確保AI有根據、有架構地產出筆記,我只要用心把整理好的高密度資料吸收進腦袋就好。 於是這變成了一個大型的教科書 LLM Wiki 專案:把書本轉成 AI 容易讀取的格式、精準找到目標章節、按照我的架構整理呈現、從教科書把重要圖片抓進筆記,最後還能跟既有筆記整合。 今天把它開源了,這篇來講講中間過了哪幾關。 第一關:把書轉成 AI 適合讀的格式 直接把 PDF 丟給大模型有幾個坑:又慢又貴(上千頁的書逐頁讀,token 開銷很可觀);掃描頁和字型編碼壞掉的頁面,他會若無其事地跳過,你不會發現筆記裡少了東西;圖片則是直接消失。 我的解法是把重活全部留在本機:文字抽取用 PyMuPDF,每頁約 0.13 秒、0 token。掃描頁走本地 OCR 階梯(Surya → PaddleOCR-VL → 本地視覺模型),真的都失敗才輪到大模型親自看。比較特別的是兩個細節: 靜默失敗偵測:用字型風險、字元密度等規則,抓出「看起來有抽到字、其實是亂碼」的頁面 雙欄排序:教科書常是雙欄排版,直接抽會把左右欄句子交錯在一起,而且亂碼偵測抓不到這種錯。我們做了欄位偵測,確保閱讀順序正確 第二關:把書切成可搜尋的單位 書轉好了,AI 要怎麼找到內容?傳統的目錄(index)不夠用,因為一個主題常散在好幾章;自己上 tag 也不實際,維護不完也切不夠細。答案是語意搜尋(semantic embedding):把內容變成向量,用意思找而不是用關鍵字找。 這裡有個容易被忽略的設計:chunk(切塊)不是無腦固定字數。切太小會失去脈絡,切太大會稀釋語意。我們選擇照標題結構切塊,並保留每塊的上層章節脈絡,讓搜尋結果撈回來的每一塊都是有頭有尾的完整概念。 第三關:在幾十本書裡找到對的那本 跨書搜尋的底層,就是我之前開源的 vault-search 那套方法(那篇的介紹在這裡),本地 LanceDB 加 bge-m3 embeddings,資料不出自己電腦。 在這之上我們還加了一層:重點書目加權。考試指定用書、學會官方教科書,搜尋時分數會被調高,另外也有依出版年份的新舊加權。同一個主題,AI 會優先引用你最信任的來源。 第四關:建立寫筆記的 algorithm 與原則 工具都有了,真正決定筆記品質的是流程設計: 先盲寫:AI 先不看我的既有筆記,獨立從教科書查完完整資料寫草稿,最後才合併。這是為了避免被舊筆記的結構和內容干擾 Template 是抓取的依據:每種主題有固定模板,這個設計很重要,AI 知道該去書裡找哪些東西,我每次閱讀也知道會有哪些段落,吸收速度快很多。repo 裡直接附上我每天在用的五套模板(中英雙語),可以照著改成自己的 為理解而設計的段落:像是開頭的 Summary、結尾的 management algorithm,這種段落的存在本身就是在協助理解,不只是資料的堆放 沒有引用就不算數:每條主張都標到書名+章節,AI 用自己知識補的內容一律標記為推論 第五關:從書裡抽出圖片 這是整套系統最難的部分,因為每本書的排版邏輯都不一樣。我們的做法是先有一套通用方法(幾何比對:圖說跟最近的圖像互相認領),配上決定論的 audit:留白檢查、文字滲入檢查,規則過了才算過,AI 說了不算,而且全程用省 token 的方式在本機執行。 ...

July 19, 2026 · 1 分鐘 · 160 字 · 陳柏威 Po-Wei Chen