瑞典 Abisko 夜空的綠色極光光幕;左邊寫著:北歐十二天,AI 當我們家的隨行秘書

北歐十二天,AI 當我們家的隨行秘書;回來把旅行 SOP 整理成 AI 也能用的旅行總檔

九月跟家人去瑞典、挪威十二天,這是我第一次整趟旅行都跟 AI agent(Claude)一起做事。不只是排行程,也請他從四個信箱撈出 24 份訂單做成列印包、讀租車和保險合約、每天晚上陪我們排隔天、做了 48 段開車時聽的語音導覽;回程遇到曼谷淹水,連理賠都整理成一頁照著做的步驟。 這篇分兩部分:前半照時間順序分享這趟實際發生的事,哪些他做得好、哪些做不好;後半是回來後,我怎麼把十幾年的旅行筆記整理成一份 AI 也能用的旅行總檔,以及整理成別人也能用的公開版。 第一部分:北歐十二天,AI 當我們家的隨行秘書 六個人,六種旅行習慣 我們一家六個人,先飛到北極圈邊的 Kiruna,租一台九人座從瑞典開進挪威,一路到羅弗敦群島,最後回斯德哥爾摩住幾天。 六個人一起出國,難的常常不是景點,是大家的節奏不一樣: 體力:同一座山、同樣騎單車,每個人的速度不同。 廁所:開車一兩個小時沒有廁所,對有些人是大事。 飲食習慣:有人吃奶蛋素,有人不吃五辛,有人想多吃當地菜。 旅遊節奏:每天早上出門的準備時間大家不同。 當人數增加時,規劃的複雜度也增加,需要考量的事情變多。以前全部要自己來,這次就靠 Claude 幫忙一起完成囉! 出發前:一個全家共用的網站、24 份訂單、一堂飛機上的駕駛課 六個人出國,最怕的是「那個資訊埋沒在以前的 LINE 訊息裡」。所以我們做了一個有密碼的私人網站,全家用手機打開就有。 它不是一次做好的: 七月,只是一頁行程方案:讓長輩看懂我們要去哪。一天一行,加一句為什麼去,比 AI 寫的長文好讀多了。 出發前七週,出發前小考:只考自己要準備的、要注意的、知道了會覺得有趣的,可以重考,還有排行榜😁 前後改了六輪題目,機票轉機這種我處理的事就不考。 出發前幾天,共用行李清單:共用的東西標「誰帶」,誰都可以改。 旅途中,每天在改:第八天首頁大改版,變成「今天與明天」跟著日期自動換,每個點都能一鍵導航。最忙的一天,網站改了 25 次。 另外還有一張地點地圖,在地圖上親手標了 41 個想去的點。 列印包:訂單散在四個 Gmail 帳號裡:機票、六間住宿、租車、腳踏車。我請 Claude 全部找出來,抓成官方英文版 PDF、逐份核對訂單編號,做成一頁「一鍵列印全部」,共 24 份。當時覺得只是保險,結果最後一晚真的用上了(後面講)。 住宿的「自己清潔、自備床單」:瑞典、挪威的住宿常常要自己打掃、自己帶床單毛巾,訂房頁面又常常沒寫清楚。他逐間看訂房頁面和確認信,整理出哪間要自己清、哪間清潔費已經付了、哪幾間根本沒寫。沒寫清楚的,他起草英文訊息,我自己貼到訂房網站的聊天室送出。 飛機上沒網路的駕駛課:出發前發現北歐自駕的規則我們還沒準備好(速限牌、單線道會車、路上的馴鹿麋鹿、全自動過路費)。叫他做一個互動式的「北歐自駕速成」網站,路標一張一張解釋,加上 30 題隨堂測驗,再加上一鍵下載打包放進 iPad,在長途飛機上沒網路也能看。 第三天:我的國際駕照過期了 先分享一件蠢事:我忘了國際駕照會過期,到了現場才發現臨時不能當主要駕駛,只好換人。後來整趟 1,021 公里,都是太太一個人開完的。 換了之後,我請 Claude 把租車公司的租約,跟我另外在 RentalCover 買的租車保險合約拿來比對,這種又長又複雜的合約,最適合丟給他讀。他發現租約上登記的駕駛,跟租車保險上的被保險人不是同一個人,提醒我真的出事要理賠時,這種對不上可能會卡住。 Claude 用我的瀏覽器改了帳戶資料、填好客服表單,我說可以之後才由他送出,後續要確認的信也是他幫忙寫。但最後照合約還是無法轉換。AI 可以幫忙找出該確認的地方,算不算數還是保險公司說了算,還好平安回來。 旅途中:每天晚上排隔天 到北極圈的第二天晚上,我們看到極光了🤩 這是讓他自己盯著的事:每天傍晚自動抓極光指數和雲量,判斷今晚有沒有機會,推一則通知到手機。 這趟最常做的事,是每天晚上跟 Claude 一起排隔天的行程,有個人可以使喚去查東查西很快樂~ 固定的流程是:先看前幾天我們實際花了多少時間,再看隔天逐小時的天氣,最後才排時間軸。 ...
October 11, 2026 · 2 分鐘 · 374 字 · 陳柏威 Po-Wei Chen
一隻友善的機器人看著有預算錶針的儀表板,指針在節奏正常區,token 金幣流進小豬撲滿

我幫 AI 裝了一個省錢儀表板

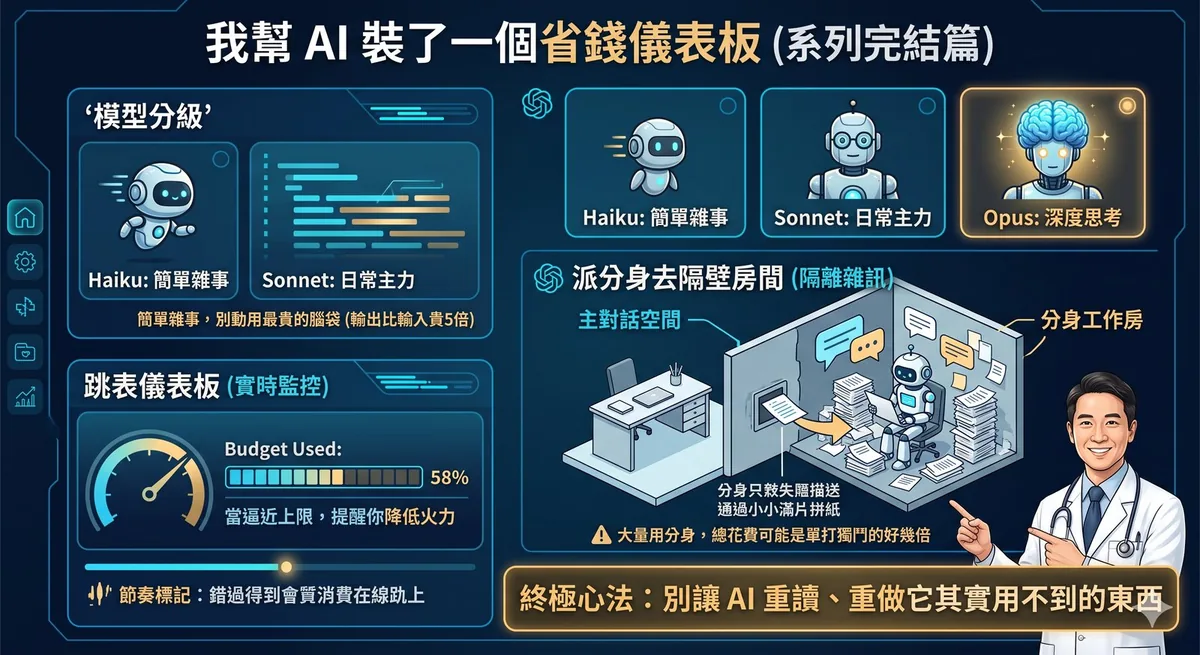
📖 省 Token 系列(共四篇):第一篇 為什麼你的 AI 越聊越笨 · 第二篇 能用算盤就別開超級電腦 · 第三篇 幫 AI 整理一張乾淨的工作桌 · 第四篇(本篇,完結) 來到系列最後一篇。前三篇我們從「為什麼 AI 越聊越笨」,一路講到「什麼時候別用 AI」「怎麼幫它整理桌面」。這一篇談的是錢真正花下去的那一刻:怎麼把每一塊錢花在刀口上。 第一件事:不是每件事都需要最聰明的腦袋(但省下來,就是為了負擔得起好的) AI 模型有分等級。以 Claude 為例,由便宜到貴大致是 Haiku、Sonnet、Opus 三級,價差很大。 如果你是按使用量付費的人,最直接的省法就是「派對的等級做對的事」:改格式、重新命名、簡單分類這種雜事,交給最便宜的 Haiku 就好;日常的寫作、查資料用中間的 Sonnet;只有真正需要深度推理的硬任務,才動用最強的 Opus。 這裡還有一個很多人都搞錯的觀念,特別講一下:「要看圖」不等於「要用最貴的模型」。 當你只是要 AI「看一張圖、認出裡面有什麼、把上面的字讀出來」這種辨識任務,最便宜的 Haiku 通常就完全夠用,便宜到一個誇張。只有要它「看懂一張複雜的醫學示意圖、解讀圖表背後的邏輯」這種需要推理的視覺任務,才值得升級。選模型的真正標準,是「這個任務需要多少思考」,不是「要不要看圖」。 不過老實說,我自己現在反而大多直接用最強的 Opus,XD。 為什麼?因為我發現,在目前的訂閱方案下,把前面三篇那些省 token 的功夫都做好之後,我的額度其實用不太完,而最強的模型品質又明顯比較好。所以對我來說,與其斤斤計較每件事該用哪一級,不如把省下來的額度,拿去讓最好的模型做每一件事。 我覺得這反而是整個系列最想講的一件事:省 token 從來不是為了小氣。 我把浪費擋掉、把該交給程式的交給程式、把桌面整理乾淨,省下來的這些,剛好讓我負擔得起「把最好的腦袋,用在每一個我在乎的問題上」。省,是為了能大方地花在刀口上。 最後補兩個進階的小心法: 讓 AI 少廢話,可以一勞永逸。 AI 的「輸出」比「輸入」貴上好幾倍(以 Opus 為例差到五倍),所以請它回答精簡就是直接省錢。而且這件事你不用每次重講,直接寫進給它的長期指令裡(就是第三篇那份常駐設定檔,或聊天版的「自訂指令」),叫它預設就講重點、不要長篇大論。一次設定,之後每次都省。 思考深度也能調。 同一個模型可以設定它「想多深」,簡單的事用淺一點、難的事才開深度思考。重點永遠是:把力氣花在真正難的地方。 第二件事:把吵鬧的雜事,丟到隔壁房間做 有些工作會吐出一大堆過程訊息:跑一輪測試、抓一份長文件、處理一堆紀錄。如果讓這些雜訊全部堆在主對話裡,桌面馬上被淹沒(回到第三篇,桌面一髒就又貴又笨)。 我的做法是派一個「分身」去隔壁房間做這件事。分身有自己獨立的工作空間,它的所有過程、雜訊、草稿都留在那個房間裡,只有最後的結論回到我的主對話。 這就像你請助理去查一整天資料,你不需要看他翻過的每一頁,只要他最後給你一頁重點。 注意 但這招有取捨,我必須老實說:派分身本身也要花錢,而且分身會自己燒一輪 token。官方就提醒過,大量用分身的工作流,總花費可能是單打獨鬥的好幾倍。所以原則是:當「保持主桌面乾淨」的價值,大於「多請一個分身」的成本時,才派。 不是什麼都丟分身。 (這篇從頭到尾,你會發現省 token 沒有一招是無腦的,每一招都在權衡。這正是它好玩的地方。) 第三件事:裝一個會對我跳表的儀表板 講了這麼多省法,最後一塊拼圖是:你得看得見自己花了多少。 看不見的支出最危險。所以我裝了一個開源小工具,叫 cc-budget(由 boyand 開發,在 GitHub 上找得到)。 ...

June 29, 2026 · 1 分鐘 · 168 字 · 陳柏威 Po-Wei Chen
計程車跳表上扛著被 token 金幣壓垮、下沉的對話泡泡,一隻友善的機器人吃力地拖著它

為什麼你的 AI 越聊越慢、越聊越笨?

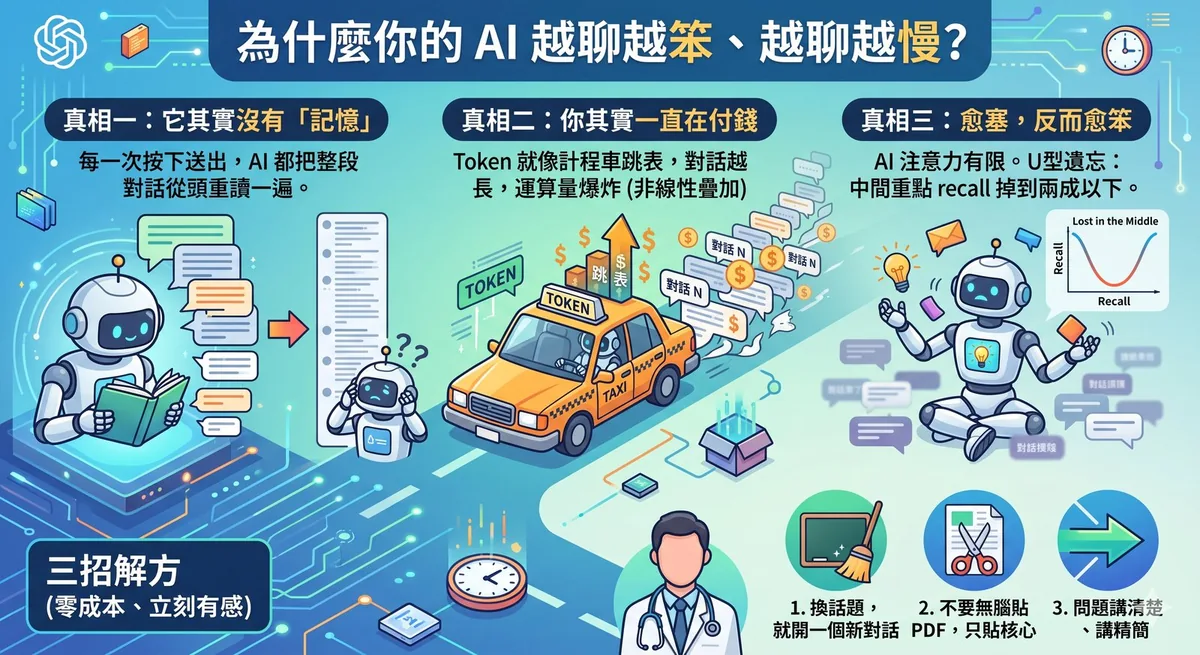
📖 省 Token 系列(共四篇):第一篇(本篇)· 第二篇 能用算盤就別開超級電腦 · 第三篇 幫 AI 整理一張乾淨的工作桌 · 第四篇 我幫 AI 裝了一個省錢儀表板 你一定有過這種經驗:跟 ChatGPT 或 Claude 聊一個下午,越到後面它越遲鈍,回得越慢,還會突然「忘記」你前面講過的事,甚至開始鬼打牆。 很多人以為是自己網路慢,或是 AI 當機。其實不是。這背後有一個大多數人不知道、但知道之後會立刻改變你用法的真相。 真相一:AI 其實沒有「記憶」 我們直覺以為,AI 像人一樣,聊著聊著就「記住」了對話。 它沒有。 每一次你按下送出,AI 都把你們從第一句到現在的整段對話,從頭重讀一遍,然後才回你下一句。它不是接著上一句講,而是每次都把整本對話重新看過。 所以你可以想像:對話越長,它每回答一句之前要重讀的東西就越多。這就是為什麼越聊越慢。 真相二:你其實一直在付錢,只是看不到帳單 AI 處理文字的單位叫 token(大致是一個字或半個詞)。你輸入的每個 token、它輸出的每個 token,背後都在計費。 最好記的比喻是:token 就是 AI 的計程車跳表。 距離(字數)越長,車資越高。 你在訂閱制的 App 裡看不到這張帳單,但它換了一張臉出現在你面前:就是那個「你今天的訊息額度已用完」,還有「怎麼越來越慢」。額度和卡頓的背後,都是 token 的運算量。 而且這筆帳不是線性疊加的。對話長度加倍,你付的運算量不是兩倍,而是接近四倍(這是 AI 內部運算機制的數學特性)。難怪長對話的卡頓感像在爆炸。 真相三:越塞,反而越笨 這點最反直覺,但最有用。 AI 的「注意力」是有限的,所有注意力加起來永遠等於一份。你塞進去的內容越多,每個重點分到的注意力就被稀釋得越薄。多餘的廢話會偷走本該分給關鍵問題的專注力。 這不是我隨口說的。一篇很有名的研究 Lost in the Middle(Liu et al., 2024)發現一個 U 型曲線:資訊放在對話的開頭或結尾,AI 記得最牢;但埋在中間的重點,記得的機率會掉到只剩大約兩成。難怪它常常把你中間講的事忘光光。 另一份 Chroma 在 2025 年的研究測了 18 個主流模型,發現它們全部都隨著輸入變長而表現下滑,這現象被叫做 context rot(脈絡腐化)。 ...

June 29, 2026 · 1 分鐘 · 173 字 · 陳柏威 Po-Wei Chen