AI 上手系列②:我怎麼跟 AI agent 講話 — hooks/permissions/CLAUDE.md 三層機制強度階梯

我怎麼跟 AI agent 講話:三個心法、四個元技能,還有一份不該一直長大的規則檔

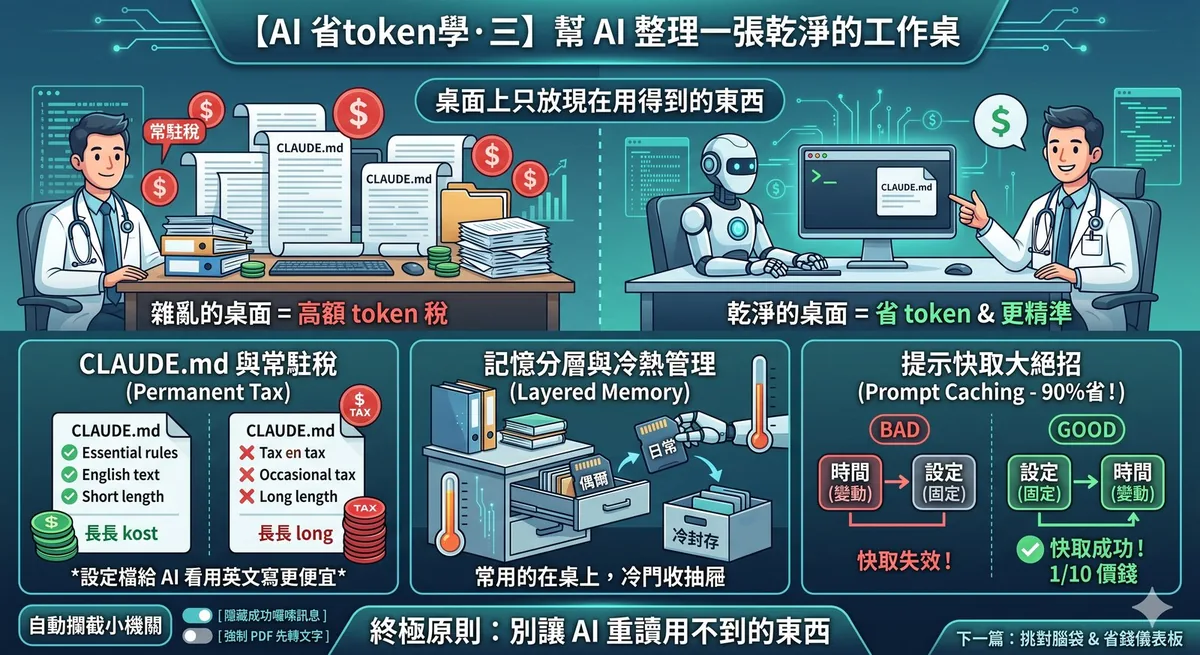
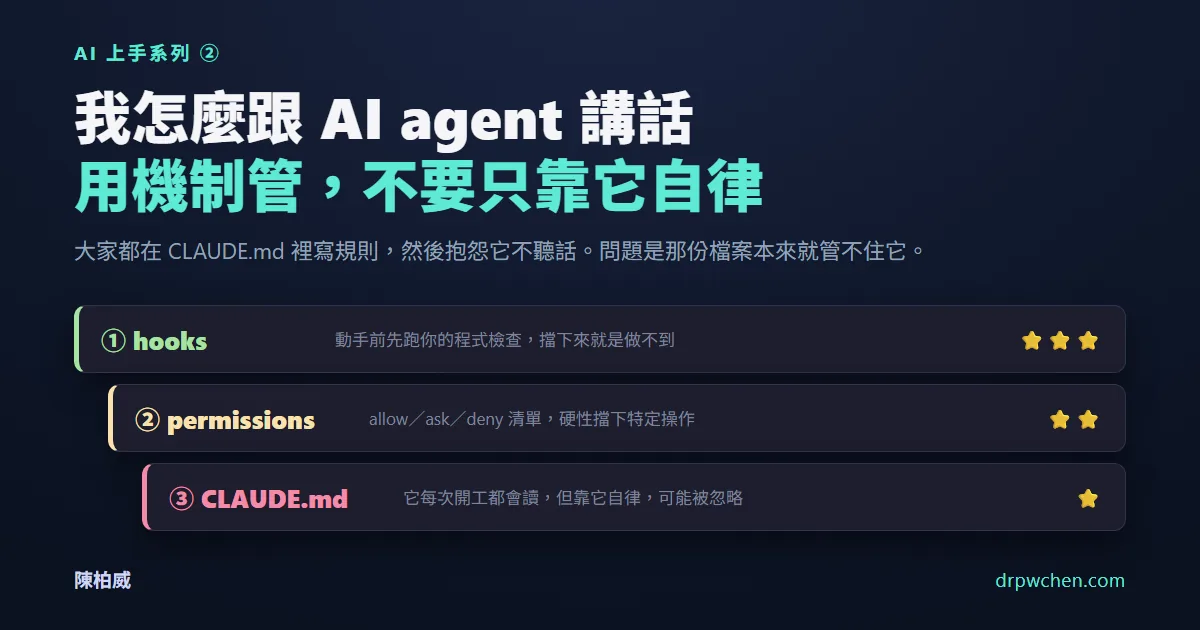
上一篇 《從零開始》 講的是怎麼裝、怎麼跑起來。 這篇講的是用得好,而這跟裝得起來,是完全不同的一件事。 我發現真正決定成效的不是你用哪個模型、不是你會不會寫程式,是你怎麼交代事情、怎麼設關卡。這篇的東西不綁特定工具,你用 ChatGPT 也適用(最後一節會講差在哪)。 三個心法 心法①:它像個很聰明、但記憶有限的新人 它知道很多,但它有一張有限的桌面。塞太多東西就會顧此失彼、會忘記你前面講什麼。 用交班來比喻最好懂:講重點、講清楚,別把整本病歷從頭念一遍。 所以你要主動幫它保持桌面乾淨:一個任務講清楚、講完就 /clear 重開,不要一路累積用不到的東西。 (為什麼會這樣、成本怎麼算,我在 AI Token 經濟學系列 寫了四篇,這裡先講結論。) 心法②:用機制管,不要只靠它自律 這是我覺得最多人做錯的一件事:大家都在 CLAUDE.md 裡寫規則,然後抱怨它不聽話。 問題是,那份檔案在官方的定位裡,是「參考資料」,不是「強制設定」。官方文件講得很白: Claude treats them as context, not enforced configuration. (Claude 把它當成脈絡,不是被強制執行的設定。) 真正能管住它的機制有三層,強度差很多: 層級 是什麼 強度 適合放什麼 ① hooks 在它要動手的那一刻,由你的程式攔下來檢查 ⭐⭐⭐ 程式性強制,模型無法忽略 「這件事絕對不准發生」 ② permissions settings.json 裡的 allow / deny / ask 清單 ⭐⭐ 硬性擋下,但只認工具與指令樣式 「這類操作要先問我 / 永遠不准」 ③ CLAUDE.md 一份它每次開工都會讀的文字說明 ⭐ 靠它自律,可能被忽略 「通常我們這樣做」的慣例與風格 ① hooks:把規矩變成程式 hook 是掛在它生命週期上的一段程式。最常用的是 PreToolUse:它要動手之前先跑你的檢查,你的程式回傳「拒絕」,這個動作就執行不了。 關鍵差別在這裡:被 hook 擋下來的動作,不會回頭讓模型去想替代方案。它不是「勸退」,是「做不到」。 ...
July 24, 2026 · 3 分鐘 · 440 字 · 陳柏威 Po-Wei Chen
我的 AI 工具箱總整理:依需求分類的工具清單

我的 AI 工具箱總整理:想做什麼,就從這張清單找工具

最近在準備給治療師夥伴的 AI 上手講座,想說來個進階清單,把我平常用的工具、寫過的程式都列出來,這樣想做某件事的時候,可以快速對照「這個功能該找誰」。這也是我自己一直想整理的東西,趁這次一次寫完整。 這篇不挑受眾、不做刪減,從 AI 助手到家裡的備份系統全部列出來~用法是先找到你的需求分類,再看那一節的表。標 ⭐ 的是我自己寫、已經開源的程式,歡迎直接拿去用;標「免費」的都是我實際在免費額度內用的。(太愛免費了,全部幾乎都沒付錢 XD) 目錄 一、AI 主力與引擎 — AI 助手與協作主力・免費雲端與本機 AI 引擎 二、聲音與文件處理 — 語音轉文字・文字轉語音・OCR 三、學習與知識管理 — 筆記與個人知識庫・臨床資料去識別化・論文與臨床實證・考題練習 四、對外發布:網站與信箱 — 架網站與 Cloudflare・網域信箱與寄信 五、自動化與自架後盾 — 自動化排程與通知・家庭伺服器與智慧家庭・備份與不斷電 怎麼開始? 一、AI 主力與引擎 AI 助手與協作主力 工具 做什麼 免費? Claude Code 能讀寫檔案、執行程式、把事情「做完」的 AI 代理,我所有工作流的中心 訂閱制 claude.ai 網頁版,卡關時換乾淨對話問、手機臨時查 有免費層 Gemini 查資料廣度強、原生吃 PDF 和圖片,當第二意見 有免費層 OpenAI Codex 程式卡關找不同解法、對抗式 code review ChatGPT 免費帳號可用 herdr 多工終端管理器,讓好幾個 AI 任務同時在背景長跑、隨時切換 ✅ ⭐ claude-pacer Claude Code 的用量油表+自動煞車:狀態列顯示額度,快撞上限時先收尾、額度重置後自動續跑 ✅ 開源 Claude Code 是這份清單裡少數我付錢、而且付得心甘情願的東西。它不只是聊天,這個部落格、下面所有我寫的工具,幾乎都是我跟他一起完成的。其他 AI 我當第二意見用:Gemini 查資料、Codex 挑毛病。要注意 Gemini 免費層的資料會被拿去訓練,敏感內容不要餵;Codex 記得先到設定把訓練關掉。 ...

July 20, 2026 · 3 分鐘 · 583 字 · 陳柏威 Po-Wei Chen
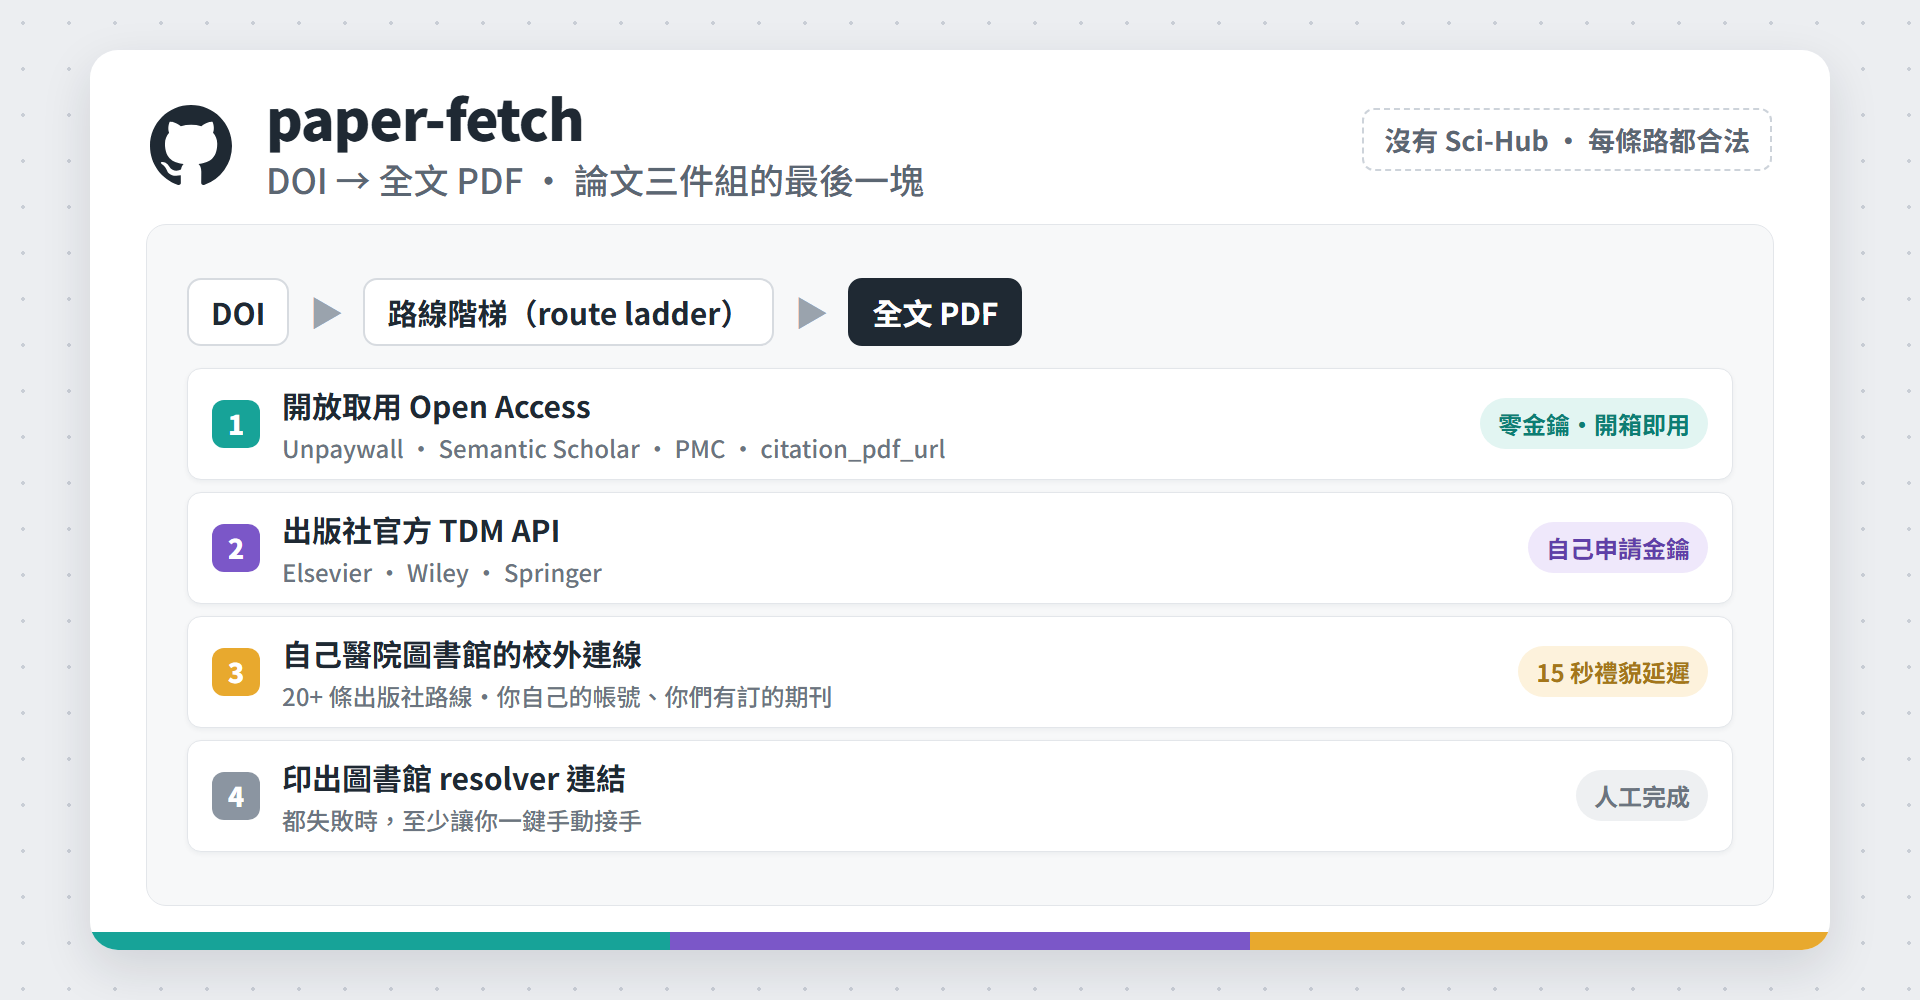
paper-fetch 的 GitHub 風格封面卡,畫出四層路線階梯:開放取用、出版社官方 TDM API、自己醫院圖書館的校外連線、印出圖書館 resolver 連結

論文三件組的最後一塊:paper-fetch,給它一個 DOI,它自己去把全文抓下來

前陣子分享的論文評讀工具(讓 Claude 幫忙做品質評讀跟內容整理),有朋友回我一句很實在的話:工具是好用,但每次都得自己先去把 PDF 生出來,最煩的其實是這一步。 真的是這樣。要讓 AI 幫你讀論文,你得先拿得到全文。而拿全文這件事,卡住的通常不是 AI,是權限、是出版社、是圖書館。 所以論文三件組裡最後一塊、也是最痛的一塊,今天終於補上了:paper-fetch(MIT 開源)。給它一個 DOI,它會自己走完整條路,把全文 PDF 抓下來。 階段 工具 做什麼 發現 論文學習雷達 paper-radar RSS/PubMed 餵新論文,依興趣排序 下載 paper-fetch DOI → 全文 PDF 評讀 paper-review-and-digest 品質評讀、內容整理 — 它怎麼運作?一道由便宜到麻煩的階梯 整個設計只有一句話:先走最便宜、最正當的路,失敗才往下掉。 第一層:開放取用(open access) Unpaywall、Semantic Scholar、PMC/Europe PMC,還有藏在文章網頁裡的 citation_pdf_url meta tag(那正是 Google Scholar 拿來索引 PDF 的東西)。這層零金鑰、開箱即用,你只要在設定檔填自己的 email。沒有圖書館資源的人,能接的來源我都接上去了。 第二層:出版社官方的文字探勘 API(text-mining API) Elsevier、Wiley、Springer 都有正式開放給文字探勘用的 API,自己去申請一把金鑰就好,是完全被允許的管道。這層跟盜版一點關係都沒有,只是大家很少知道它存在。 第三層:自己醫院圖書館的校外連線 用你自己的帳號登入,抓你們醫院本來就有訂的期刊。它只是把你原本會手動做的那一串點擊自動化,不是繞過付費牆。 第四層:投降,但投降得有用 全部失敗的話,它會把圖書館的 SFX/OpenURL 連結印出來讓你手動去點,而不是丟一個 error 就沒了。 沒有 Sci-Hub,沒有盜版路線。 每一層都是你本來就有資格走的路。 — 最花時間的是什麼?把每一家出版社的脾氣摸清楚 這是我覺得整個專案最值得分享的部分。DOI 換 PDF 聽起來像一行程式,實際上每家出版社的做法都不一樣,而且沒有文件可以查,只能一篇一篇撞出來。目前摸清楚、而且用真實文章驗證過的有 20 幾條路線,收斂成四種形狀。 ...

July 14, 2026 · 2 分鐘 · 225 字 · 陳柏威 Po-Wei Chen
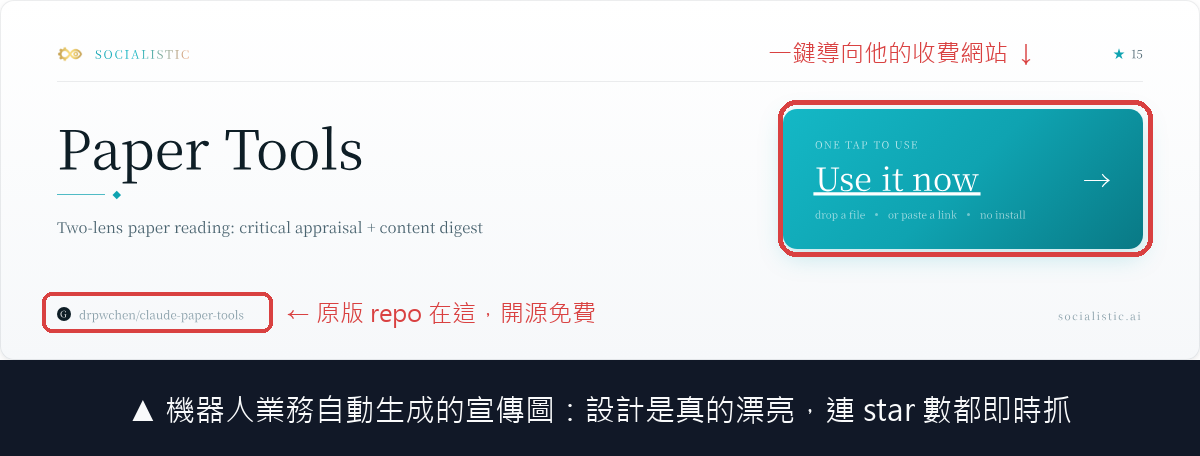
機器人自動生成的 Paper Tools 宣傳圖,紅框標註導向收費網站的按鈕與原版開源 repo 位置

我的開源工具,被機器人業務盯上了!

前面分享的論文工具 paper-review-and-digest,開源上線沒幾天,就收到了第一個 GitHub issue!第一次收到 issue 其實蠻開心的,點開一看更驚訝:對方不只讀了我的 code,還精準講出設計裡我最得意的部分。 他說他欣賞「模型與確定性檢查的硬切分」:grade_judge.py 不信任模型自己回報的證據等級,而是從降級項重新計算;argdown_lint.py 會抓出「替代指標跳到硬終點」這類論證跳躍。然後說他幫我做了一個線上入口,訪客不用安裝 Claude Code,上傳 PDF 就能跑評讀流程,連宣傳圖都做好了: 哇,有人這麼認真讀我的專案,還幫我做了網頁版和這麼漂亮的圖? 等等,這是真人嗎? 開心之餘總覺得哪裡怪怪的。這網站有免費額度、有點數收費系統,商業模式完整得不像順手之作。想說反正有 Claude,就請他去查查這位熱心網友的底細。 結果一查,反轉來得比想像中快🤣。Claude 列出的證據: 兩分鐘內,這個帳號對 26 個 repo 發了 issue。全部都是論文閱讀工具:arxiv-summarizer、paper_agent、PaperAgent⋯⋯我的排第 13 個。前一天還有另一波,打的是 Claude Skills 類的 repo。 連結裡的追蹤參數直接寫著 campaign 名稱:20260708-paper-reading-comprehension-assistants。這是排程好的行銷批次,不是有感而發。 帳號今年三月才建立,0 followers,卻有 140 個 repo。 GitHub 的搜尋 API 拒絕搜尋這個帳號(user cannot be searched),這通常代表帳號已經被平台標記為 spam。 那段讓我心花怒放的技術讚美,是 LLM 逐一讀每個 repo 自動生成的。爬 repo 餵給模型很便宜,這正是它讀起來「像真人」的原因。 最後一句「Feel free to close this if it isn’t relevant」,是 spam 帳號降低被檢舉率的標準話術。 宣傳圖角落有小字標我的 repo,連 star 數都即時抓,做得很精緻;但點進他網站的頁面,作者欄掛的是他自己的名字。MIT 授權確實允許商用,不過這個掛名方式就有點微妙了。 認真想了一下,這個生意其實跑得起來 罵完之後認真想,這個模式其實蠻厲害的。我實際註冊進去看了帳務頁,整個商業模式就攤在眼前:註冊送 500 點,跑一次論文分析扣 38 點左右,換算大概不到台幣 2 塊。免費額度夠你跑十幾次,嘗到甜頭之後,Stripe、PayPal、微信、支付寶四種儲值管道排排站等你。 ...

July 9, 2026 · 1 分鐘 · 130 字 · 陳柏威 Po-Wei Chen
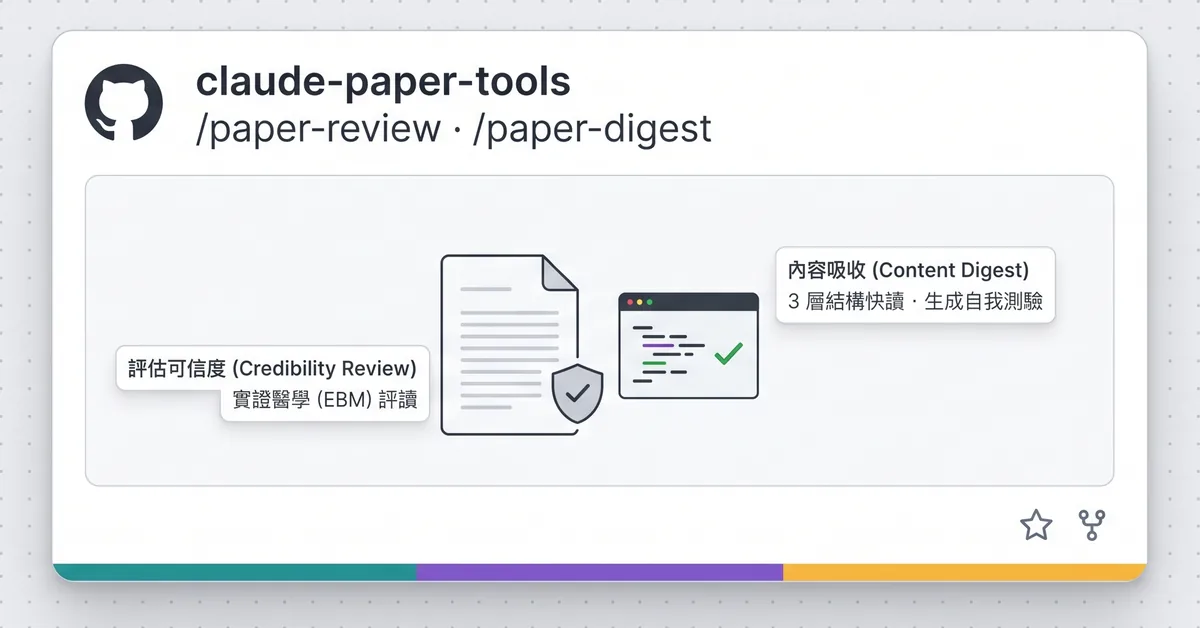
paper-review-and-digest 的 GitHub 風格封面卡,標示兩個 skill:評估可信度的實證醫學評讀,與三層結構快讀、生成自我測驗的內容吸收

我把 journal club 的「讀論文腦」寫成了 AI skill,還逼它不能靠印象唬爛

前面分享的論文學習小站,有個「品質」、「內容」按鈕,那時沒有把背後的實作放出來。算是個有前端網頁,但後端還是要靠自己整理的平台。不過我自己的實作,當然後端還是要接給 AI,減輕認知的負荷,這裡就是把後端兩個 skill 分享出來,加速大家學習速度囉! — 一個負責「這篇可不可信」 第一個叫 paper-review,做的是 journal club 那種評讀。 依研究設計自動選對工具 它會依照論文的類別,選用建議的評讀工具,隨機對照試驗(randomized controlled trial)用 Cochrane RoB 2、觀察性研究用 ROBINS-I、系統性回顧用 AMSTAR-2、診斷準確度用 QUADAS-2,而不是拿一張萬用 checklist 硬套。這件事聽起來理所當然,但你知道大部分「AI 幫你看論文」其實就是一張萬用 checklist 套到底。 引用查核:先確認文獻「真的存在」 我最喜歡的一關是引用查核。它會先去 CrossRef 確認每一篇被引用的文獻「真的存在」,再比對「論文說這篇文獻講了什麼」跟「這篇文獻實際上講了什麼」。 為什麼要先查存不存在?因為 AI 寫出來的引用,沒稽核的話正確率其實只有四到八成,假 DOI、張冠李戴的狀況比想像中多。所以這一步是一個很便宜、但很有用的防呆。 統計顯著不等於臨床顯著 還有一個地方我很堅持:統計顯著不等於臨床顯著。所以它會把效果量拿去跟量表的最小臨床重要差異(minimal clinically important difference, MCID)比,p 值小於 0.05 但根本沒過 MCID,它就會直接講出來。 整體借鏡了林協霆醫師的分享,還有之前學 EBM 的內容,大家也可以再加入你覺得重要的部分。 — 重點:我不讓 AI 靠「印象」給分 這是這次我自己覺得最有意思的部分。 一開始我讓 Claude 自己算證據等級(GRADE)、自己判斷「結論有沒有超過資料能支撐的範圍」。但我後來覺得不對,因為這種東西讓語言模型「憑整體感覺」給一個分數,它其實很會講得頭頭是道,可是你沒辦法檢查它到底怎麼得出來的。 所以我乾脆寫了兩支確定性的小程式,把「判斷」跟「計算」分開: grade_judge.py:把 GRADE 變成算術 語言模型只負責評五個面向(risk of bias、inconsistency、indirectness、imprecision、publication bias),每個面向給「不嚴重/嚴重/很嚴重」。真正的最終等級由程式加總算出來,不是模型自己講。模型自報的等級只當參考,如果跟程式算的不一樣,程式還會跳出來提醒「這兩個對不上,回去重看某個面向」。 它甚至會幫你擋掉 GRADE 的規則錯誤,例如觀察性研究只要有任何一項被降級,就不准再往上升級,這個規則模型很容易記錯,程式不會。 argdown_lint.py:把結論的邏輯漏洞變成可以檢查的東西 這支更好玩。語言模型負責把論文的結論、還有每一個「用來支撐結論的發現」標上類型(這是隨機對照試驗的直接證據?還是只是相關性?還是只是替代指標?還是只是次要 outcome?),然後由程式判斷這個推論跳得合不合法。 例如「用替代指標的改善,去宣稱對真正的臨床終點有效」、「用相關性去宣稱因果」、「用單一研究去宣稱『一致地顯示』」,這些都是論文 spin 最愛躲的地方。程式抓到就直接標紅、回報有漏洞。 ...

July 7, 2026 · 1 分鐘 · 127 字 · 陳柏威 Po-Wei Chen
一隻友善的機器人看著有預算錶針的儀表板,指針在節奏正常區,token 金幣流進小豬撲滿

我幫 AI 裝了一個省錢儀表板

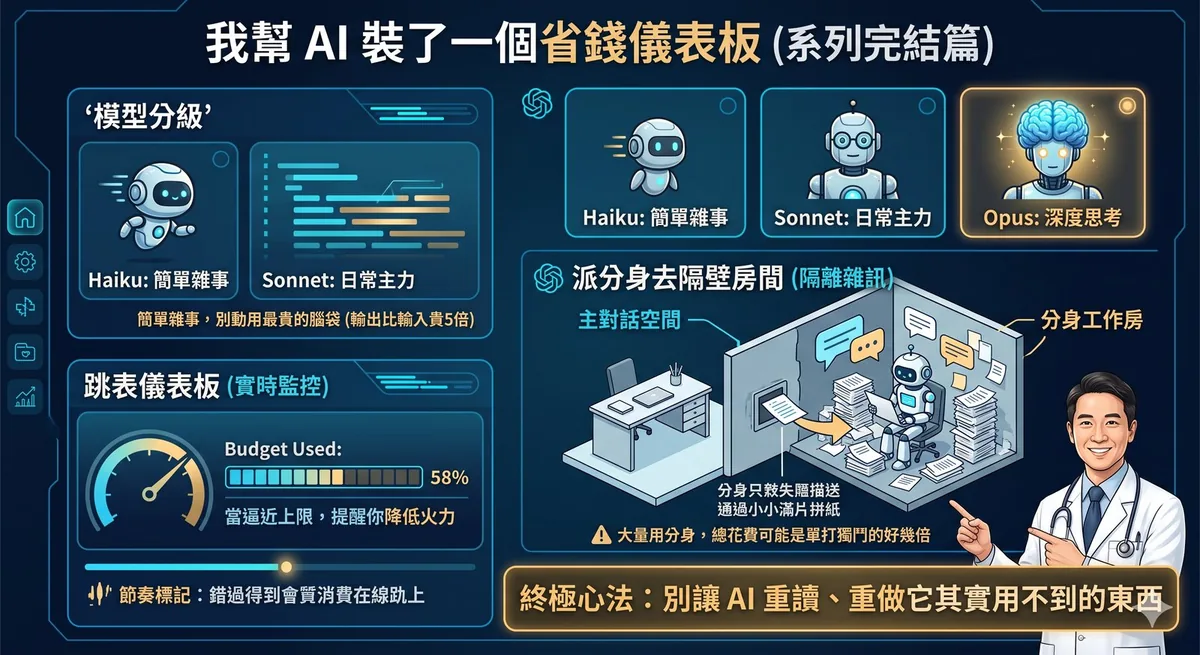
📖 省 Token 系列(共四篇):第一篇 為什麼你的 AI 越聊越笨 · 第二篇 能用算盤就別開超級電腦 · 第三篇 幫 AI 整理一張乾淨的工作桌 · 第四篇(本篇,完結) 來到系列最後一篇。前三篇我們從「為什麼 AI 越聊越笨」,一路講到「什麼時候別用 AI」「怎麼幫它整理桌面」。這一篇談的是錢真正花下去的那一刻:怎麼把每一塊錢花在刀口上。 第一件事:不是每件事都需要最聰明的腦袋(但省下來,就是為了負擔得起好的) AI 模型有分等級。以 Claude 為例,由便宜到貴大致是 Haiku、Sonnet、Opus 三級,價差很大。 如果你是按使用量付費的人,最直接的省法就是「派對的等級做對的事」:改格式、重新命名、簡單分類這種雜事,交給最便宜的 Haiku 就好;日常的寫作、查資料用中間的 Sonnet;只有真正需要深度推理的硬任務,才動用最強的 Opus。 這裡還有一個很多人都搞錯的觀念,特別講一下:「要看圖」不等於「要用最貴的模型」。 當你只是要 AI「看一張圖、認出裡面有什麼、把上面的字讀出來」這種辨識任務,最便宜的 Haiku 通常就完全夠用,便宜到一個誇張。只有要它「看懂一張複雜的醫學示意圖、解讀圖表背後的邏輯」這種需要推理的視覺任務,才值得升級。選模型的真正標準,是「這個任務需要多少思考」,不是「要不要看圖」。 不過老實說,我自己現在反而大多直接用最強的 Opus,XD。 為什麼?因為我發現,在目前的訂閱方案下,把前面三篇那些省 token 的功夫都做好之後,我的額度其實用不太完,而最強的模型品質又明顯比較好。所以對我來說,與其斤斤計較每件事該用哪一級,不如把省下來的額度,拿去讓最好的模型做每一件事。 我覺得這反而是整個系列最想講的一件事:省 token 從來不是為了小氣。 我把浪費擋掉、把該交給程式的交給程式、把桌面整理乾淨,省下來的這些,剛好讓我負擔得起「把最好的腦袋,用在每一個我在乎的問題上」。省,是為了能大方地花在刀口上。 最後補兩個進階的小心法: 讓 AI 少廢話,可以一勞永逸。 AI 的「輸出」比「輸入」貴上好幾倍(以 Opus 為例差到五倍),所以請它回答精簡就是直接省錢。而且這件事你不用每次重講,直接寫進給它的長期指令裡(就是第三篇那份常駐設定檔,或聊天版的「自訂指令」),叫它預設就講重點、不要長篇大論。一次設定,之後每次都省。 思考深度也能調。 同一個模型可以設定它「想多深」,簡單的事用淺一點、難的事才開深度思考。重點永遠是:把力氣花在真正難的地方。 第二件事:把吵鬧的雜事,丟到隔壁房間做 有些工作會吐出一大堆過程訊息:跑一輪測試、抓一份長文件、處理一堆紀錄。如果讓這些雜訊全部堆在主對話裡,桌面馬上被淹沒(回到第三篇,桌面一髒就又貴又笨)。 我的做法是派一個「分身」去隔壁房間做這件事。分身有自己獨立的工作空間,它的所有過程、雜訊、草稿都留在那個房間裡,只有最後的結論回到我的主對話。 這就像你請助理去查一整天資料,你不需要看他翻過的每一頁,只要他最後給你一頁重點。 注意 但這招有取捨,我必須老實說:派分身本身也要花錢,而且分身會自己燒一輪 token。官方就提醒過,大量用分身的工作流,總花費可能是單打獨鬥的好幾倍。所以原則是:當「保持主桌面乾淨」的價值,大於「多請一個分身」的成本時,才派。 不是什麼都丟分身。 (這篇從頭到尾,你會發現省 token 沒有一招是無腦的,每一招都在權衡。這正是它好玩的地方。) 第三件事:裝一個會對我跳表的儀表板 講了這麼多省法,最後一塊拼圖是:你得看得見自己花了多少。 看不見的支出最危險。所以我裝了一個開源小工具,叫 cc-budget(由 boyand 開發,在 GitHub 上找得到)。 ...

June 29, 2026 · 1 分鐘 · 168 字 · 陳柏威 Po-Wei Chen
計程車跳表上扛著被 token 金幣壓垮、下沉的對話泡泡,一隻友善的機器人吃力地拖著它

為什麼你的 AI 越聊越慢、越聊越笨?

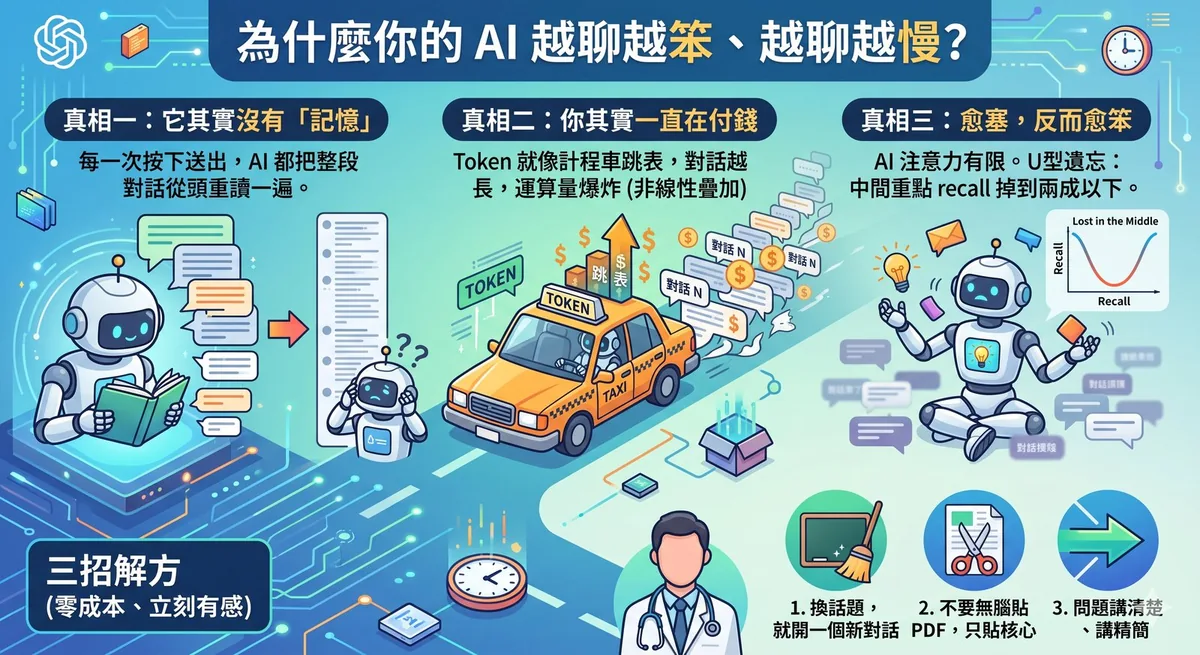
📖 省 Token 系列(共四篇):第一篇(本篇)· 第二篇 能用算盤就別開超級電腦 · 第三篇 幫 AI 整理一張乾淨的工作桌 · 第四篇 我幫 AI 裝了一個省錢儀表板 你一定有過這種經驗:跟 ChatGPT 或 Claude 聊一個下午,越到後面它越遲鈍,回得越慢,還會突然「忘記」你前面講過的事,甚至開始鬼打牆。 很多人以為是自己網路慢,或是 AI 當機。其實不是。這背後有一個大多數人不知道、但知道之後會立刻改變你用法的真相。 真相一:AI 其實沒有「記憶」 我們直覺以為,AI 像人一樣,聊著聊著就「記住」了對話。 它沒有。 每一次你按下送出,AI 都把你們從第一句到現在的整段對話,從頭重讀一遍,然後才回你下一句。它不是接著上一句講,而是每次都把整本對話重新看過。 所以你可以想像:對話越長,它每回答一句之前要重讀的東西就越多。這就是為什麼越聊越慢。 真相二:你其實一直在付錢,只是看不到帳單 AI 處理文字的單位叫 token(大致是一個字或半個詞)。你輸入的每個 token、它輸出的每個 token,背後都在計費。 最好記的比喻是:token 就是 AI 的計程車跳表。 距離(字數)越長,車資越高。 你在訂閱制的 App 裡看不到這張帳單,但它換了一張臉出現在你面前:就是那個「你今天的訊息額度已用完」,還有「怎麼越來越慢」。額度和卡頓的背後,都是 token 的運算量。 而且這筆帳不是線性疊加的。對話長度加倍,你付的運算量不是兩倍,而是接近四倍(這是 AI 內部運算機制的數學特性)。難怪長對話的卡頓感像在爆炸。 真相三:越塞,反而越笨 這點最反直覺,但最有用。 AI 的「注意力」是有限的,所有注意力加起來永遠等於一份。你塞進去的內容越多,每個重點分到的注意力就被稀釋得越薄。多餘的廢話會偷走本該分給關鍵問題的專注力。 這不是我隨口說的。一篇很有名的研究 Lost in the Middle(Liu et al., 2024)發現一個 U 型曲線:資訊放在對話的開頭或結尾,AI 記得最牢;但埋在中間的重點,記得的機率會掉到只剩大約兩成。難怪它常常把你中間講的事忘光光。 另一份 Chroma 在 2025 年的研究測了 18 個主流模型,發現它們全部都隨著輸入變長而表現下滑,這現象被叫做 context rot(脈絡腐化)。 ...

June 29, 2026 · 1 分鐘 · 173 字 · 陳柏威 Po-Wei Chen
左邊一台溫暖的木製算盤,右邊一台發光但耗電的超級電腦,中間隱含天秤,象徵選對工具

能用算盤,就別開超級電腦:什麼時候該叫 AI 動腦?

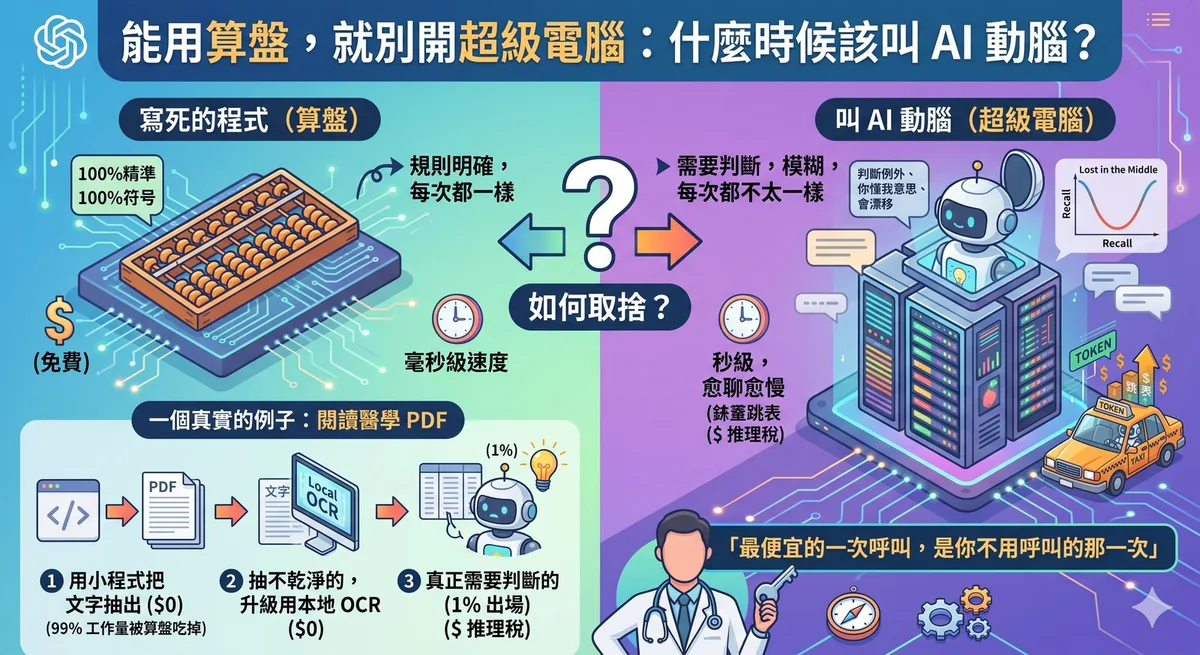
📖 省 Token 系列(共四篇):第一篇 為什麼你的 AI 越聊越笨 · 第二篇(本篇)· 第三篇 幫 AI 整理一張乾淨的工作桌 · 第四篇 我幫 AI 裝了一個省錢儀表板 上一篇我們講到,跟 AI 對話越長越貴越笨,以及三個立刻能用的省法。這一篇要往前再走一步,談一個更根本的分水嶺: 有些工作,根本不該叫 AI 來做。 聽起來很反骨,但這正是我把 AI 用得省又準的關鍵心法。 兩種工具:算盤與超級電腦 把事情交給電腦處理,其實有兩條完全不同的路。 一條是寫死的程式(script)。你事先把規則想清楚、寫成步驟,之後它就照著跑。像一台算盤,撥珠的規則固定,算十次一百次答案都一樣。 另一條是叫 AI 動腦(LLM)。你描述需求,它「理解」之後生出答案。像一台超級電腦,什麼模糊的、需要判斷的都能接,但每開機一次就燒一次電。 很多人的直覺是:現在 AI 這麼強,什麼都丟給 AI 就好。 這恰恰是燒錢又燒時間的根源。 一張表,看懂兩者的取捨 面向 寫死的程式(算盤) 叫 AI 動腦(超級電腦) 精準度 100% 確定,同樣輸入永遠同樣結果 會漂移,同一個問題問兩次可能答案不同,還可能一本正經地胡說 模糊處理 只能做規則講得清楚的事 能處理語意、判斷、例外、「你懂我意思」那種模糊地帶 花費 幾乎是零 每跑一次都付一次 token 的錢 速度 毫秒級,眨眼就好 秒級,而且對話越長越慢 前置工 要先把規則想對、寫對 開口就能用,零設定 看懂了嗎?兩者沒有誰比較好,只有誰適合這個任務。 規則明確、會重複很多次的事,交給算盤:又快又準又免費。 需要判斷、模糊、每次都不太一樣的事,才值得開動超級電腦。 一個真實的例子:我怎麼讀我的醫學課本 PDF 我有很多教科書的 PDF,常常需要從裡面撈內容。 如果我每一頁都直接丟給 AI 看,那是把超級電腦當印表機用:每一頁都付一次「看圖加讀字」的錢,貴得嚇人(後面那篇會講,直接丟 PDF 給 AI 看,每頁可能燒掉一兩千個 token)。 ...

June 29, 2026 · 1 分鐘 · 170 字 · 陳柏威 Po-Wei Chen
一隻友善的機器人把雜亂紙張收進有標籤的抽屜,乾淨的桌面只留一張關鍵的紙

幫 AI 整理一張乾淨的工作桌

📖 省 Token 系列(共四篇):第一篇 為什麼你的 AI 越聊越笨 · 第二篇 能用算盤就別開超級電腦 · 第三篇(本篇)· 第四篇 我幫 AI 裝了一個省錢儀表板 前兩篇都還停在「人人可用」的層次。從這篇開始,我帶你看我電腦裡那套被我折騰到很細的設定。 先說背景。我除了在手機上用 AI 聊天,更常用的是一個叫 Claude Code 的工具:它跑在電腦的終端機裡,可以直接讀我的檔案、改我的筆記、幫我自動化一堆事。你可以把它想成「一個住在我電腦裡、能動手做事的 AI 助理」。 正因為它能做的事多、跑的次數多(一個任務動輒呼叫 AI 幾十上百次),省 token 在這裡的回報會被放大很多倍。而省 token 的第一原則,跟整理書桌一模一樣: 桌面上只放現在用得到的東西,其他都收進抽屜。 常駐稅:有一種成本,你每一句話都在付 我有一個檔案叫 CLAUDE.md,裡面寫著我給 AI 的長期規則:筆記要用什麼格式、哪些資料夾不要碰、我的偏好是什麼。 這個檔案有個特性:它在每次開工的最一開始就被載入,而且整段工作過程都常駐在 AI 眼前,不會被收走。 意思是,如果這個檔案有 5000 個 token,那麼無論我今天只問兩句、還是聊兩百句,每一句的背後都在重複付這 5000 個 token 的錢。 我把它叫做「常駐稅」。每一行都是稅。 所以我刻意把它壓在 95 行左右,只留真正穩定不變、非寫不可的規則。會議記錄、設計過程、長篇說明,全部移到別的地方,要用的時候才叫出來。 順帶一提,這些「只給 AI 看」的設定檔,我一律用英文寫。因為中文在 token 計算上比較貴(同樣意思的中文通常比英文吃更多 token),而給人看的筆記我才用中文。給 AI 的省錢,給人的好讀,各得其所。 抽屜:讓記憶分層,不要全攤在桌上 我給 AI 做了一套記憶系統,但重點不是「記越多越好」,而是分層: 真正天天用到的,放在最上層,每次開工自動載入。 偶爾才用的,收進抽屜,需要時才拉出來。 很久沒碰的,直接封存。 我還做了一個「使用熱度」的計分:常被讀到的記憶分數高、留在桌上;冷掉的自動往下沉。這樣桌面永遠只有當下最相關的那幾張紙。 道理跟上一篇的算盤一樣:這套熱度排序是用程式算的,不勞駕 AI。 這對手機聊天版的人也有啟發:ChatGPT 的「記憶」和「自訂指令」功能不是免費魔法,它是每次對話前自動幫你貼上去的隱形內容,一樣佔空間、一樣每句重算。所以記憶要精簡,不是塞越多越好。 ...

June 29, 2026 · 1 分鐘 · 144 字 · 陳柏威 Po-Wei Chen
夜晚的書房裡,一個人平靜地檢查一串發光的鑰匙,旁邊有友善的 AI 小幫手與微微發光的家用伺服器

當 AI 無所不能,我回頭確認一遍家裡的鑰匙

這陣子我越來越依賴 Claude Code 幫我打理數位生活,從整理我的 Obsidian 筆記庫,到維護家裡自架的一堆服務(OpenWrt 路由器、AdGuard Home、Synology NAS、Oracle 雲端主機、Home Assistant),再到各種半夜自己跑的自動化,幾乎都交給他。他能做的事愈來愈多,我有一天就認真想了一件以前沒細想的事:我把一個「能讀我電腦裡的檔案、能執行指令、又能連上網路」的 AI 幫手,給了這麼大的權限,那萬一哪天出錯,會錯到哪裡去? 先搞清楚:權限這麼大,可能出什麼錯? 於是我請 Claude 陪我,把這件事從頭查一遍。查下來,AI 幫手(agent)的風險大致歸成幾類: 致命三要素(lethal trifecta):能讀檔案、能執行指令、能連網路,這三件單獨都還好,但湊在一起,一旦 AI 被騙,它就有能力把你的祕密讀出來、再送到外面去。 間接提示注入(indirect prompt injection):白話說,就是一段藏在網頁或某個檔案裡的惡意指令,可能在 AI 幫你讀資料時,偷偷叫它去做你根本沒交代的事,比如翻出你的金鑰再傳出去。 對話會留存:你順手貼進對話框的東西,其實會被記在某個地方。 老問題的放大版:密鑰散得到處都是、權限給太大、不小心把祕密存進了 git。 查完我的感想是,這些都不是假設性的學術風險,是真的會發生的事。再加上身邊愈來愈多同好也開始玩 AI agent、也在自架自己的服務,我想說乾脆把我查到的、做過的都記下來分享,希望也幫到正走在同一條路上的大家。 我們做了哪些檢查與掃描 方向定了,我跟 Claude 就一項一項盤: 數清楚我到底有多少把「鑰匙」跟 token,各自散在哪。不數還好,一數有點尷尬,原來比我想像中亂。 用一個叫 gitleaks 的工具,掃我自己筆記庫跟所有專案的 git 歷史,看有沒有哪次手滑把金鑰存了進去。 把家裡每一台主機之間「誰可以登入誰」的關係攤開來看(這在資安上叫橫向移動 lateral movement,意思是攻擊者攻破一台之後,能不能再跳到下一台)。 檢查我給 AI 的權限設定,跟過去那些對話紀錄到底留了什麼。 找到的問題,跟我們怎麼補 這段有點像在自首😅,但我覺得誠實把坑寫出來,比假裝自己一開始就做得很好有用多了。 問題一:一把沒上鎖的萬能鑰匙 我有一把 SSH(Secure Shell,遠端登入主機用的)金鑰,居然沒設密碼,而且同一把幾乎能打開我家所有主機。等於一把沒上鎖的萬能鑰匙,誰撿到誰就開全家。 我們的處理是:幫它加上密碼(passphrase),再用一個叫 ssh-agent 的機制,讓我只要輸入一次、之後自動化照樣順順跑,安全跟方便都顧到。然後把它從「一把開全家」改成「一把鑰匙只能做一件事」(這招叫 forced command,指定這把金鑰登入後只能執行某個預先設定的指令,而不能取得一般 shell)。 問題二:順手貼進對話的密碼 注意 我以前圖方便,曾把 token 直接貼進跟 AI 的對話框,那它就被留在本機紀錄裡了。這種「已經外洩過」的東西,與其一個一個追副本,最乾淨的做法是直接把舊鑰匙作廢(rotate),重發一把新的,舊的當場失效,外面那些副本就全變廢紙。 問題三:筆記裡躺著兩個忘記的金鑰 這是這次最有感的。我用 gitleaks 掃自己的筆記歷史,竟然挖出兩個我幾年前順手記下、早就忘得一乾二淨的真實金鑰。原來最大的洞,常常不是什麼高深攻擊,而是「過去那個貪方便的自己」。 ...

June 28, 2026 · 1 分鐘 · 137 字 · 陳柏威 Po-Wei Chen