花蓮慈濟研究部 AI agent 演講:AI agent 幫我追文獻、下載、評讀

AI agent 幫我追文獻、抓全文、評讀:在慈濟研究部講的一堂課

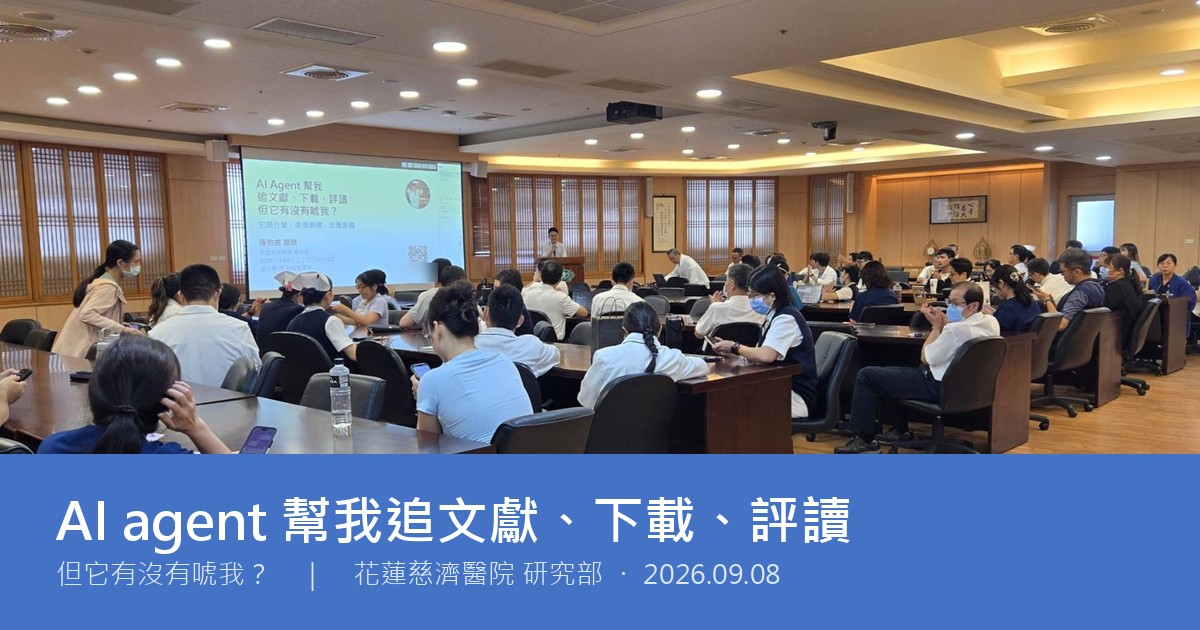
謝謝花蓮慈濟研究部的邀約,九月八號中午在協力樓和氣會議室講了一場 AI agent。中午時段還來了九十位左右,研究部、醫師、醫事人員、行政同仁都有,課前問卷收了 89 份,最擔心的三件事是「它講錯而我沒發現」、「個資會不會外洩」、「用了 AI 論文裡要怎麼寫」。所以這場就繞著這三件事排。 這篇把當天講的內容整理成文字版,給來聽的人回看,也給沒來的人一份完整版。課堂上有幾段因為時間被壓短了,這裡補完整。 AI agent 到底是什麼 用 AI 有三個層次。第一層是聊天框,把問題或論文貼給它,它回答你,資料要自己收集好、自己貼。第二層是 NotebookLM 這類,可以把一疊資料丟給它,它從固定的來源找答案。第三層才是 agent:它有手,可以開你電腦裡的檔案、跑程式、上網查、把結果存回你的資料夾。聊天框只能給你答案,agent 可以把事情做完。 它住在你的電腦上,只拿得到你給它的那個資料夾,每一個動作都可以要求它先問過你再做。所以「怕它控制我的電腦」這件事,答案是權限是你給的,可以只給一個資料夾。 整場最重要的一句話:AI 是人,它操作的是電腦。把它當一個人相處,很多規矩自己就推得出來。 跟它合作的四個原則 後面每一條規矩都從這四條來,記住這四件事,細節忘了也推得回來。 一、AI 是人,它操作的是電腦。 人接得住模糊、需要判斷的事,但慢、要花錢、每次講的話都不太一樣。程式是電腦,快、不花錢、給 A 永遠出 A,但只做你寫死的那件事。所以模糊的交給它,重複而確定的,叫它寫成程式再交給電腦跑。課前有人問「每個月統計醫院發表篇數」,這就是典型:叫 AI 寫一次程式,以後每個月都是電腦在跑,不要每個月叫 AI 算一次,它會算錯、算很久、又花錢。當天這題現場投票,四十一個人全部選對。 二、生成便宜,修補昂貴。 以前寫程式很貴,所以壞了就修補。現在生成很快,重做常常比修補簡單。所以計畫書比以前更重要:先寫清楚,再開工。工程界叫這個 SDD(Spec Driven Development),把這個字記下來回去問你的 AI 就好。 三、它會漂,但有錨就拉得回來。 每一步 95 分,做十步之後 0.95 的十次方剩 60 分。所以要有一份寫下來的計畫書,叫它每一步回去對「這一步對得上第幾條」。寫下來的那份就是錨。 四、AI 不碰原始資料,程式才碰。 在你自己的電腦上,用 AI 設計程式、寫程式、用假資料測程式;在醫院的電腦上,用程式跑病歷資料,AI 不在場。程式是在本機運算的,不會把東西送出去。這條在醫院一定要講。相關的法規我之前查過一輪,寫在這篇。 學術工作上,它已經能走完哪幾步 每一件事都用同樣的三拍講:我原本怎麼做、現在交出去哪幾步、我還留著哪一步。留著的會越來越少,因為連判斷都拆得開。 一、每個月追新文獻 原本:訂期刊通知信、掃標題、存進待讀清單。待讀清單越積越長,最後沒有人讀。 交出去:它每天掃新文獻,照我的興趣排序,放上一個網頁。「我的興趣」是一份寫下來的檔案,不是它猜的,所以排序會跟著我的興趣改。 我留著:勾哪幾篇真的要讀。一週看一次,五分鐘。工具是論文雷達。 二、抓回全文 原本:一篇一篇進圖書館系統點。 交出去:勾好之後它自己去抓,走四層階梯,只走合法的路:①免費全文(Unpaywall、PubMed Central)②出版社授權的文字探勘 API,用自己申請的金鑰 ③醫院館藏,走圖書館的遠端認證,嚴格限速 ④程式驗抓到的是不是「那一篇」,比 DOI、比標題,不是就退件。 這裡要特別講一下,也是圖書館同仁最擔心的事:用 AI 大量下載文獻,違反圖書館跟出版商簽的合約,會讓全院的 IP 被封。所以每一層都有節流,一次一篇、間隔幾秒、被拒就退避。工具是我自己寫的,程式碼公開在 paper-fetch,節流那一段請照抄。 ...
September 8, 2026 · 2 分鐘 · 289 字 · 陳柏威 Po-Wei Chen
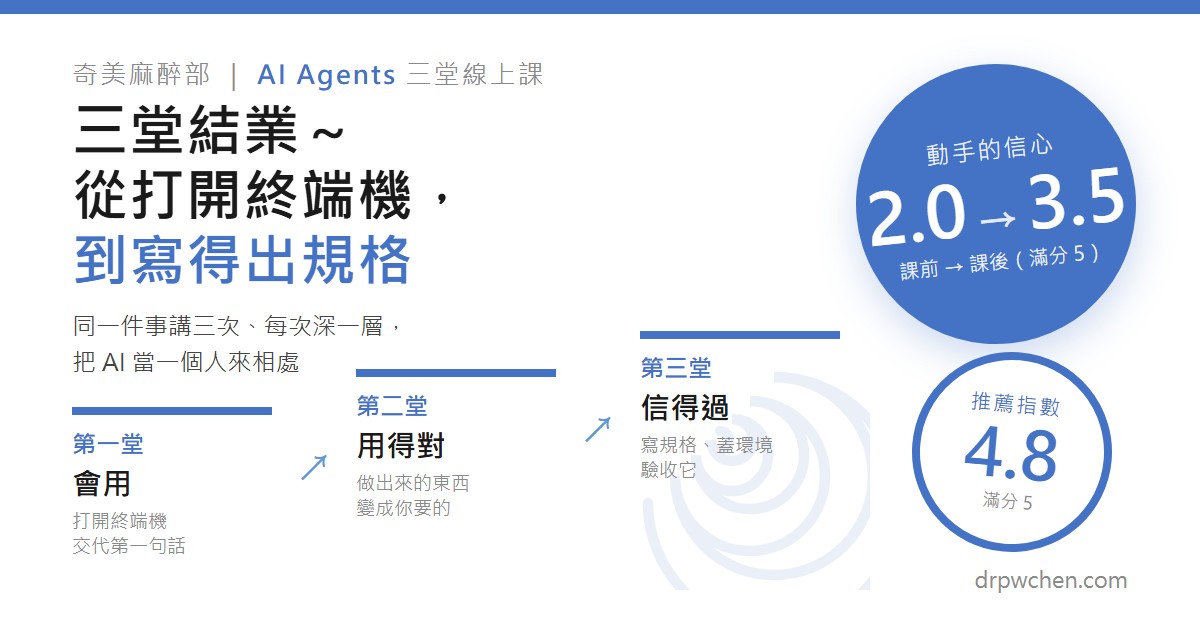
奇美麻醉部 AI Agents 三堂線上課結業:會用、用得對、信得過,信心 2.0 到 3.5,推薦指數 4.8

幫奇美麻醉科上完三堂 AI 課:螺旋式的排法,還有大家真的學會了

三個週二晚上,每堂一小時再加討論。謝謝奇美麻醉部的鄧醫師邀約,讓我來把一整套課從頭講到尾。 這篇想講三件事:這三堂為什麼這樣排、大家學到了什麼,還有我自己最感恩的一件事。 為什麼拆成三堂、每週一堂 醫學生時代去上過 AMEE 的 ESME(Essential Skills in Medical Education),裡面講到醫學的學習是螺旋式的:同一件事,基礎的時候碰一次,進階再碰一次,一圈一圈繞上去,越繞越熟。 學 AI agent 對醫師來說也是踏進一個陌生的領域,所以這次照同樣的方式排。有些東西三堂都會講到,每次多講深一層,看過三次就不陌生了。 中間刻意隔一週,讓大家回去能夠試作看看,有時做過才知道哪邊會遇到問題、往更深的地方走。 每堂都有課前單、回家作業、課後單,因為也是第二次講這個題目,希望能貼合大家的程度。用的太久太自然,會忘記第一次接觸的人卡在哪裡,這種知識的詛咒只能靠問卷來對齊,第二堂、第三堂的內容都是從上一堂的問卷長出來的。 三堂串起來的一句話:AI 是人 這句話是整套課的脊椎。把 AI 當成一個人:記憶力有限,聊久了會忘記前面講的;現在的個性是會字面解讀你的意思;會犯錯,要核對。把它當人相處,就不會覺得很難,也不會太相信它。 三堂就是繞著這個人轉三圈。 第一堂|會用 怎麼開機、怎麼交代第一句話。三層框架(聊天框、給它檔案、整個資料夾交給它),現場帶著大家打開終端機、整理一個亂資料夾、把 WHO 手術安全查核表轉成筆記。也講了它的記憶是怎麼運作的、為什麼要常常清空對話、怎麼知道它在唬你。 第二堂|用得對 讓它做出來的東西變成你要的東西。跟人講話一樣,要給背景、講要的樣子、畫界線、說怎麼驗收。這堂也講了醫療端的法規:授權範圍、去識別化的門檻、地端跟雲端的差別、衛福部的生成式 AI 指引講了什麼、沒講什麼。然後把自己開發的工具拆給大家看:排班系統從碎碎唸十分鐘到成品的過程,教科書變筆記的工具(textbook-to-note)裡面到底怎麼運作。 第三堂|信得過 怎麼知道它有沒有唬你。主題是 SDD(Spec Driven Development),學習用工程師的角度把東西設計好、維護好。AI 幫你從 0 到 1 很快,1 到 100 要靠規格跟維護。講規格怎麼寫、環境怎麼蓋、怎麼驗收,還有幻覺跟安全性的事。最後再繞到我自己覺得AI時代怎麼學習。 大家有開始實作 CLI 課前跟課後都問了同一題:用終端機跟 AI 一起做事,信心幾分(1 到 5)。課前平均 2.0 分,課後進步到 3.5 分。看起來逐漸入門了~大家應該都有順利做出想要的筆記,還有人自製臨床/讀書/研究工具等。我想最重要的是,產生一個跟AI互動的默契,能在互動中成長出自己的系統。 最感恩的一件事 課排在晚上八點半到九點半,討論常常到快十點。這個時間大家下了班、吃完飯、還要開電腦,第一堂線上四十幾位,第二堂、第三堂還有三十五位。中間當然有人覺得太難或有別的事離開,但留到最後的人這麼多很讓人開心! 後記 那當然這三堂都大量用 AI 來備課,逐字稿回放、問卷分析、投影片改版也都靠它,這個流程蠻好玩的,下一篇單獨寫~ 很喜歡這樣看到大家長出不同的東西,分享這種像在玩電玩的快樂😁 如果有單位想開類似的課,或是三五好友揪一揪,也歡迎來問我喔~

September 3, 2026 · 1 分鐘 · 63 字 · 陳柏威 Po-Wei Chen
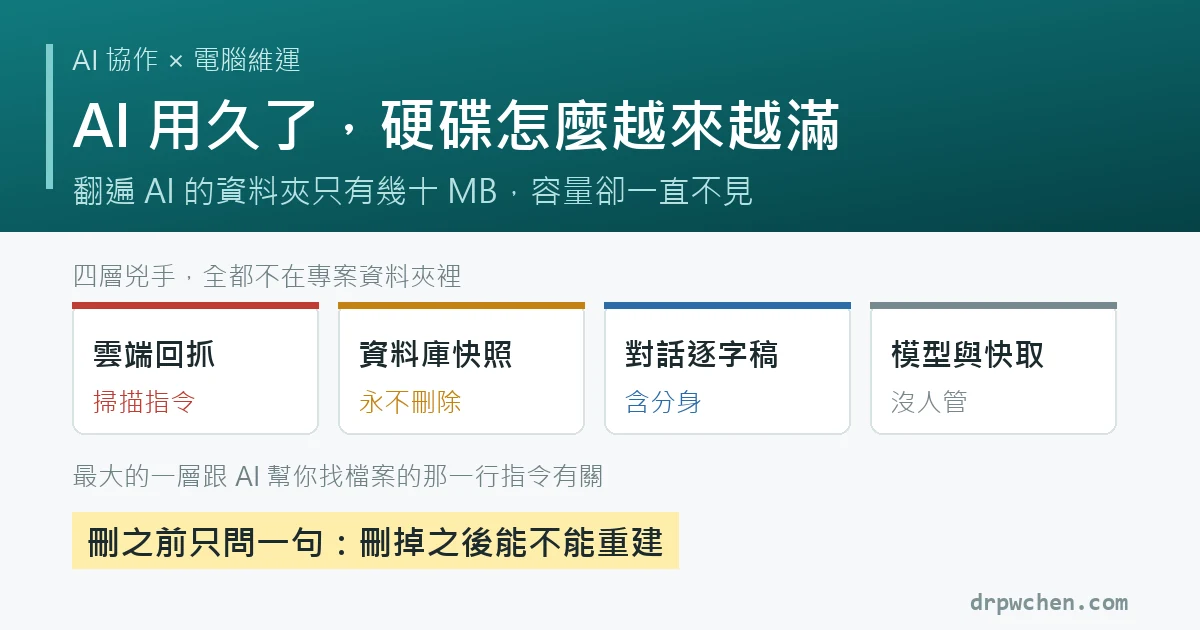
四層吃掉硬碟容量的來源:雲端回抓、資料庫快照、對話逐字稿、模型與快取,全都不在專案資料夾裡

AI 用久了,硬碟容量怎麼越來越滿

這個題目是訂閱區的歐陽醫師許願的。他說得很準:認真看 AI 運行的資料夾,好像都才幾十 MB,但是電腦容量就是被吃掉一大半。 這件事我自己也遇到很多次了。我的 C 槽 953 GB,過去一個多月每隔幾週就快滿一次,每次都是跟 Claude 說「幫我清理」,清完過陣子又滿回來。這次我們不清了,改成把一個多月來每一次清理的對話全部翻出來對帳,算清楚是誰一直長回來。 查出來四層,照體積排序。其中一層是我們自己開源出去的工具,這個下面會老實講。 一、雲端同步:檔案被讀一次,就永久回到你的電腦 這台電腦的 OneDrive 雲端有大約 400 GB。檔案設成「僅雲端」之後,檔名在、圖示在,不佔空間。但只要有任何程式打開那個檔案,同步軟體就會把它下載回本機,而且除非你自己把它釋放回雲端,它就會一直佔著空間。 八月十七號那次大掃除清出 382 GB。四天後回頭看少了 56 GB,其中課本 PDF 那幾個資料夾自己回到本機 45 GB。 這件事的怪,怪在因果被切斷了。吃掉容量的那個動作,跟長出來的那些檔案,看起來完全沒關係。你翻遍 AI 的資料夾,當然只有幾十 MB。 我們怎麼把它抓出來的 這一段是這篇最想分享的:不是我自己會查,是我跟 Claude 一起把範圍縮小的過程。 第一步,先問清楚機制。 我請他上網查「OneDrive 在什麼情況下會自動把僅雲端的檔案下載回本機」。查回來的答案是:只要有程式開啟那個檔案就會,不必真的讀內容。這一句話後來就是破案關鍵。 第二步,一個一個排除。 每關掉一個嫌疑犯就重新量一次本機佔用: Windows 搜尋索引:停掉六分鐘,佔用沒變化 檔案總管縮圖、防毒掃描、Google Drive、iCloud、Synology Drive:都排除 OneDrive 自己重抓:手動把二十個檔案標成「釋放空間」,六分鐘內一個都沒有被抓回來 排到這裡,OneDrive 本身的嫌疑就洗清了。它只是執行者,不是發動者。 第三步,我提了一句話,方向就轉了。 當下我們一直在找「現在正在跑的東西」,可是我想到:這些下載搞不好是幾個小時前下的指令留下來的,那支程式可能還活著,只是沒人注意。 我把這句話丟給他,他回頭去翻還在執行中的舊程序,當場抓到兩支: 下午五點二十某個 AI session 下的 find 指令,尾巴接了 head,本來只要前二十筆。head 拿夠了自己結束,前面的 find 卻沒有跟著死,一路跑了五個小時,回抓 19 GB 抓它的同時,另一個 session 又下了一支掃全機的 find,三分鐘再吃掉 6 GB 兩支都殺掉之後,回抓當場歸零。 ...

August 26, 2026 · 2 分鐘 · 218 字 · 陳柏威 Po-Wei Chen
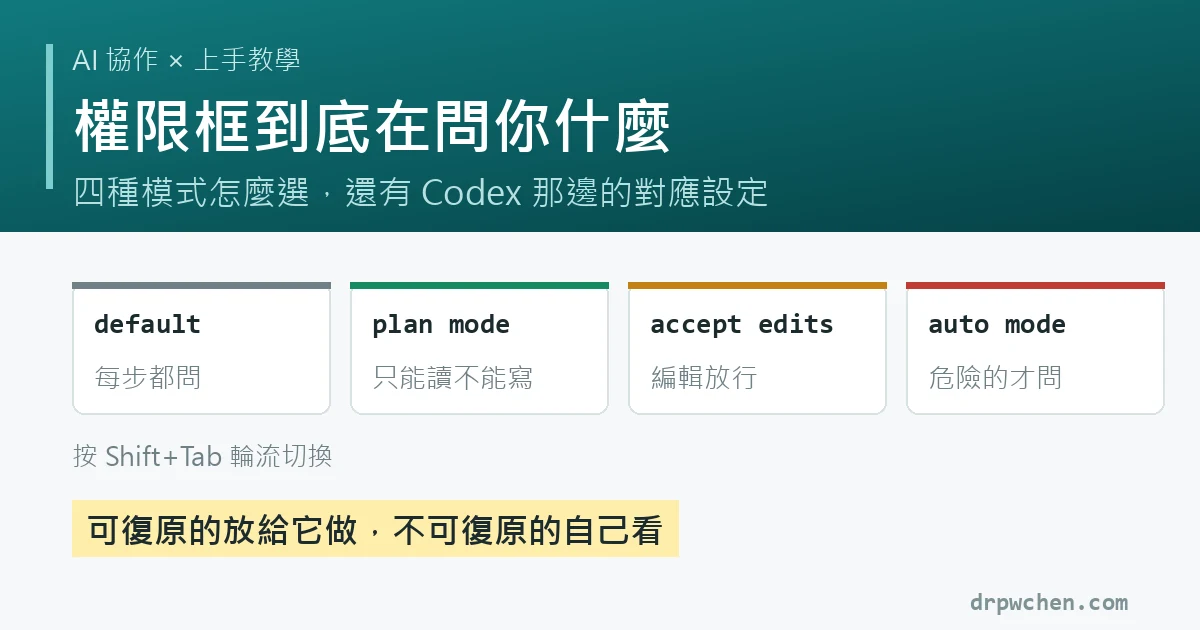
權限框到底在問你什麼:default 每步都問、plan mode 只能讀不能寫、accept edits 編輯放行、auto mode 危險的才問,按 Shift+Tab 切換

權限框到底在問你什麼:四種模式、auto mode 的數據,還有 Codex 的對應設定

上週幫一群麻醉科的醫師朋友上了一堂 AI agent 上手課。課後回饋很有意思:「權限框與 auto mode」同時出現在兩張名單的前段,投「最有收穫」的人很多,投「沒聽懂」的人也很多。代表這東西重要,但一堂課的節奏講不完。這篇把它一次講完整。 還沒裝起來的朋友,可以先看從零開始用 AI agent那篇,裝好再回來。 權限框是什麼:它動手之前,先舉手 第一次叫 Claude Code 或 Codex 整理資料夾,最不習慣的就是它一直跳框問你「可以嗎?」。 這個框其實是整套系統最重要的安全設計:AI agent 要動你電腦裡的東西之前,必須先讓你點頭。框裡通常有三個部分: 它想跑的指令:一行終端機指令,像 ls、mkdir、rm 它自己的白話解釋:指令下面那一兩行,說明它想做什麼、為什麼 你的選項:同意這次、同意以後都不用問、拒絕 你不需要會終端機指令。你只需要看得懂那行白話解釋,然後判斷「合理嗎」。看不懂的時候有兩招: 看不懂它想幹嘛的兩招 直接回它:「用五歲小孩能懂的方式解釋你現在要做什麼」(英文縮寫叫 ELI5,Explain Like I’m 5,AI 都看得懂) 把那行指令複製,貼給網頁版的 AI 問「這個指令會做什麼?有風險嗎?」 四種模式:按 Shift+Tab 切換 每一步都問你,等它做完一件事你可能按了二十次同意。所以 Claude Code 提供好幾種模式,按 Shift+Tab 就能輪流切換,畫面上會顯示目前在哪個模式。日常用得到的是這四個: 模式 它會怎樣 什麼時候用 default(預設) 每個會改到東西的動作都先問你 剛開始建立信任的階段 plan mode 只能讀、不能寫,先研究再給你一份計畫 想先看它打算怎麼做;要碰重要資料的第一步 accept edits 檔案編輯自動放行,跑指令仍會問 改稿、寫筆記這類編輯密集的工作 auto mode 系統自動判斷每條指令危不危險:安全的直接放行,危險的攔下來問你 日常主力 (Claude Code 其實還有更多模式,像給無人值守環境用的 bypass permissions,那些跟日常上手無關,先不用管。) auto mode 為什麼反而比較安全:警報疲勞 臨床的人對 alarm fatigue 都不陌生:monitor 什麼都叫,叫久了大家聽到聲音只是伸手把它按掉。權限框也一樣。當每一個框都要你同意,你很快就會停止閱讀,變成反射性按同意。這時候「每步都問」給你的不是安全,是安全感。 ...

August 21, 2026 · 1 分鐘 · 207 字 · 陳柏威 Po-Wei Chen
讓 AI 自己調查自己為什麼一直犯錯:違規計數器 vs 週稽核全數通過的對比

讓 AI 自己調查自己為什麼一直犯錯

用 AI 工作一陣子的人,大概都遇過這件事:同一個錯,你講過了,規則也請它記下來了,過幾天它又犯一次。 而且我不是沒有防:規則寫進了它的記憶檔、違規有計數器、還有每月的定期檢視,該有的機制都在。但七月底,我看著我的 AI 助理第三次犯下同一個錯(最後兩次只隔一天),才認真面對一個事實:「記得」跟「會做」是兩回事。而更意外的是,後來的調查發現,問題甚至不在它不記得,是我們整套「記錯誤」的系統,量尺本身壞掉了。 這篇想分享的,就是我們最後長出來的一套「AI 自我糾錯系統」的設計,以及中間最有趣的一段:我讓 AI 自己調查自己,還特別交代它「不要相信寫交班單的那個 AI」。 事情是怎麼爆開的 這陣子我陸續把一些自己做的工具開源(工具箱總整理裡的那些)。發布開源軟體有一套禮儀:改了什麼要寫進更新紀錄(CHANGELOG)、打版本標籤(tag)、在 GitHub 上建立正式的發布頁(release)。這些規則早就寫在 Claude 的記憶檔裡。 七月底某天,我點開一個剛發布新版的 repo,首頁看起來什麼都沒有。我第一反應是「你沒寫 CHANGELOG」。它查了之後回報:CHANGELOG 其實寫了,tag 也打了,漏的是最後一步「建立 release」,而那恰好是訪客唯一看得到的一步。回頭一查,前兩個版本也都一樣。 隔天我請它把我全部十三個公開 repo 掃一遍,結果挖出十五個同樣的缺口。更妙的是,就在稽核到一半的時候,它又犯了第三次同型的錯。規則就寫在它的記憶裡,它也讀得到,然後照樣犯。 關鍵的一問:「你以後真的會用嗎?」 它的第一個提案很自然:寫一支腳本,把正確的發版流程整個包起來。 我問了一句:「你以後會固定呼叫這支腳本嗎?」 它想了一下,誠實地說:不會。腳本跟記憶檔的失效模式一模一樣,都要它先「想起來」才有用。這個答案讓我們改變了做法:與其多一個要記得的東西,不如加一道攔截(hook,上手系列第二篇講過的關卡概念):只要它想手動跑發版指令,動作會在當下直接被擋下來,只剩包好的正確流程能走。從「請你記得」變成「你想錯也錯不了」。 讓它調查自己,但不准相信自己 前面說過,揪錯的零件一直都在。所以問題比「沒有機制」更刁鑽:零件都在,錯還是溜過去了,到底卡在哪? 這裡我們用了一個我很喜歡的設計。當天犯錯的那個 AI session 把來龍去脈寫成一份調查交班單,但裡面明白寫著一條: 交班單裡的自我迴避條款 「不要把我的假設當成計畫——這份文件是犯錯者本人寫的,幾乎必然被它的立場影響。請先獨立驗證診斷,再決定要不要建任何東西。」 接著換一個全新的 session 接手調查,手上只有可以重跑的驗證指令,沒有前一位的結論。 做過品質改善的人應該覺得眼熟:根本原因分析(root cause analysis)的調查,本來就不該由事件當事人自己主導。當局者迷這件事,對 AI 一樣成立。 調查結果:推翻了兩個前提 獨立調查翻出來的東西,跟交班單猜的不一樣。 第一,AI 並沒有隱瞞錯誤。我原本合理懷疑:違規次數是它自己記的,它會不會少記?結果翻遍紀錄,低報只有零星幾筆,而且是「自首了但記錯地方」。其中一個規則檔裡,它老老實實記了十二次違規,好幾次我根本沒發現。誠實度不是問題。 第二,問題出在量測層。幾個具體的發現: 計數無法歸屬:違規次數記在「檔案」上,但一個檔案裡合併了十幾條規則。帳面上的「違規 4 次」,追不回是哪一條規則的 4 次,這個數字沒有行動意義。 偵測器本身有 bug:負責從歷史對話裡撈「使用者糾正過什麼」的程式,寫死了只看最近二十筆,而且漏看一整類訊息格式。回頭驗證時發現,最關鍵的那筆證據,它從結構上就不可能抓到。 記錯帳本:有三筆真正的違規,被寫進了另一本記「工具摩擦」的帳,正好躲過所有檢查。 還有一個反轉:交班單斷言「這些計數完全沒有版本紀錄,無從稽核」。錯了——記憶目錄其實一直有自己的 git 版本庫,一千多筆自動存檔,稽核軌跡從頭到尾都在,只是被上層設定蓋住,連 AI 自己都不知道。 換句話說:這個系統不缺零件,缺的是接線。計數器沒有人讀、偵測器壞著、帳本記錯棚。在量尺壞掉的情況下加更多自動化,只是把錯的數字算得更快而已。所以後面的修法幾乎沒有新建什麼大東西,都是把既有的零件接起來。 最後的設計:四條原則 修完之後,整套系統收斂成四條原則。它們不是 AI 專用的,你會發現每一條在醫院的品質管理裡都有對應物。 一、錯誤要記成「可歸屬的事件」,不是一個數字。每次違規記一行:日期+哪一條規則+一句事實。計數是用數的,不是用手改的。(對應:異常事件通報寫事件經過,不是只在統計表上加一。) ...

August 1, 2026 · 1 分鐘 · 99 字 · 陳柏威 Po-Wei Chen
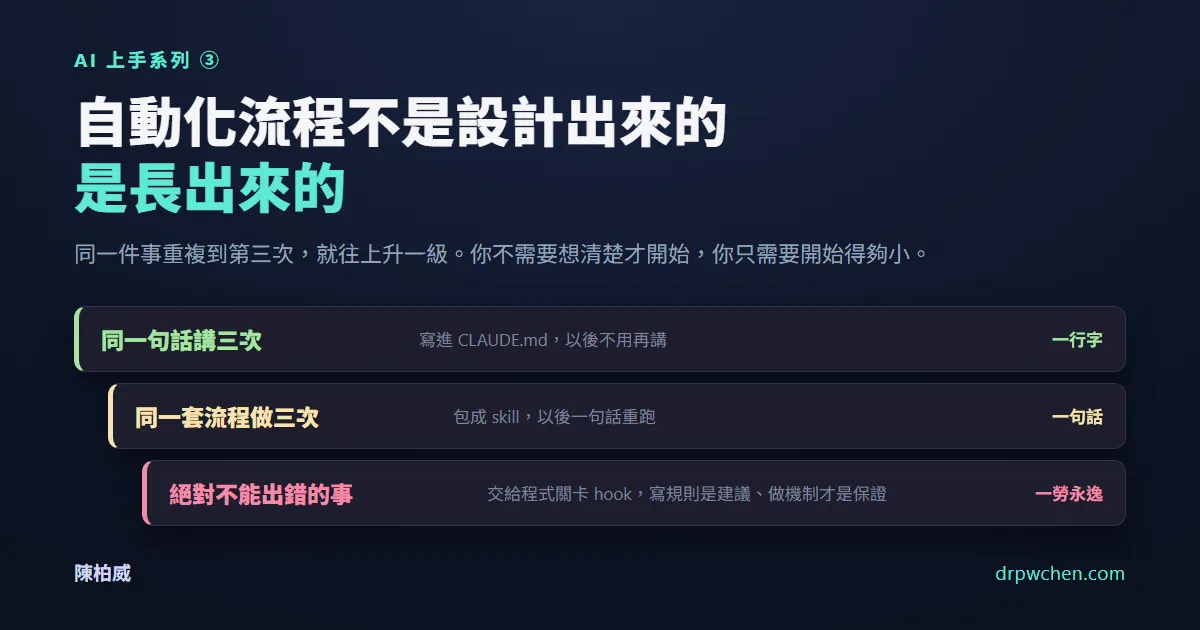
AI 上手系列③:自動化流程不是設計出來的,是長出來的 — 起手五件事與重複第三次就升一級的階梯

自動化流程不是設計出來的,是長出來的:從一句話到一條產線

這是 AI 上手系列的第三篇。第一篇講怎麼裝起來,第二篇講怎麼跟它講話、怎麼設關卡。 第二篇的結尾我說:難的從來不是「怎麼問」,是「怎麼設計流程」。 這篇要把那句話收掉。答案可能跟你想的相反:流程不是設計出來的,是長出來的。 最常見的卡點:「我不知道要怎麼開始規劃」 我被問過很多次類似的問題:「你那套自動化好厲害,我要怎麼規劃我自己的?」 老實說,我從來沒有規劃過。我三月的時候只做了一件事:挑了一件每週都在重複的小事,叫它做一次。 今天回頭看,我的規則檔、十幾個 skill、一堆自動排程,沒有一個是事先設計的。每一個都是同一件事重複了幾次之後,才「升級」成現在的樣子。 所以如果你卡在「不知道怎麼開始」,好消息是:你不需要想清楚才開始,你只需要開始得夠小。 起手式:五件事講清楚,其他都不用 挑好那件小事之後,交代它的時候把這五件事講清楚。這不是我發明的,是把官方 best practices 濃縮成非工程師版本: ① 目標講清楚:你要什麼、給誰用、拿去做什麼。「幫我整理逐字稿」不如「整理成 SOAP 格式,這是要放進病歷系統的」。 ② 只補它不知道的:你們科的慣例、單位的格式、只有你知道的眉角。模型已經會的不用教:SOAP 是什麼不用解釋,你們科的 SOAP 長什麼樣才要講。每一句廢話都在稀釋它的注意力(原因寫在第二篇「為什麼它會越聊越笨」那節)。 ③ 界線先講:哪些檔案不准動、哪些事要先問過你。而且真正的紅線不要只用嘴巴講,第二篇的三層機制(hooks / permissions / CLAUDE.md)就是拿來放這個的。 ④ 訂「怎樣算做完」:這條是官方排第一優先的建議,也是我覺得投資報酬率最高的一條。給它一個它能自己跑的檢查: ❌「幫我整理這些逐字稿」 ✅「整理完自己檢查一遍:每一份都要有四段、每段都要有內容,缺的標出來給我」 ⑤ 先跑一個爛版本:不滿意再一句話改。迭代永遠比一次寫滿快。 就這樣。不用畫流程圖、不用寫規格書。 流程怎麼長大:重複第三次,就升一級 真正的重點來了。你的「流程」不是某天坐下來設計的,它是照一個很簡單的規則長出來的: 同一件事重複到第三次,就往上升一級。 你發現自己在… 升級動作 成本 同一句話講第三次(「回我繁體中文」) 寫進 CLAUDE.md 一行字 同一套多步驟流程做第三次(先轉檔、再整理、再歸檔) 包成 skill:跟它說「把剛剛這整套存成一個 skill」 一句話 發現某件事絕對不能出錯(改到原始檔、送出病人資料) 交給程式關卡(hook / permissions) 要動手設定,但一勞永逸 三層的差別在第二篇講過了,這裡只補一句:寫在規則裡是建議,做成機制才是保證。 界線越重要,就該住在越下面那層。 這個階梯還有一個隱藏的好處:每一級都是你已經驗證過的東西。你不是在憑空設計一個 skill,你是把一套「已經手動跑成功三次」的流程存起來而已。設計可能會錯,重複不會。 驗收的習慣:這篇最重要的一節 起手式的第④點(訂「怎樣算做完」)值得單獨拉出來講,因為它不是五件事之一而已。它是整套方法裡唯一「做與不做會決定你能走多遠」的習慣。 驗收有三個層次,照順序養成: 層次一:單次驗收。 每個任務交代時就附上檢查方法,讓它做完自己查(「每一份都要有四段、缺的標出來給我」)。這是起手式教的。 層次二:可重跑的驗收。 把檢查存下來,變成隨時可以再按一次的按鈕。差別很大:單次驗收保證「這次做對了」,可重跑的驗收保證「以後改東西也不會弄壞它」。工程師管這個叫回歸測試(regression test),但概念本身跟程式無關:哪怕你的檢查只是「數一數每份紀錄都有四段」,能重跑,就有資格叫驗收。 層次三:驗收先行。 這是官方 best practices 裡明講的工作流:先寫檢查、確認它現在會失敗,再叫 AI 做到通過。聽起來像工程師的儀式,翻成白話就是:開工前先給它看一個「做對了長這樣」的具體例子。它有目標可以自己迭代,你也不會做完才發現彼此想的不一樣。 ...

July 27, 2026 · 1 分鐘 · 186 字 · 陳柏威 Po-Wei Chen
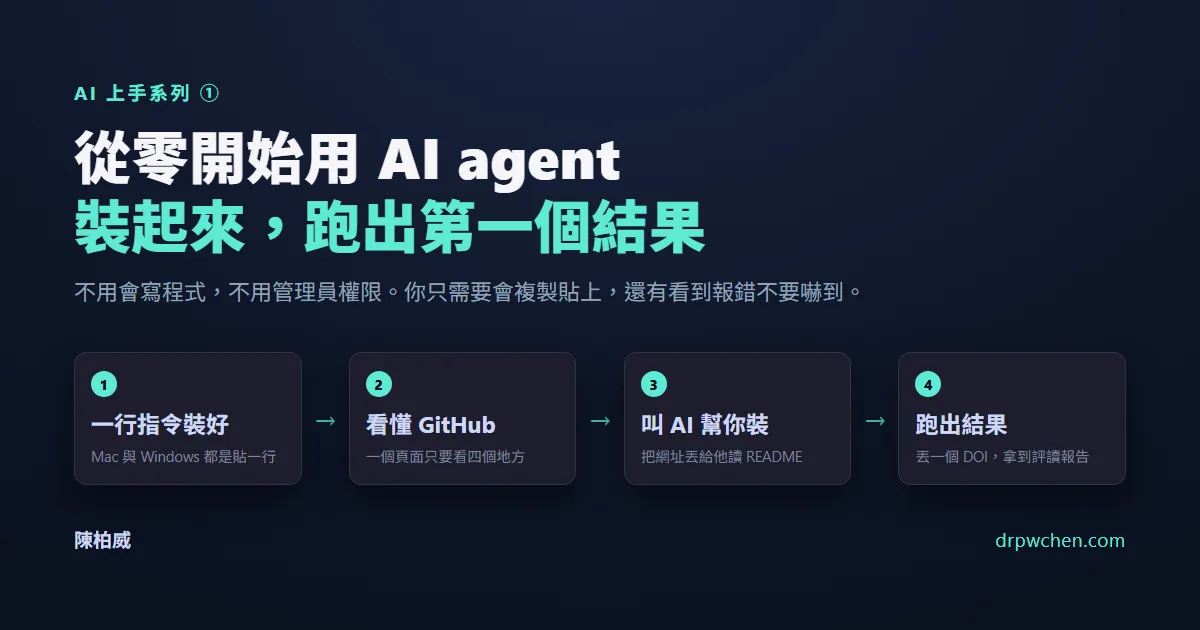
AI 上手系列①:從零開始用 AI agent — 一行指令裝好、看懂 GitHub、叫 AI 幫你裝、跑出結果四步驟

從零開始用 AI agent:安裝、看懂 GitHub、跑起你的第一個工具

這是一篇會一直更新的文章。 我把自己做的工具都開源放在 GitHub 上,陸續有人跟我說:「東西看起來很厲害,可是我連第一步該幹嘛都不知道。」也有人問我:「GitHub 是什麼?我點進去看到一堆檔案,然後呢?」 所以這篇不是介紹工具,是帶你把第一個跑起來。 已經在用 Claude Code 的朋友,直接跳到 第 4 節。 最後更新:2026-07-24 先花 30 秒確認這篇適不適合你 讀完你會做到的事:在自己的電腦上,丟一個論文的 DOI 給 AI,十幾分鐘後拿到一份有引用查核、有證據等級的評讀報告。或者丟一本 PDF 教科書給他,讓他整理成一篇一篇帶出處的筆記。 你需要準備的: 一台電腦(Mac 或 Windows 都可以,醫院/公司電腦也行,不需要系統管理員權限) Claude 的付費訂閱,Pro 就夠了(約 US$20/月)。免費帳號不支援 Claude Code,這是硬條件 不需要會寫程式。真的。你需要的是「會複製貼上指令」跟「看到紅字錯誤訊息不要嚇到,把它整段貼回去問 AI」這兩件事而已 如果這兩件事你做得到,就繼續往下 👇 — 1. 同一個人,只是工具長大了 先講一段我自己的時間軸,因為我覺得這比任何教學都重要: 三月:第一次把 AI 搬到自己的電腦上,做了語意搜尋、把上課錄影自動轉成筆記。那時候我每做一件事都要手動貼一段「你只能根據我給的資料回答」的咒語,盯著它會不會亂講,每一步都要按確認,煩到快瘋掉 四到五月:慢慢把轉書、抽圖、OCR 磨成一條生產線,開始把重複的事變成一鍵 六月:一邊準備專科考試,一邊架了論文雷達、復健課程雷達,會自動推播新東西給我 七月:門診智慧病歷、額度守門、讓兩個 AI 互相審查對方的產出。開始在「管一群 AI」 中間我沒有變聰明,是工具長大了,加上我學會把每個踩到的坑寫成一條規則。 我講這個是想說:你現在就是我的三月。而且你比當年的我幸運,你一開始拿到的工具,就已經是好用的版本了。 2. Claude Code 不是聊天機器人 這是最多人卡住的地方,卡住的原因不是技術,是觀念沒轉過來。 ...

July 24, 2026 · 4 分鐘 · 726 字 · 陳柏威 Po-Wei Chen
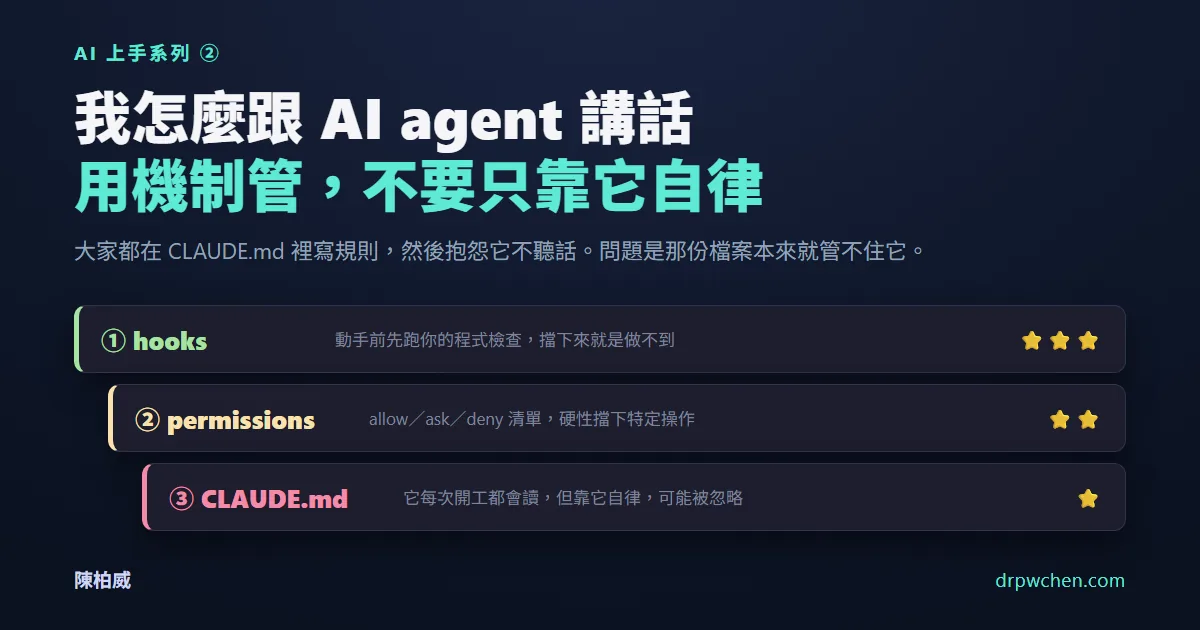
AI 上手系列②:我怎麼跟 AI agent 講話 — hooks/permissions/CLAUDE.md 三層機制強度階梯

我怎麼跟 AI agent 講話:三個心法、四個元技能,還有一份不該一直長大的規則檔

上一篇 《從零開始》 講的是怎麼裝、怎麼跑起來。 這篇講的是用得好,而這跟裝得起來,是完全不同的一件事。 我發現真正決定成效的不是你用哪個模型、不是你會不會寫程式,是你怎麼交代事情、怎麼設關卡。這篇的東西不綁特定工具,你用 ChatGPT 也適用(最後一節會講差在哪)。 三個心法 心法①:它像個很聰明、但記憶有限的新人 它知道很多,但它有一張有限的桌面。塞太多東西就會顧此失彼、會忘記你前面講什麼。 用交班來比喻最好懂:講重點、講清楚,別把整本病歷從頭念一遍。 所以你要主動幫它保持桌面乾淨:一個任務講清楚、講完就 /clear 重開,不要一路累積用不到的東西。 (為什麼會這樣、成本怎麼算,我在 AI Token 經濟學系列 寫了四篇,這裡先講結論。) 心法②:用機制管,不要只靠它自律 這是我覺得最多人做錯的一件事:大家都在 CLAUDE.md 裡寫規則,然後抱怨它不聽話。 問題是,那份檔案在官方的定位裡,是「參考資料」,不是「強制設定」。官方文件講得很白: Claude treats them as context, not enforced configuration. (Claude 把它當成脈絡,不是被強制執行的設定。) 真正能管住它的機制有三層,強度差很多: 層級 是什麼 強度 適合放什麼 ① hooks 在它要動手的那一刻,由你的程式攔下來檢查 ⭐⭐⭐ 程式性強制,模型無法忽略 「這件事絕對不准發生」 ② permissions settings.json 裡的 allow / deny / ask 清單 ⭐⭐ 硬性擋下,但只認工具與指令樣式 「這類操作要先問我 / 永遠不准」 ③ CLAUDE.md 一份它每次開工都會讀的文字說明 ⭐ 靠它自律,可能被忽略 「通常我們這樣做」的慣例與風格 ① hooks:把規矩變成程式 hook 是掛在它生命週期上的一段程式。最常用的是 PreToolUse:它要動手之前先跑你的檢查,你的程式回傳「拒絕」,這個動作就執行不了。 關鍵差別在這裡:被 hook 擋下來的動作,不會回頭讓模型去想替代方案。它不是「勸退」,是「做不到」。 ...

July 24, 2026 · 3 分鐘 · 440 字 · 陳柏威 Po-Wei Chen
我的 AI 工具箱總整理:依需求分類的工具清單

我的 AI 工具箱總整理:想做什麼,就從這張清單找工具

最近在準備給治療師夥伴的 AI 上手講座,想說來個進階清單,把我平常用的工具、寫過的程式都列出來,這樣想做某件事的時候,可以快速對照「這個功能該找誰」。這也是我自己一直想整理的東西,趁這次一次寫完整。 這篇不挑受眾、不做刪減,從 AI 助手到家裡的備份系統全部列出來~用法是先找到你的需求分類,再看那一節的表。標 ⭐ 的是我自己寫、已經開源的程式,歡迎直接拿去用;標「免費」的都是我實際在免費額度內用的。(太愛免費了,全部幾乎都沒付錢 XD) 目錄 一、AI 主力與引擎 — AI 助手與協作主力・免費雲端與本機 AI 引擎 二、聲音與文件處理 — 語音轉文字・文字轉語音・OCR 三、學習與知識管理 — 筆記與個人知識庫・臨床資料去識別化・論文與臨床實證・考題練習 四、對外發布:網站與信箱 — 架網站與 Cloudflare・網域信箱與寄信 五、自動化與自架後盾 — 自動化排程與通知・家庭伺服器與智慧家庭・備份與不斷電 怎麼開始? 一、AI 主力與引擎 AI 助手與協作主力 工具 做什麼 免費? Claude Code 能讀寫檔案、執行程式、把事情「做完」的 AI 代理,我所有工作流的中心 訂閱制 claude.ai 網頁版,卡關時換乾淨對話問、手機臨時查 有免費層 Gemini 查資料廣度強、原生吃 PDF 和圖片,當第二意見 有免費層 OpenAI Codex 程式卡關找不同解法、對抗式 code review ChatGPT 免費帳號可用 herdr 多工終端管理器,讓好幾個 AI 任務同時在背景長跑、隨時切換 ✅ ⭐ claude-pacer Claude Code 的用量油表+自動煞車:狀態列顯示額度,快撞上限時先收尾、額度重置後自動續跑 ✅ 開源 Claude Code 是這份清單裡少數我付錢、而且付得心甘情願的東西。它不只是聊天,這個部落格、下面所有我寫的工具,幾乎都是我跟他一起完成的。其他 AI 我當第二意見用:Gemini 查資料、Codex 挑毛病。要注意 Gemini 免費層的資料會被拿去訓練,敏感內容不要餵;Codex 記得先到設定把訓練關掉。 ...

July 20, 2026 · 3 分鐘 · 583 字 · 陳柏威 Po-Wei Chen
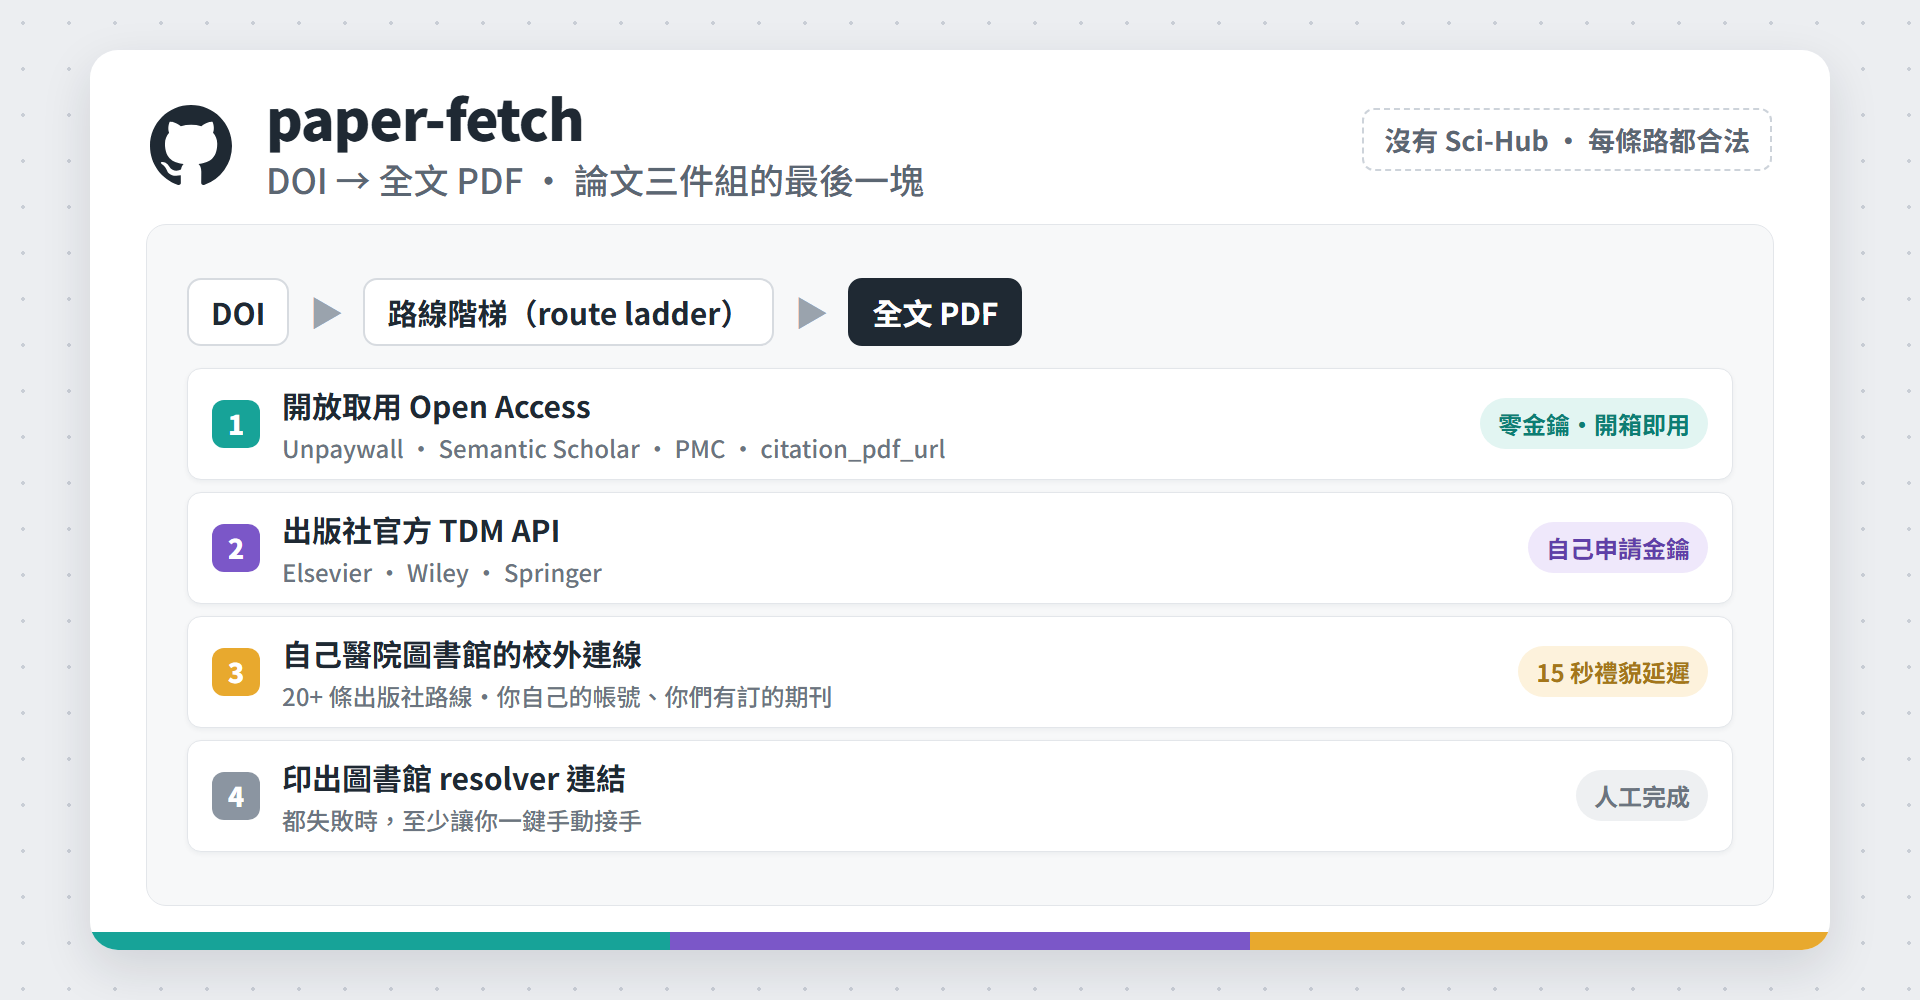
paper-fetch 的 GitHub 風格封面卡,畫出四層路線階梯:開放取用、出版社官方 TDM API、自己醫院圖書館的校外連線、印出圖書館 resolver 連結

論文三件組的最後一塊:paper-fetch,給它一個 DOI,它自己去把全文抓下來

前陣子分享的論文評讀工具(讓 Claude 幫忙做品質評讀跟內容整理),有朋友回我一句很實在的話:工具是好用,但每次都得自己先去把 PDF 生出來,最煩的其實是這一步。 真的是這樣。要讓 AI 幫你讀論文,你得先拿得到全文。而拿全文這件事,卡住的通常不是 AI,是權限、是出版社、是圖書館。 所以論文三件組裡最後一塊、也是最痛的一塊,今天終於補上了:paper-fetch(MIT 開源)。給它一個 DOI,它會自己走完整條路,把全文 PDF 抓下來。 階段 工具 做什麼 發現 論文學習雷達 paper-radar RSS/PubMed 餵新論文,依興趣排序 下載 paper-fetch DOI → 全文 PDF 評讀 paper-review-and-digest 品質評讀、內容整理 — 它怎麼運作?一道由便宜到麻煩的階梯 整個設計只有一句話:先走最便宜、最正當的路,失敗才往下掉。 第一層:開放取用(open access) Unpaywall、Semantic Scholar、PMC/Europe PMC,還有藏在文章網頁裡的 citation_pdf_url meta tag(那正是 Google Scholar 拿來索引 PDF 的東西)。這層零金鑰、開箱即用,你只要在設定檔填自己的 email。沒有圖書館資源的人,能接的來源我都接上去了。 第二層:出版社官方的文字探勘 API(text-mining API) Elsevier、Wiley、Springer 都有正式開放給文字探勘用的 API,自己去申請一把金鑰就好,是完全被允許的管道。這層跟盜版一點關係都沒有,只是大家很少知道它存在。 第三層:自己醫院圖書館的校外連線 用你自己的帳號登入,抓你們醫院本來就有訂的期刊。它只是把你原本會手動做的那一串點擊自動化,不是繞過付費牆。 第四層:投降,但投降得有用 全部失敗的話,它會把圖書館的 SFX/OpenURL 連結印出來讓你手動去點,而不是丟一個 error 就沒了。 沒有 Sci-Hub,沒有盜版路線。 每一層都是你本來就有資格走的路。 — 最花時間的是什麼?把每一家出版社的脾氣摸清楚 這是我覺得整個專案最值得分享的部分。DOI 換 PDF 聽起來像一行程式,實際上每家出版社的做法都不一樣,而且沒有文件可以查,只能一篇一篇撞出來。目前摸清楚、而且用真實文章驗證過的有 20 幾條路線,收斂成四種形狀。 ...

July 14, 2026 · 2 分鐘 · 225 字 · 陳柏威 Po-Wei Chen