loan-invest-sim 信貸投資模擬器:勝率與風險分布

信貸投資勝率九成?這題我從 PGY 就開始算

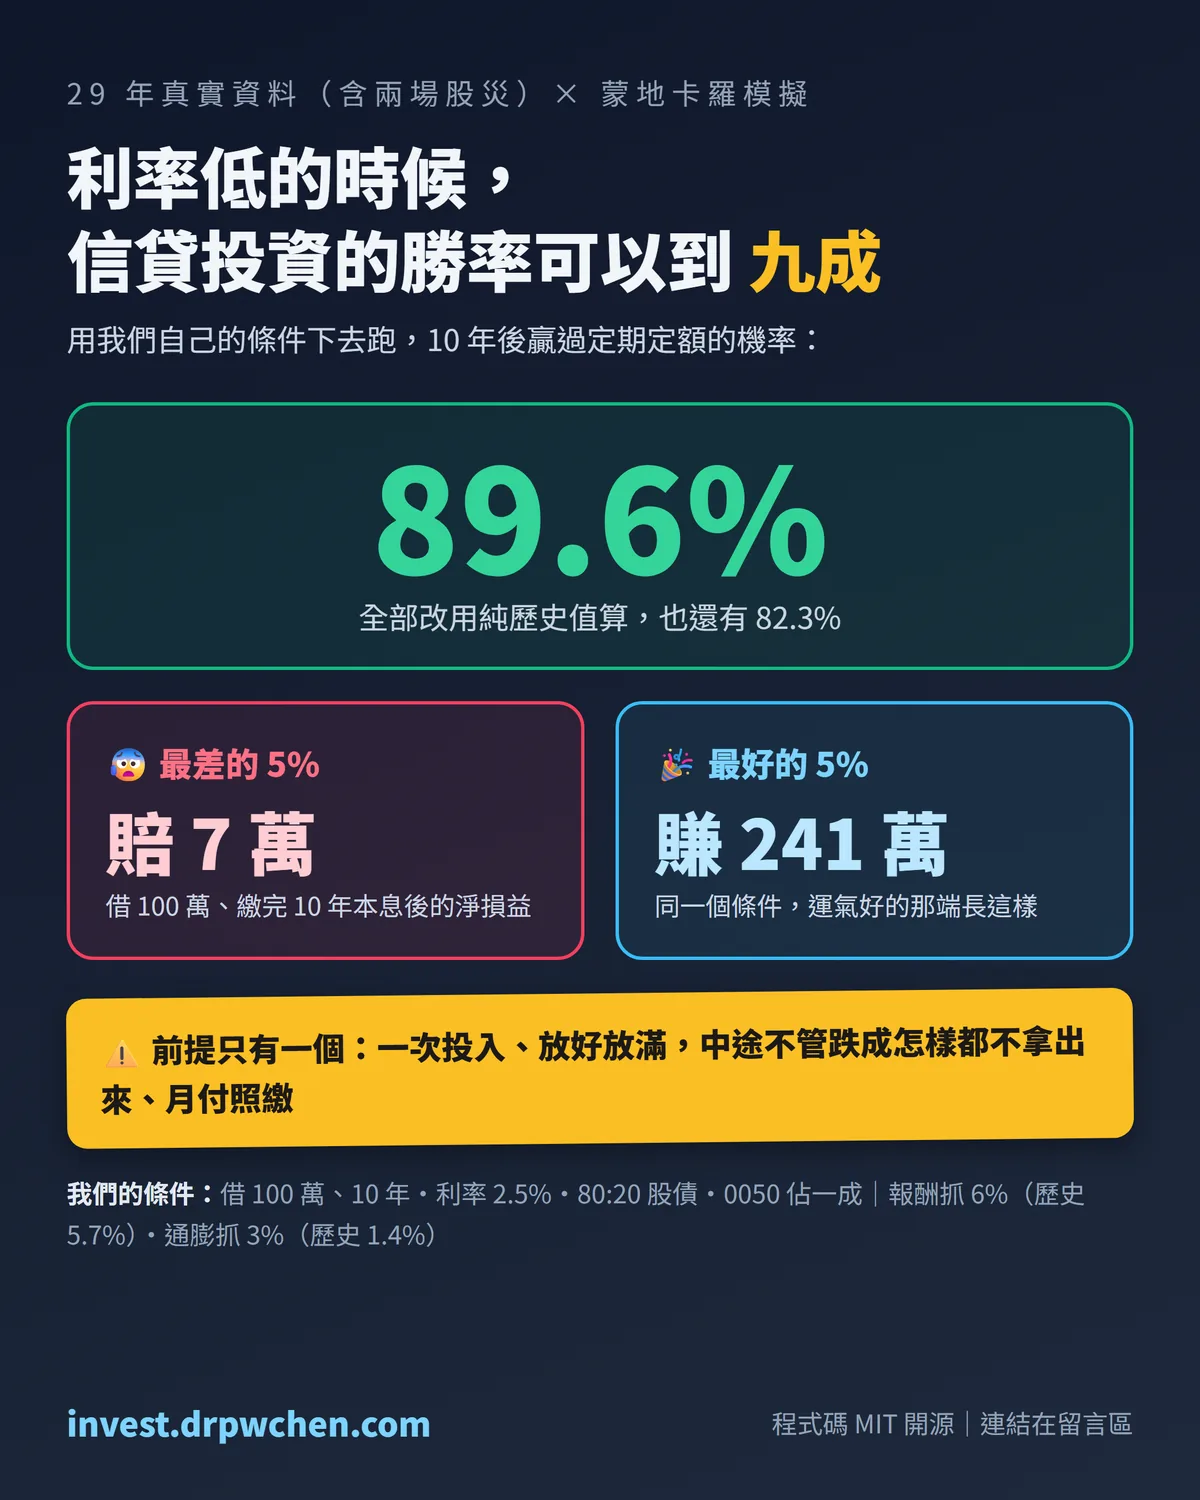
先說結論 我們自己的做法是:月薪 5 萬的人,借 100 萬、10 年期、利率 2.5%,一次全部投入,配置抓 80:20 股債比,其中 0050 佔總資產一成,其餘是全球股債 ETF。假設是這樣抓的:這個配置的歷史序列(1997 年起、含亞洲金融風暴與網路泡沫,後面方法段會講)實質年化報酬是 5.72%,我們抓 6%,比歷史略高一點;通膨歷史平均 1.4%,我們抓 3%。這兩個假設各自把勝率往哪邊推,文章後面會誠實拆開來給你看。評估年限跟貸款年限一樣,10 年。 用真實市場資料模擬兩萬條路徑,結果是: 89.6% 的路徑,最後贏過「不借錢、把同樣月付金拿去定期定額」 中位數淨賺 83 萬,最好的 5% 淨賺 241 萬,最差的 5% 是倒賠 7 萬 而最值得看的是這個:就算落到最差的 5%,也只比定期定額少 10 萬;而最好的 5% 是多 145 萬 下檔輸的幅度很小,上檔贏的幅度很大——這才是這件事真正的樣子,不是「勝率九成」四個字。 先講清楚這個 89.6% 該怎麼讀 它是兩萬條隨機路徑跑出來的估計值,本身帶有抽樣誤差:二項標準誤約 ±0.2 個百分點,95% 區間大約是 89.2% 到 90.0%。換一組亂數種子,小數點後那一位就會跳動。所以請把它讀成「約九成」,不要讀成精確到 0.1%。這篇文章後面所有的數字都適用同一句話。 以下先把完整的報告講完(我們的條件、結果全貌、方法與前提、誰不該做),最後再講這題我是怎麼用 AI 算了三遍、又怎麼發現 AI 算錯的。 完整報告 結果全貌:從最好到最差,一次攤開 先看這筆交易到底賺不賺。下圖的淨損益 = 期末實質資產 − 你為貸款付出的實質成本,從最差的 5% 到最好的 5% 整個範圍攤開(都是換算成今天購買力的實質金額): ...
August 8, 2026 · 3 分鐘 · 584 字 · 陳柏威 Po-Wei Chen
讓 AI 自己調查自己為什麼一直犯錯:違規計數器 vs 週稽核全數通過的對比

讓 AI 自己調查自己為什麼一直犯錯

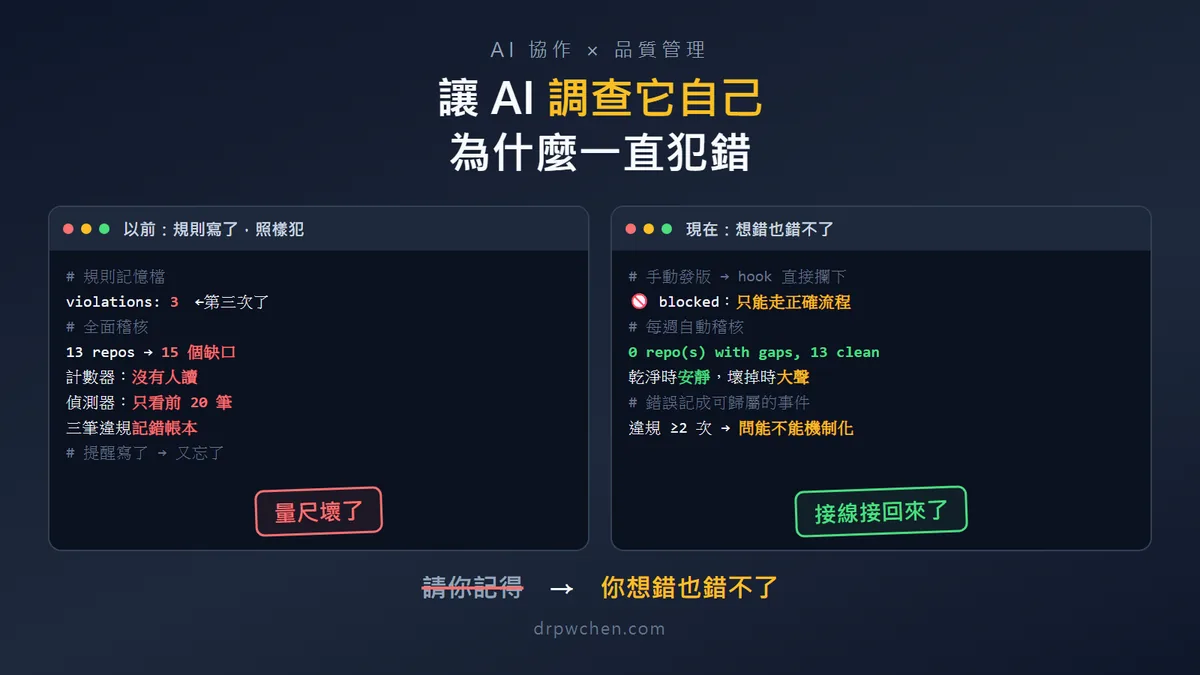
用 AI 工作一陣子的人,大概都遇過這件事:同一個錯,你講過了,規則也請它記下來了,過幾天它又犯一次。 而且我不是沒有防:規則寫進了它的記憶檔、違規有計數器、還有每月的定期檢視,該有的機制都在。但七月底,我看著我的 AI 助理第三次犯下同一個錯(最後兩次只隔一天),才認真面對一個事實:「記得」跟「會做」是兩回事。而更意外的是,後來的調查發現,問題甚至不在它不記得,是我們整套「記錯誤」的系統,量尺本身壞掉了。 這篇想分享的,就是我們最後長出來的一套「AI 自我糾錯系統」的設計,以及中間最有趣的一段:我讓 AI 自己調查自己,還特別交代它「不要相信寫交班單的那個 AI」。 事情是怎麼爆開的 這陣子我陸續把一些自己做的工具開源(工具箱總整理裡的那些)。發布開源軟體有一套禮儀:改了什麼要寫進更新紀錄(CHANGELOG)、打版本標籤(tag)、在 GitHub 上建立正式的發布頁(release)。這些規則早就寫在 Claude 的記憶檔裡。 七月底某天,我點開一個剛發布新版的 repo,首頁看起來什麼都沒有。我第一反應是「你沒寫 CHANGELOG」。它查了之後回報:CHANGELOG 其實寫了,tag 也打了,漏的是最後一步「建立 release」,而那恰好是訪客唯一看得到的一步。回頭一查,前兩個版本也都一樣。 隔天我請它把我全部十三個公開 repo 掃一遍,結果挖出十五個同樣的缺口。更妙的是,就在稽核到一半的時候,它又犯了第三次同型的錯。規則就寫在它的記憶裡,它也讀得到,然後照樣犯。 關鍵的一問:「你以後真的會用嗎?」 它的第一個提案很自然:寫一支腳本,把正確的發版流程整個包起來。 我問了一句:「你以後會固定呼叫這支腳本嗎?」 它想了一下,誠實地說:不會。腳本跟記憶檔的失效模式一模一樣,都要它先「想起來」才有用。這個答案讓我們改變了做法:與其多一個要記得的東西,不如加一道攔截(hook,上手系列第二篇講過的關卡概念):只要它想手動跑發版指令,動作會在當下直接被擋下來,只剩包好的正確流程能走。從「請你記得」變成「你想錯也錯不了」。 讓它調查自己,但不准相信自己 前面說過,揪錯的零件一直都在。所以問題比「沒有機制」更刁鑽:零件都在,錯還是溜過去了,到底卡在哪? 這裡我們用了一個我很喜歡的設計。當天犯錯的那個 AI session 把來龍去脈寫成一份調查交班單,但裡面明白寫著一條: 交班單裡的自我迴避條款 「不要把我的假設當成計畫——這份文件是犯錯者本人寫的,幾乎必然被它的立場影響。請先獨立驗證診斷,再決定要不要建任何東西。」 接著換一個全新的 session 接手調查,手上只有可以重跑的驗證指令,沒有前一位的結論。 做過品質改善的人應該覺得眼熟:根本原因分析(root cause analysis)的調查,本來就不該由事件當事人自己主導。當局者迷這件事,對 AI 一樣成立。 調查結果:推翻了兩個前提 獨立調查翻出來的東西,跟交班單猜的不一樣。 第一,AI 並沒有隱瞞錯誤。我原本合理懷疑:違規次數是它自己記的,它會不會少記?結果翻遍紀錄,低報只有零星幾筆,而且是「自首了但記錯地方」。其中一個規則檔裡,它老老實實記了十二次違規,好幾次我根本沒發現。誠實度不是問題。 第二,問題出在量測層。幾個具體的發現: 計數無法歸屬:違規次數記在「檔案」上,但一個檔案裡合併了十幾條規則。帳面上的「違規 4 次」,追不回是哪一條規則的 4 次,這個數字沒有行動意義。 偵測器本身有 bug:負責從歷史對話裡撈「使用者糾正過什麼」的程式,寫死了只看最近二十筆,而且漏看一整類訊息格式。回頭驗證時發現,最關鍵的那筆證據,它從結構上就不可能抓到。 記錯帳本:有三筆真正的違規,被寫進了另一本記「工具摩擦」的帳,正好躲過所有檢查。 還有一個反轉:交班單斷言「這些計數完全沒有版本紀錄,無從稽核」。錯了——記憶目錄其實一直有自己的 git 版本庫,一千多筆自動存檔,稽核軌跡從頭到尾都在,只是被上層設定蓋住,連 AI 自己都不知道。 換句話說:這個系統不缺零件,缺的是接線。計數器沒有人讀、偵測器壞著、帳本記錯棚。在量尺壞掉的情況下加更多自動化,只是把錯的數字算得更快而已。所以後面的修法幾乎沒有新建什麼大東西,都是把既有的零件接起來。 最後的設計:四條原則 修完之後,整套系統收斂成四條原則。它們不是 AI 專用的,你會發現每一條在醫院的品質管理裡都有對應物。 一、錯誤要記成「可歸屬的事件」,不是一個數字。每次違規記一行:日期+哪一條規則+一句事實。計數是用數的,不是用手改的。(對應:異常事件通報寫事件經過,不是只在統計表上加一。) ...

August 1, 2026 · 1 分鐘 · 99 字 · 陳柏威 Po-Wei Chen
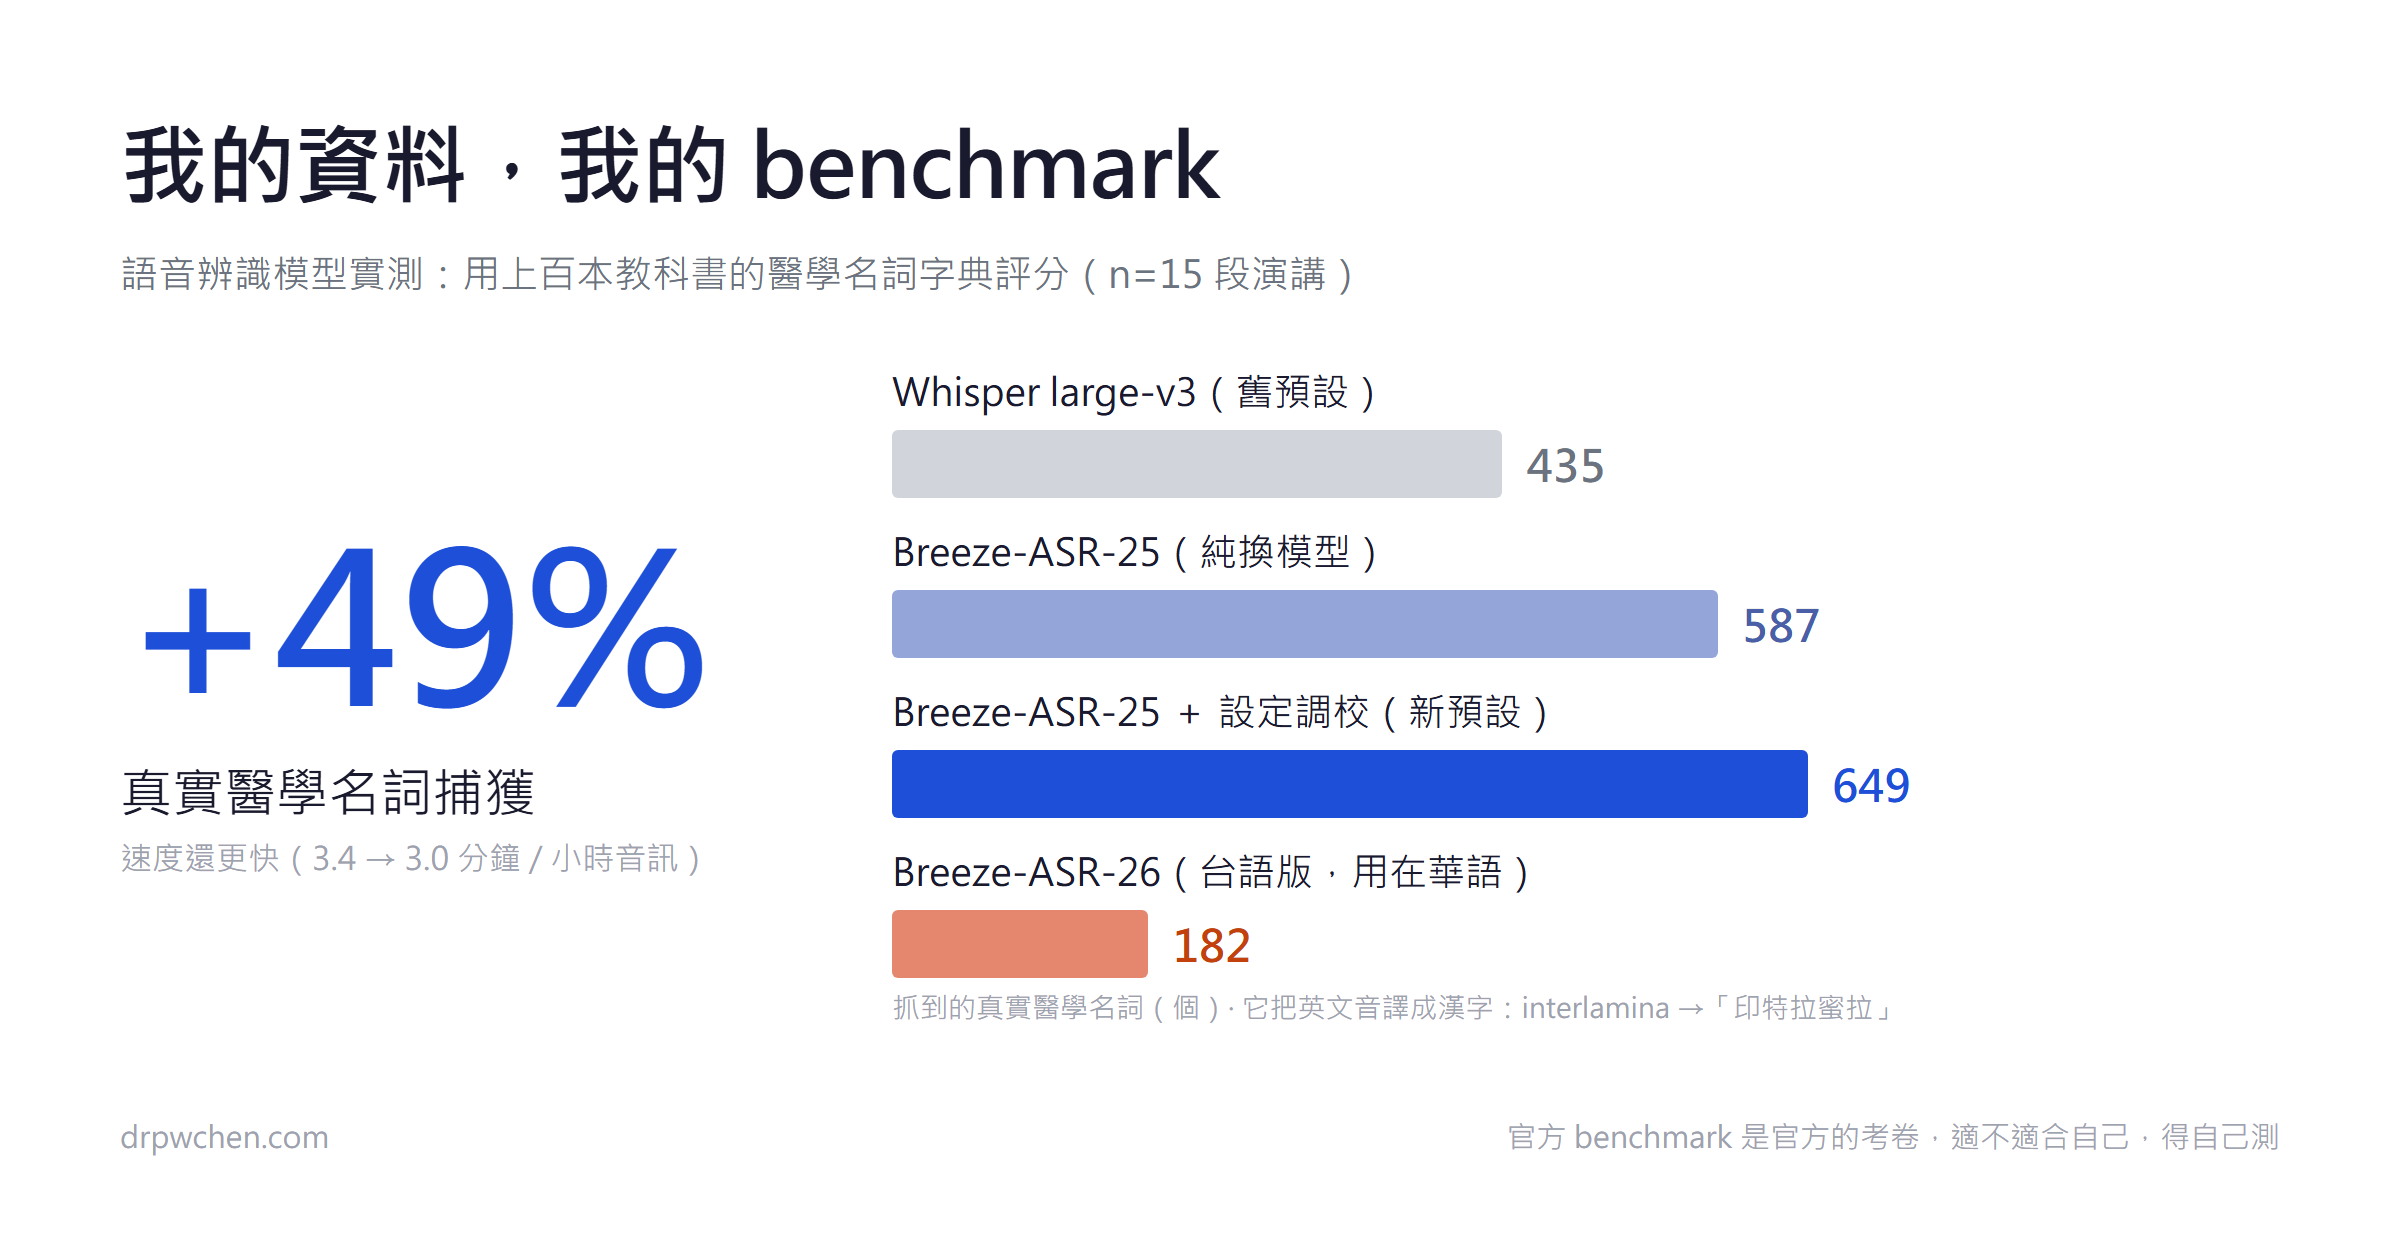
ASR 模型實測結果:Breeze-ASR-25 加設定調校後真實醫學名詞捕獲 649 個,比 Whisper large-v3 的 435 個多 49%;台語版 Breeze-ASR-26 用在華語只有 182 個

我的資料,我的 benchmark:幫演講筆記系統換一顆語音辨識引擎

引言:為什麼官方分數不夠用 我把演講錄影變成筆記的流程是這樣一條線:逐字稿 → 對應投影片 → 總整理。 這條線的地基是語音轉文字(automatic speech recognition,ASR)。它聽錯多少,後面每一層筆記就跟著錯多少。原本我用的是 OpenAI 的 Whisper large-v3。 這件事的起點,其實是我滑手機看到聯發科(MediaTek Research)發表台語模型 Breeze-ASR-26。 台語模型本身就夠讓人好奇了,但點進去才知道,原來他們去年就出過 Breeze-ASR-25,從 Whisper-large-v2 微調,專門針對台灣華語和中英夾雜優化,Apache 2.0 開源。醫學演講正好是中英夾雜的重災區,我居然錯過了一整年。 於是我同時面對兩顆模型,而它們的官方資料是完全不對稱的。 Breeze-ASR-25 給了一整張成績單,字錯率(word error rate,WER,越低越好): 資料集 Breeze-ASR-25 Whisper-large-v3 Whisper-large-v2 CSZS-zh-en(中英夾雜) 13.01 26.43 29.49 ASCEND-MIX(中英夾雜) 16.38 25.13 21.01 ASCEND-ZH(華語) 16.04 17.41 17.49 CommonVoice16-zh-TW(台灣華語) 7.97 8.95 9.84 ML-lecture-2021-long(長音檔演講) 4.98 6.41 6.13 (官方欄位寫的是 WLV3-Auto/WLV2-Auto,也就是開啟自動語言偵測的 Whisper。) 它連我當時在用的 large-v3 都贏,中英夾雜那兩列更是壓倒性。這部分我沒有必要再證明一次。 而 Breeze-ASR-26 呢?它只有台語一項成績——但那一項做得很紮實。 官方拿它跟四個系統比台語字元錯誤率(character error rate,CER,越低越好): 系統 台語 CER Breeze-ASR-26 30.13 教育部台灣台語輸入法 30.70 雅婷逐字稿 32.11 Google Gemini 3 Flash 32.52 Breeze-ASR-25 49.99 它在台語上贏了 Gemini 3 Flash,也贏了雅婷。 這是真本事,不該被忽略。 ...

July 13, 2026 · 4 分鐘 · 693 字 · 陳柏威 Po-Wei Chen
把圖檢索加進醫學筆記庫

把圖檢索加進我的醫學 LLM Wiki,這次真的有用了

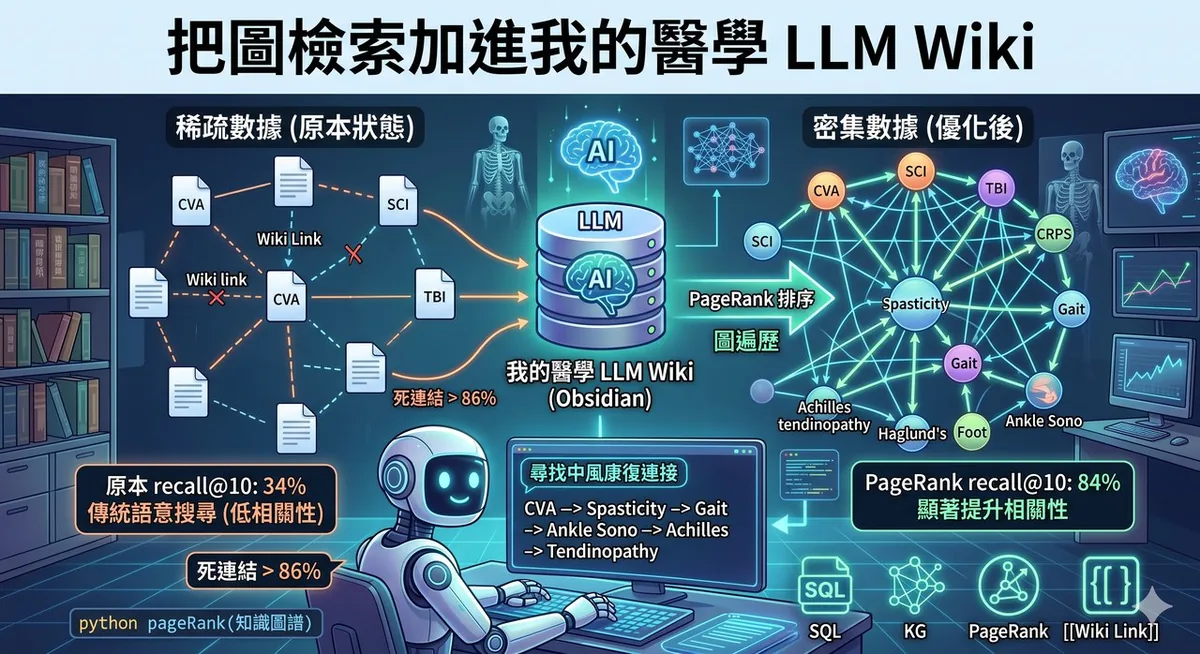
背景:我本來就在用的東西 念專科考試的時候,我給自己弄了一套 RAG(Retrieval Augmented Generation),用「看相似度」的語意搜尋(semantic search)把幾百本復健科教科書跟我自己的筆記變成可以查、可以問的東西。一邊在 Obsidian 裡讀書用,一邊讓 Claude 透過 MCP 也能找到我要的東西。 它目前最弱的地方,就是「跨文獻把知識串起來」。所以前幾天看到有人分享一篇剛發表的論文 SAG(SQL-Retrieval Augmented Generation),說可以在語意搜尋之外加上結構化查詢語言(SQL)跟圖的概念,讓跨文獻搜尋更容易,效果類似 GraphRAG 但更好維護、更好建立,我整個眼睛一亮。 在這時代想當然爾,就是把論文連結丟給 Claude,請他去讀論文、抓原作者的 GitHub、讀懂作法,然後用我自己的資料把整條管線複現出來、實際跑 benchmark XD 論文:Wu et al., SAG: SQL-Retrieval Augmented Generation with Query-Time Dynamic Hyperedges, arXiv:2606.15971。程式碼:github.com/Zleap-AI/SAG-Benchmark 第一步:選模型(RTX-3070 的眼淚) 整條管線裡最關鍵的一步,是用 LLM 把每段文字抽成「事件 + 實體」存進資料庫。原論文用 Qwen,我就比了本地的 Qwen(qwen3.5:4b)跟線上的 Claude Haiku。 結果 Haiku 萃取資訊的能力明顯比較好,實體圖更密、命名更一致(這對後面用 SQL 串很重要),而且看起來很便宜。這跟我先前的經驗相符,可能我的 RTX-3070 真的太弱了,稍微大一點的模型就跑不動(時代的眼淚阿),直接用 Haiku 又快又好! 順帶一提,我沒有 API 訂閱也能用 Haiku:直接派 Claude 的 subagent 去做,跑在既有額度內就好。 教科書上的三個發現 我用神經復健的教科書當測試語料,設計了一批臨床問題,拿 SAG 跟原本的語意搜尋正面對決。結果分三關: 第一關,單一本書:打平。語意搜尋已經夠強,多跳機制沒用武之地。 第二關,跨書、但問題裡把關鍵字都寫白了:還是打平。因為問題裡已經把「中風、脊張力、步態」全寫出來,語意搜尋自己就把相關段落都撈回來了。 第三關,跨書、但只問一端、中間那跳故意不講(例如只問「馬蹄內翻足怎麼處理」,期待它自己連到背後的脊張力機轉跟治療):SAG 終於贏了,而且贏很多。 ...

June 22, 2026 · 2 分鐘 · 412 字 · 陳柏威 Po-Wei Chen