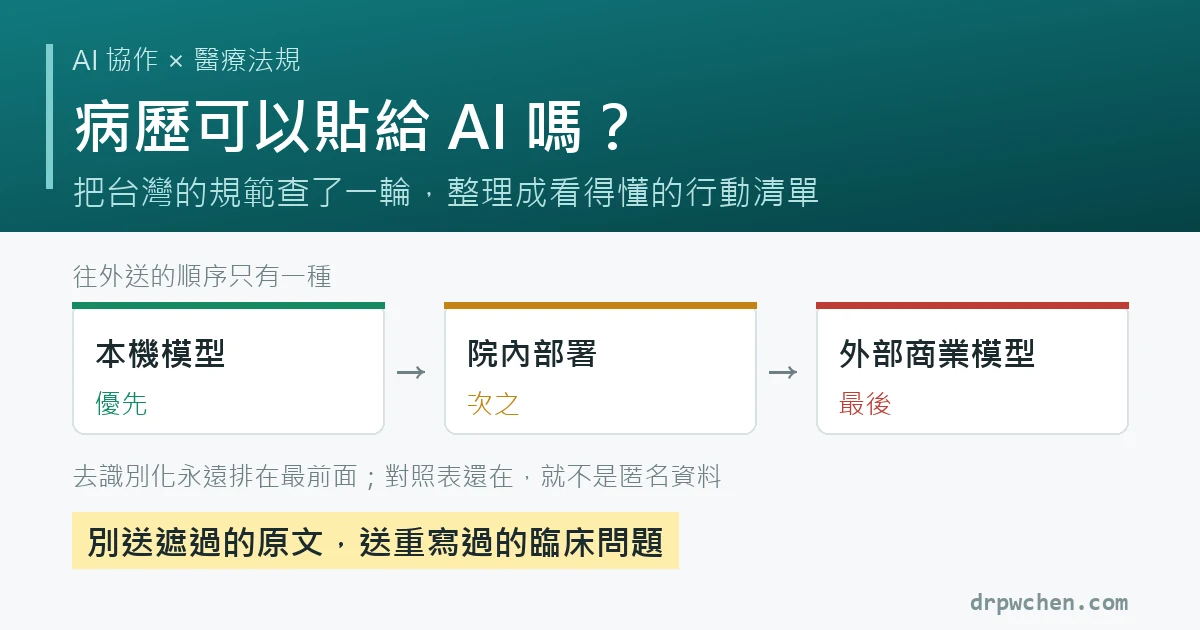
病歷可以貼給 AI 嗎?我把台灣的規範查了一輪
先講結論,五句話: 用腳本自動化批次抓病歷,不是灰色地帶。只在臨床照護必要範圍、只碰自己照護的病人、用完不留存,跨過這條線,法規要求醫院留得下每一筆存取與複製紀錄。 台灣沒有 HIPAA 十八項那種清單。我們的標準是「無從辨識特定個人」這個結果,刪滿十八項不等於完成去識別化。 只要還原用的代號對照表還在你電腦裡,你手上那份遮完的病歷就不能當匿名資料看,它仍有間接識別的可能,屬於假名化而不是匿名化。 往外送的順序只有一種:本機模型優先,院內部署次之,境外商業模型最後,而且送之前要先看自己醫院的規範。 真的要往外送,別送「遮過的病歷原文」,送「重寫過的臨床問題」。讓一段紀錄被還原的不是欄位,是敘述的唯一性。 下面把推論過程攤開。 這篇的起點,是上一篇 chart-scrub(病歷去識別化工具)發文後,黃祥瑋醫師在留言提了兩件很重要的事:一是自動化把病歷抓下來收集通常是違規的,只是看醫院有沒有在抓;二是即便符合 HIPAA 十八項,他個人還是不會把資料送到雲端或境外。 這兩句都站得住,而且背後都有具體的法源。我把條文一條一條查回全國法規資料庫核對現行版本,順著「抓病歷、遮病歷、送病歷」這條動線整理在下面。 一、抓病歷:法律看的不是工具,是範圍 用 AutoHotkey 複製跟手動 Ctrl+C 複製,在法條上沒有分野。法律真正在意的是範圍:你抓的是不是自己照護的病人、是不是照護必要、抓完有沒有留下來累積。 先講最實際的一層:這件事留得下紀錄。醫療機構電子病歷製作及管理辦法(111 年 7 月 18 日修正)第 13 條要求,病歷的存取、增刪、查閱、複製,連同執行人員、時間、內容,都要保存完整紀錄;第 4 條還要求系統要有異常使用的因應措施。誰在什麼時間複製了哪些內容,法規要求院方必須留得下來。至於院方實際能看到多細、能不能直接算出你複製了幾筆,要看各院 HIS 與稽核設定,條文不保證這件事。祥瑋說的「看醫院有沒有在抓」,制度上就是這個意思:痕跡一定在,抓不抓是各院的執行。 而且實務上最先找上門的,通常是自己醫院,法院排在很後面。醫院這幾年一直被要求把資安做起來(醫院屬於資通安全管理法的「緊急救援與醫院」關鍵基礎設施領域,個別醫院可經衛福部指定為關鍵基礎設施提供者,被指定的要提出資安維護計畫),端點監控與異常告警愈做愈普遍。醫院也有義務管人:醫院個人資料檔案安全維護計畫實施辦法要求總床數一百床以上的醫院(公立醫院準用)依業務需要設定存取權限、跟所屬人員約定保密義務、把個資使用紀錄至少留存六個月。批次抓病歷最可能的劇本,是資安告警、約談、院內懲處,一路都還沒碰到刑法。 那刑法呢?大家最常聽到的是刑法第 359 條,這條值得把構成要件講完整,因為它常被簡化成「用腳本抓就是犯罪」,那不是條文寫的。它要同時滿足三件事才成立。第一是「無故」:取得紀錄欠缺正當理由。臨床照護必要範圍內調自己病人的病歷,是有授權的;超出照護必要、碰到不是自己照護的病人,授權基礎才會被質疑。第二是取得的要是「他人」電腦系統的電磁紀錄:帳號是你的,不代表資料是你的,你對那批資料有沒有處分權限要個案認定。第三是「致生損害於公眾或他人」:這個獨立要件最常被漏掉,成立與否要能說明損害是什麼,複製了不等於當然有損害。所以用自己的帳號不等於免責,大量複製也不等於當然犯罪,中間那片灰色地帶,不值得拿職業生涯去測試。我沒有找到醫師用本人 HIS 帳號批次下載病歷的公開判決,這裡只能講風險方向,不能講定論。 最後一層是個資法。病歷是個資法第 6 條的「特種個資」,原則禁止蒐集、處理、利用,只有六款例外能開門(例外長什麼樣,第四節講研究的時候會攤開)。臨床照護本身有法源,這不是問題;問題出在「抓下來累積成一個資料集」的那一刻:複製、儲存、輸出在個資法上都算「處理」,從那一刻起你就需要一個答得出來的例外,而「我自己想研究」不在清單裡。 所以抓病歷的安全範圍就是一句話:只在臨床照護必要範圍、只碰自己照護的病人、用完不留存。自動化只是把這件事做快,沒有改變它的性質;範圍守得住,工具隨你選。 二、什麼才算「去識別化」 台灣看結果,不看清單 先介紹 HIPAA 十八項。HIPAA 是美國 1996 年的《健康保險可攜性與責任法案》,它的 Safe Harbor 規則列了一張清單:姓名、比州更小的地理區域、跟個人有關的日期、電話、Email、身分證號、病歷號、保險號、帳號、證照號碼、車牌、裝置序號、網址、IP、生物特徵、臉部照片、其他任何唯一識別碼,十八類刪乾淨,再加一個常被忘記的第二條件:機構沒有實際知情,認為剩下的資訊單獨或與其他資料結合仍能辨識個人。兩個都滿足,法律上就「視為」完成去識別化(地理與日期各有細節例外,這裡不展開)。它最大的好處是可操作:照清單做完,大部分情況就有明確依據,不用逐案猜。 台灣沒有這張清單。我們的門檻在個人資料保護法施行細則第 17 條,寫的是「以代碼、匿名、隱藏部分資料或其他方式,無從辨識該特定個人」。那是結果標準,不是清單標準:法律不管你刪了幾個欄位,只問最後那段文字指不指得回一個人。刪滿十八項,不等於在台灣已經完成去識別化。 復健科的人對這件事要特別有感。罕見診斷,加上特定術式,加上就診年月,加上哪一家醫院,四項湊起來常常就足以回推到一個人,而這四項沒有一項在十八項清單裡。真正把人認出來的,常常是整段敘述的唯一性,而不是某個特定字串。 這個結果標準的天花板,是憲法法庭 111 年憲判字第 13 號,就是 2022 年 8 月的健保資料庫案。它講的去識別化標準,理由第 54 段的原文是「使一般人採取當時存在技術與合理成本,在不使用額外資訊時,不能識別特定當事人」。要注意這份判決審查的對象:它處理的是個資法第 6 條第 1 項但書第 4 款下的健保資料庫利用,所以才會一併要求限定醫療衛生目的、限定主體(公務機關或學術研究機構)、統計或學術研究的必要性,以及獨立監督機制。這是那個案子的整組理由,不是任何人把病歷去識別化之後都要打勾的通用條件。不過放在那個脈絡下讀,方向仍然很清楚:去識別化本身不是免死金牌,它是跟目的限制、監督機制包在一起才站得住的。個人把去識別化的資料丟給境外商業模型,這兩個配套剛好都是零。 ...
