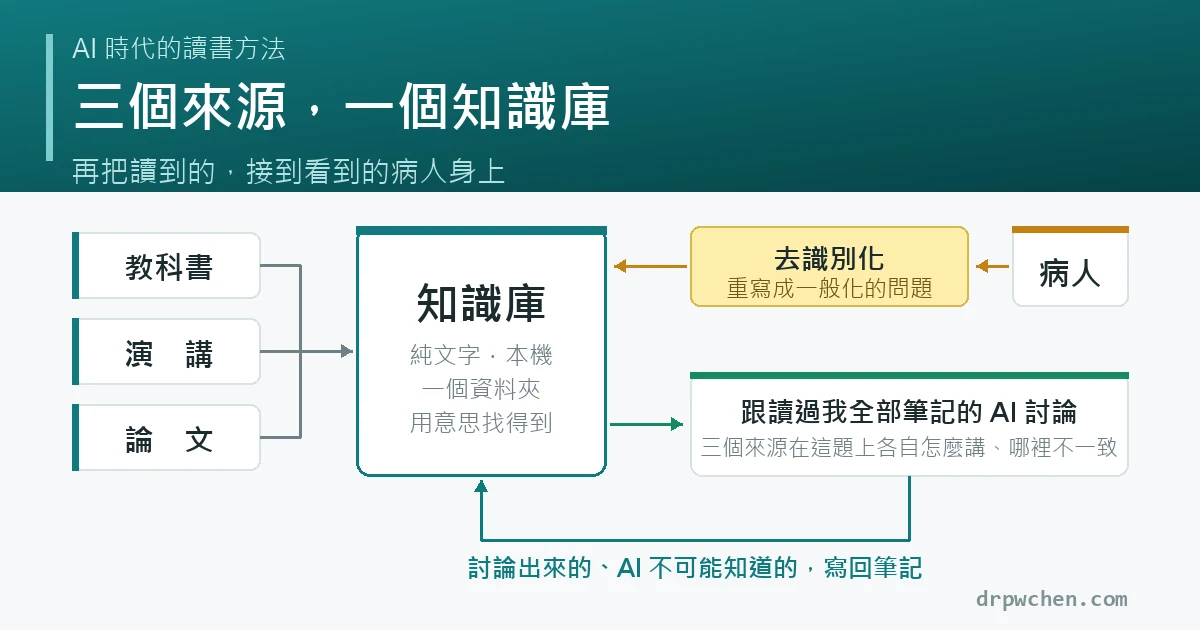
我 3 月開始用 AI,6 月考過專科。考完之後它沒有停在考試那裡,慢慢變成我平常讀書的方法。這幾個月下來,做法分散寫在好幾篇工具文裡,每篇都只講一條產線,沒有一篇講它們合起來是什麼。這篇就是那個骨架:三個來源怎麼進同一個知識庫、庫建好之後怎麼把讀到的接到看到的病人身上、還有用 AI 學習的時候哪些事要留給自己。工具怎麼裝、法規細節怎麼查,都留給已經寫過的文章,這裡只給結構跟判斷。
一、三個來源,一個知識庫
臨床上會讀的東西就三種:教科書、演講、論文。以前這三種東西各自散在書架、手機錄音跟一堆下載下來的 PDF 裡,讀過就過了,要用的時候找不到。現在三條產線各自有工具,落點都是同一個地方。
教科書。專科指定參考書四十多本,同一個概念散在好幾本裡,我把自己做筆記的方法調教給 AI,讓它有根據、有頁碼地整理,這套寫在跨教科書自動筆記生產流程那篇。
演講。教室後面那片腳架森林錄下來的影片,多數人不會回去看第二次。我的做法是本機轉錄、抽投影片、整理成筆記,寫在 lecture-to-notes 那篇。
論文。這條最長,拆成三件工具:論文雷達每天自動抓、照我的興趣排序;paper-fetch 給它一個 DOI 就把全文抓下來;讀論文的 skill 把 journal club 那套評讀流程交給 AI,證據等級的判斷用小程式算,不讓它靠印象。
三條產線各自能用,但真正有意思的是它們的出口是同一個資料夾:一個純文字的 Obsidian vault,放在我自己的機器上。三種來源不是三套筆記,是一個庫。 這件事帶來兩個以前沒有的能力:
- 用意思找,不用記字。幾個月前讀到的東西,你不會記得當時用了什麼字,語意搜尋(semantic search)解決的就是這個,寫在會用意思找筆記的第二大腦那篇。
- 找相關的筆記。同一個主題,教科書那章、某場演講、最近一篇論文,它們之間本來沒有連結。加了圖檢索(graph retrieval)之後,找對相關筆記的比例從三成多升到八成多,細節在把圖檢索加進我的醫學 LLM Wiki。
這一切的前提是筆記得先是純文字、放在本機、任何工具都讀得到。我從 Evernote 搬到 Obsidian 的三年追蹤報告講的就是這個決定,那篇有一句話到現在還是對的:轉檔只是開始,真正的工作在轉完之後。
所以第一段的結論很短:讀到的東西不要讀過就算,要進庫。 三條產線只是讓「進庫」這件事不再花時間。
二、把讀到的,接到看到的病人身上
庫建好之後,考試考完之後,它的用途才開始。
以前讀書跟看病人是兩件事。書在書上,病人在診間,中間那條線要靠自己的記憶去接,而記憶會掉。現在多了一個做法:門診遇到的狀況,跑出問題,拿去跟 AI 討論,而 AI 讀的是我自己的庫。 它變成一個讀過我全部筆記的 consultant。
舉一個虛構的例子。一位七十多歲的女性,兩邊肩膀痛了大半年,之前打過幾次針,每次打完鬆一陣子,過幾週又腫回來,回診時肩膀還是脹的,手抬不過肩。X 光看起來就是很嚴重的退化。門診當下我會想幾件事:兩側一起來、抽掉又積回來的肩膀,還算不算單純的退化性關節炎、關節液抽出來要送哪幾項、之前聽過的某場肩關節演講講者說他自己遇到會先看什麼、最近有沒有論文比較過保守治療跟介入的結果。
這四個問題以前要翻四個地方。現在我把狀況重寫成一段一般化的描述,丟給 AI,請它從我的庫裡把教科書那章、那場演講的筆記、那篇論文的評讀一起找出來,對照這個問題。它回來的不是標準答案,是三個來源在這個問題上各自怎麼講、哪裡一致、哪裡不一致。判斷還是我的,但那個「翻四個地方」的時間省下來了,而且庫裡的東西因為被病人用到,才真的記得住。
這個例子對照出來的東西,教科書那條線最有話說。X 光看起來的「嚴重退化」本身就是線索:這一組表現指向的是 Milwaukee shoulder,老年女性、六成兩側、關節液抽出來量大又常帶血色,而 X 光的特徵是骨刺很少、破壞卻很重,跟原發性退化性關節炎骨刺多、破壞慢的樣子剛好相反。接下來要做什麼,教科書也寫得很清楚:先抽液送檢,驗細胞數、做結晶染色(鹼性磷酸鈣結晶不折光,偏光顯微鏡看不到,要用 alizarin red S 染),還有一定要一起送的細菌染色與培養,因為驗到結晶不能拿來排除感染。確認不是感染,關節內類固醇才進場;積液一直回填的,主力就是重複抽吸加注射。保守做滿了還是痛、手還是抬不起來,才是轉骨科評估逆置式人工肩關節置換(reverse shoulder arthroplasty)的時候。這一整則整理放在Milwaukee shoulder:反覆抽出大量積液的肩膀那篇。
送出去之前,有一道轉譯
上面那段有一個動作不能跳過:病人的狀況要先轉譯,才能拿去討論。
這裡容易犯的錯是以為把姓名跟病歷號換成代號就好。台灣的標準不是刪幾個欄位的清單,是「無從辨識特定個人」這個結果;而且只要還原用的對照表還在你手上,那份資料做的是假名化(pseudonymisation),不是匿名化(anonymisation)。這兩件事的法源、憲法法庭的判決、還有把資料往外送要過的三道關卡,我在病歷可以貼給 AI 嗎?我把台灣的規範查了一輪那篇逐條查過,這裡不重講。要把身分從病歷文字裡拿掉的工具在病歷不能就這樣貼給 AI那篇,它是第一道網子,不是保證。
對學習這個用途來說,有一個比「遮」更好的做法,而且剛好是法規文那篇的結論:不要送遮過的病歷原文,送重寫過的臨床問題。 上面那位肩膀的長輩,我要問 AI 的本來就是「老人家兩側肩膀反覆積液、打針只鬆一陣子,該想什麼」,這個問題不需要她的姓名、生日、哪家醫院、哪一天打的針。復健科的病歷特別容易從敘述本身認出人來,罕見診斷加上特定處置加上就診年月,三項湊起來常常就指向一個人,而這三項沒有一項是「欄位」。重寫成一般化的問題,唯一性在重寫的當下就被拆掉了。
而且這個轉譯本身就是學習。把一個活生生的病人重述成一個臨床問題,是 clinical reasoning 的第一步,這一步交給 AI 做反而可惜。
送出去的順序,法規文那篇也講清楚了:本機模型優先,院內部署次之,外部商業模型放最後;去識別化永遠排在最前面。學習用途的討論,多半走「重寫過的問題」就夠,根本不需要動到原始資料。
還有一件事要講準。衛福部 2026 年 5 月發布的「醫療機構應用生成式人工智慧指引」是行政指導,不是法律,適用對象是醫療機構。它把「個人研究、教育示範」跟「涉及真實病人資料或臨床作業流程」分開處理,前者參照指引原則辦理就好,後者屬於機構導入、建議走機構的評估流程。同一份指引也點名醫療機構的教育訓練應納入輸入安全(prompting safety)的觀念與實務操作。也就是說,「拿去識別化過的問題跟 AI 討論來學習」跟「在門診流程裡把真實病歷貼進 AI」,在指引裡是兩件事。分界怎麼畫、每一關看什麼,都在那篇法規文裡。
三、用 AI 學習,哪些可以外包、哪些不能
前兩段講的是把東西放進來、把病人接進來。第三段講一個更根本的問題:這樣學,會不會反而學不到?
先講一個讓我停下來想很久的研究結果。2026 年 7 月發表在 SSRN 的一篇追蹤研究,跟了中國一個縣兩萬六千多名七到十二年級的學生,追了三十個月,期間 AI 工具的使用率從接近零升到八成左右。結果是這樣:
| 指標 | 變化 |
|---|---|
| 作業分數 | +18% |
| 作業時間 | 64 分鐘 → 45 分鐘 |
| 月考成績(六個月內) | −20% |
| 升學考成績(兩年後) | −18% 到 −24% |
(數字取自 SCMP 與 The Decoder 的報導,預印本頁面目前無法直接開啟,作者全名我還沒核到,所以這裡只寫到出處層級。)
作業變好、考試變差,這個方向本身不算意外。真正值得記的是同一篇裡的另一句:作業時間跟不用 AI 的同學一樣長的人,考試沒有退步,作業還更好。 損失幾乎全部來自「把作業外包出去」的那群人。AI 本身沒有讓人變笨,是省下來的那 19 分鐘讓人變笨。
同一年 Brcic 與 Frljic 在 arXiv 上的一篇文章(The Effortless Trap)把機制講得更直接:同一個 AI 助手,改成不給答案、只給提示的版本,考試上的傷害就消失了。他們留下一句話,我覺得可以直接當判準:
如果讓 AI 進來之後,任務變得毫不費力,那它就放錯位置了。
程式領域也有對應的數字。Maier 等人 2026 年的 meta-analysis 整理了 23 篇研究,AI 輔助對生產力的效果量 g = 0.33,對學習的效果量 g = 0.14,而且後者不顯著。做得快跟學得會,是兩件事。
把這幾篇擺在一起,界線就出來了:
| 可以外包 | 不能外包 |
|---|---|
| 蒐集 | 投入 |
| 問答 | 整理 |
| 即時回饋 | 試錯 |
左邊三件事的共同點是,做完之後你腦袋裡不會多出東西,只是省下時間。右邊三件事的共同點是,它們本身就是學習發生的地方,外包出去就沒有了。
回頭看前面兩段,會發現它們剛好落在這條線的兩側。第一段的三條產線,做的全是「蒐集」:把書、影片、PDF 變成庫裡可查的東西。這是可以外包的,而且應該外包,因為那幾十個小時的轉檔跟切段,腦袋裡不會多出任何東西。第二段的「把病人重寫成問題」,是投入;「對照三個來源之後自己下判斷」,是整理跟試錯。這三件事我沒有交出去,也不打算交出去。
我準備專科考試那幾個月,AI 用得最多的三個地方,也都在左邊:
- 口試練習:我對著它講,它評分、指出哪裡漏了。講的人是我。
- 考古題:把題庫餵給它,叫它打亂順序考我,隔幾天再考一次。想答案的人是我。
- 整理教科書:四十幾本書的同一個概念散在好幾處,這件事交給它。讀進腦袋的人是我。
三個用法有一個共同的形狀:AI 站在回饋那一端,我站在投入那一端。 它從來沒有替我答過一題,但它讓每一次投入都有人接。
反過來的用法就是遇到不會的直接要答案。當下很順,但那跟研究裡外包作業的學生是同一件事:作業變好了,考試還是空的。所以我對自己的規則是:遇到問題時去問它、跟它討論、質疑它,而不是叫它給答案。 第一次自己想不出來的那段時間,就是研究裡說的那 19 分鐘,那段時間不能省。
四、AI 會的不用記,它不可能知道的才記
界線畫出來之後,筆記要記什麼就變得很清楚。
以前做筆記有一大半是在做「整理」:把教科書的某一章、某篇綜述的重點,用自己的架構重寫一次。這個動作在沒有 AI 的年代是必要的,因為不整理就找不到。現在教科書等級的整理已經可以交給第一段那三條產線了,問就有。
那我自己還要記什麼?答案是它不可能知道的東西:
- 自己的經驗:這個病人為什麼做了那個決定、後來怎麼樣了。
- 講師的經驗:演講裡講者順口說的「我在臨床上會這樣做」,那句話不會出現在任何教科書。
- 這個系統怎麼運作:醫院的 order 怎麼開、哪個科要怎麼會診、健保怎麼給付。這些每家醫院都不一樣,AI 不可能知道。
- 外面找不到的領域知識:小科、小技術、老前輩口耳相傳的那些。
- 靈光乍現的關聯:讀到 A 的時候突然想到 B。這個瞬間過了就沒了。
反過來說,可以快速取得的東西,不用花心思整理。醫學生時代那種把整章重抄一遍的筆記,我現在不做了。
這五類跟第二段其實接在一起。那位肩膀反覆積液的長輩,後來我決定先抽液送檢還是直接轉骨科、她三個月後怎麼樣了,這就是第 1 類;跟 AI 對照三個來源的時候突然想到另一個病人也是這樣,這是第 5 類。你記的不是知識,是知識跟你之間發生過什麼。 而這些東西要能發生,前提是那個病人真的被接回庫裡討論過。
五、怎麼跟 AI 一起維護筆記
庫會越長越大,筆記交給 AI 一起維護,有四條我踩過坑才定下來的規矩。
一個主題一則。 這條我在太多筆記,等於沒有筆記那篇講過,一句話帶過就好:同一件事有五個地方在講,等於沒有筆記。對 AI 來說這條更重要,因為它要改一則筆記的時候,得先找到對的那一則。五則同題的筆記,它改了其中一則,另外四則還是舊的。
筆記資料夾也開 git。 這條聽起來很工程師,但理由很生活:你要看得到它每次改了什麼。AI 動過的檔案,開 diff 一眼就知道它加了哪幾行、動了哪幾行。沒有這個,你只能相信它說的「我只有補充,沒有改動」。
每句盡量附來源。 哪本書第幾頁、哪篇論文。這不是學術潔癖,是因為筆記會越來越多,兩年後再看到一條數字,你需要知道它是從哪裡來的、要不要更新。附了來源的筆記,AI 也才有辦法幫你查「這條還是不是最新的」。第一段那三條產線出來的筆記每句都帶頁碼或 DOI,就是為了這一條。
新增便宜,改動昂貴。 這是四條裡最重要的一條。AI 更新筆記真正的風險,不是它漏掉新內容,是它會很安靜地改掉你舊筆記裡原本就對的東西,而你不會發現,因為輸出看起來仍然是一篇好筆記。漏掉可以回復,下次還會補;改壞不可回復,因為那條你已經查證過,不會再查第二次。新增的內容可以放行,改動既有內容的要先問過。這條怎麼做成工具,note-supplement 那篇有完整的設計。
有了這套方法之後
把五段收成一張圖。教科書、演講、論文三條產線把讀到的東西送進同一個庫;門診看到的病人狀況,去識別化、重寫成一般化的問題之後進來討論;討論裡冒出來的、AI 不可能知道的那些,寫回筆記;筆記變厚,下一個病人進來的時候能對照的東西更多。讀到的接到看到的,看到的又寫回讀到的,這是一個迴圈。
這樣做之後,讀書的時間沒有變少,但花的地方變了。以前一半的時間在整理,現在那一半拿去讀整理好的東西、拿去對著 AI 講一遍、拿去被它考、拿去把病人接回來。作業還是會變好,只是這次考試不會變差。