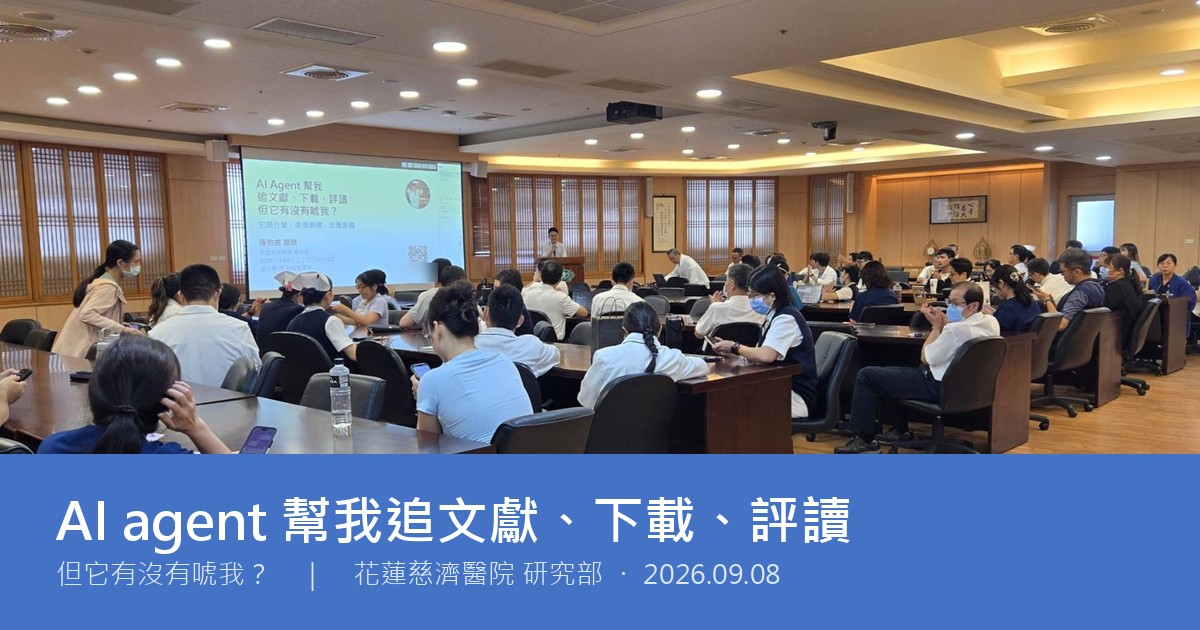
謝謝花蓮慈濟研究部的邀約,九月八號中午在協力樓和氣會議室講了一場 AI agent。中午時段還來了九十位左右,研究部、醫師、醫事人員、行政同仁都有,課前問卷收了 89 份,最擔心的三件事是「它講錯而我沒發現」、「個資會不會外洩」、「用了 AI 論文裡要怎麼寫」。所以這場就繞著這三件事排。
這篇把當天講的內容整理成文字版,給來聽的人回看,也給沒來的人一份完整版。課堂上有幾段因為時間被壓短了,這裡補完整。
AI agent 到底是什麼
用 AI 有三個層次。第一層是聊天框,把問題或論文貼給它,它回答你,資料要自己收集好、自己貼。第二層是 NotebookLM 這類,可以把一疊資料丟給它,它從固定的來源找答案。第三層才是 agent:它有手,可以開你電腦裡的檔案、跑程式、上網查、把結果存回你的資料夾。聊天框只能給你答案,agent 可以把事情做完。
它住在你的電腦上,只拿得到你給它的那個資料夾,每一個動作都可以要求它先問過你再做。所以「怕它控制我的電腦」這件事,答案是權限是你給的,可以只給一個資料夾。
整場最重要的一句話:AI 是人,它操作的是電腦。把它當一個人相處,很多規矩自己就推得出來。
跟它合作的四個原則
後面每一條規矩都從這四條來,記住這四件事,細節忘了也推得回來。
一、AI 是人,它操作的是電腦。 人接得住模糊、需要判斷的事,但慢、要花錢、每次講的話都不太一樣。程式是電腦,快、不花錢、給 A 永遠出 A,但只做你寫死的那件事。所以模糊的交給它,重複而確定的,叫它寫成程式再交給電腦跑。課前有人問「每個月統計醫院發表篇數」,這就是典型:叫 AI 寫一次程式,以後每個月都是電腦在跑,不要每個月叫 AI 算一次,它會算錯、算很久、又花錢。當天這題現場投票,四十一個人全部選對。
二、生成便宜,修補昂貴。 以前寫程式很貴,所以壞了就修補。現在生成很快,重做常常比修補簡單。所以計畫書比以前更重要:先寫清楚,再開工。工程界叫這個 SDD(Spec Driven Development),把這個字記下來回去問你的 AI 就好。
三、它會漂,但有錨就拉得回來。 每一步 95 分,做十步之後 0.95 的十次方剩 60 分。所以要有一份寫下來的計畫書,叫它每一步回去對「這一步對得上第幾條」。寫下來的那份就是錨。
四、AI 不碰原始資料,程式才碰。 在你自己的電腦上,用 AI 設計程式、寫程式、用假資料測程式;在醫院的電腦上,用程式跑病歷資料,AI 不在場。程式是在本機運算的,不會把東西送出去。這條在醫院一定要講。相關的法規我之前查過一輪,寫在這篇。
學術工作上,它已經能走完哪幾步
每一件事都用同樣的三拍講:我原本怎麼做、現在交出去哪幾步、我還留著哪一步。留著的會越來越少,因為連判斷都拆得開。
一、每個月追新文獻
原本:訂期刊通知信、掃標題、存進待讀清單。待讀清單越積越長,最後沒有人讀。
交出去:它每天掃新文獻,照我的興趣排序,放上一個網頁。「我的興趣」是一份寫下來的檔案,不是它猜的,所以排序會跟著我的興趣改。
我留著:勾哪幾篇真的要讀。一週看一次,五分鐘。工具是論文雷達。
二、抓回全文
原本:一篇一篇進圖書館系統點。
交出去:勾好之後它自己去抓,走四層階梯,只走合法的路:①免費全文(Unpaywall、PubMed Central)②出版社授權的文字探勘 API,用自己申請的金鑰 ③醫院館藏,走圖書館的遠端認證,嚴格限速 ④程式驗抓到的是不是「那一篇」,比 DOI、比標題,不是就退件。
這裡要特別講一下,也是圖書館同仁最擔心的事:用 AI 大量下載文獻,違反圖書館跟出版商簽的合約,會讓全院的 IP 被封。所以每一層都有節流,一次一篇、間隔幾秒、被拒就退避。工具是我自己寫的,程式碼公開在 paper-fetch,節流那一段請照抄。
我留著:幾乎沒有。
三、整理成可以查的筆記
交出去:兩支工具,兩種讀法。Paper Digest 是內容平讀,產出教學式筆記,問題、方法、發現、限制,每個重點附頁碼,再加一組複習卡隔幾天考我。Paper Review 是深度評讀,期刊可不可信、作者過去的紀錄、參考文獻逐條查、journal club 講稿。讀完一篇一則進筆記庫,連到哪一則主題筆記也是它提議、我點頭。程式碼在 paper-review-and-digest。
我留著:讀進腦子。
收:判斷也拆成兩種
留著的那一步「判斷它寫得對不對」,本身也是一個流程。是流程就可以拆解,拆解之後就可以交出去。拆得成指標的(頁碼對不對得上原文、數字有沒有變、重跑會不會錯)交給程式;拆不成的(這篇評讀公不公允)換一個模型交叉、不合就仲裁。最後真的留給我的,只剩閱讀與吸收。
把腦中的規矩變成工具
大家做研究都寫過 protocol,但 protocol 沒有寫到它能照著跑。差的那幾行,就是一張交班單:怎麼驗收、誰負責。
先講清楚:五個欄位
講清楚一件事只要五格:目標(要什麼)、背景(為什麼、給誰用)、素材(它可以拿什麼)、完成的樣子(做出來長怎樣)、誰驗收(怎樣算做完)。這五格你早就寫過,那叫交班單。它也要讀交班單:先叫它讀一遍,再問它缺什麼。
當天問大家平常請 AI 做事會講到哪幾格,「誰驗收」是最少人講的那一格。其實你的目標就是你的驗收;想不到怎麼驗收的時候,叫它從目標幫你生一份驗收清單就好。
示範:排班
有人課前問排班。我用自己科的規則做範例,對著手機碎碎唸十分鐘,週末怎麼分、什麼叫公平、QOD 不能連值,然後跟它說「先不要動手,一次問我一題,問到你弄清楚為止」。它問完,三十分鐘做出一個排班程式,可以輸入每個人這個月在不在、值班上限、跑出來檢查有沒有撞到、週末一整年分布平不平均。三十分鐘換一整年,後面每年都收回來。
重點是要有檢核器:故意排錯一份,看它抓不抓得到。這是驗證的方法,也是四原則第一條的落地:判斷交給它,檢查交給程式。
為什麼要寫成檔案
很多人說 ChatGPT 教過又忘。那是因為只留在對話裡:對話一長就被擠掉,開新對話從零開始,同一句話講第三次。寫成一個檔案,它每次開工先讀這個檔,結果每次一致,改規則就改檔案,不用重教。同一句話講到第三次,就該搬進檔案。這也是為什麼要讓它在你電腦裡跑:每個專案一個資料夾放它的記憶,它不會撈錯地方。
講不出來的時候
有些判準自己講不出來。我的做法是從對話紀錄反推:我批別人稿子時反覆講的那幾句,就是我的判準,讓它從往來紀錄把這幾句整理出來,比我憑印象寫的完整,而且有例子。三條界線:事前取得對方同意、產出是我自己的判準檔不外流不上架、沒同意的對話連丟進去都不行。
請它做系統性回顧,要注意什麼
這是研究部的主場,講得多一點。
起手式:先叫它去學
別問它能接哪幾步,先叫它去讀 PRISMA 2020 跟 Cochrane Handbook,讀完對著你的題目寫可行性分析(資料庫、預估篇數、要幾個人),再整理給你每一步怎麼做、誰做、怎麼驗收。你確認內容對不對,這一步才是你的。它會很嚴格、很誠實地照 handbook 執行,有時候嚴到超過一個 pilot study 需要的程度,這時候要不要做到那樣,是你決定,不是它。
分工:把它當第二、第三作者
篩選跟萃取要兩個 reviewer,我的做法是審閱者 A 用某一家公司的模型、審閱者 B 用另一家公司的模型,條件逐字相同,不合的時候第三個模型仲裁,人裁決不確定與衝突的那一疊。訓練方向不同,犯的錯也不同,所以要跨公司。
當天投票問「A、B 兩個模型盲篩,結果一致的那些篇可以直接納入嗎」,三十二人有二十九人答不行。對,一致不等於對,兩個都可能錯在同一個地方。什麼時候會一起錯?多半是你給的條件本身就錯了。醫院 conference 常講瑞士起司,很多層洞排成一直線才會出事,這裡一樣,要評的是這個錯的爆炸範圍多大,再決定要不要再審一次。
自己跑過一輪的教訓
- 原則:用程式留下紀錄。每一步的輸入輸出都落地,回頭查得到;不一致的不投票,追到具體的錯。
- 審查:三件不能省。逐字引用回原文找;一樣不代表對;抽樣只證明有問題,看到異常就普查。
- 紀錄:裁決附理由存成檔案,不留在對話裡;反覆對照需求,確認它照著走。
紅線與怎麼寫進稿子
官方立場是可輔助、不能當作者。Cochrane、JBI、Campbell、CEE 四機構 2025 年 11 月的聯合聲明加上 RAISE 指引:AI 做出或建議的判斷(去重、篩選、萃取)都要揭露,而且要嵌進對應的 PRISMA 條目,不是另開一節帶過。目前不支持沒有實質人類參與的生成式 AI 篩選。
寫進稿子的具體做法:PRISMA 流程圖的「紀錄篩選」跟「全文評估」兩個格子多寫幾句,AI 篩了幾篇、排除幾篇,人依排除條件排了幾篇,分開寫。方法段寫用哪個模型、哪個版本、什麼日期。規則檔、指令、程式附 supplementary,整段對話不用附。
怎麼知道它在編
課前問卷有人寫:「我下了『找不到就直接告訴我沒有』,它還是編出假資訊給我。」對,它會錯,而且錯得很自然,語言模型的目標就是把話講得漂亮。
數字:JMIR 2024 那篇,醫療文獻引用出錯的比例 GPT-3.5 是 39.6%,GPT-4 是 28.6%;限定資料庫加允許拒答加單一來源的設計下才降到零。零是設計出來的,不是模型天生的。
聊天框就能做的三原則
要出處:每個重點標頁碼或來源,要能翻回原文。就像寫論文每句話都要有 reference,你就會斟酌字句,它也一樣。允許拒答:明講「不知道就說不知道」。抽查驗證:隨機挑一條叫它把出處翻出來。
但抽查是人工。查核可以寫成程式。
把查核交給程式:四個例子
| 事情 | AI 負責 | 程式負責 |
|---|---|---|
| 證據等級 GRADE | 五個降級因子各嚴不嚴重 | 加總,算出等級 |
| 推論跳躍 | 每句證據貼標籤:相關還是因果、主要指標還是替代指標 | 標籤撐不起結論就退件 |
| 引用查核 | 第三步才讀:原文真的這樣講嗎 | DOI 存不存在、標題作者對不對 |
| OpenEvidence 回查 | 換一個沒看過推理過程的模型逐條比對 | 派工與收斂 |
引用那題當天投票分歧最大。「AI 給你一條引用,最省力又可靠的第一步是什麼」,三十八人裡二十三人選「問 CrossRef 這個 DOI 存不存在」,十三人選「叫另一個 AI 查」。這裡把順序講清楚:先程式,後 AI。CrossRef 是程式,一秒一條、免費、確定;另一個 AI 是人,慢、花錢、會有主觀,但它能看出「這篇存在,可是不支持這個說法」。兩個都要,順序不能反。
還有一個不做的事:叫同一個模型「再檢查一次」。它檢查自己的作業,跟你檢查自己的作業一樣不可靠。驗算不是再算一遍,是換一條路、換一個人。
收成一句:讓 AI 做判斷,讓程式做計算與查核。它會錯,但我攔得住。
用了 AI,論文裡怎麼寫
JAMA Network 2026 年 8 月更新了規定,這是研究部最多人問的一段。
不准做的,揭露也沒用:把 AI 生的資料當成原始研究;用 AI 起草 Opinion、Letter to the Editor、線上留言;AI 生成或修改的臨床影像、插圖、影音(除非是研究設計的一部分);審稿人把稿子丟進 AI;作者用 AI 回覆審稿人。參考文獻不建議用 AI 產生或排版,用一般的文獻管理軟體。
紅線是起草:人先寫初稿,它潤稿翻譯,可以。審稿沒有例外,貼進去就違反保密。
當天這題投票,十九個人裡只有五個人全對。最多人漏的是「用 AI 起草給審稿人的回覆」也在不准之列,還有「人先寫初稿再用 AI 翻成英文」其實是可以的。
可以做的,在 Acknowledgment 寫六件事:工具名、版本、廠商、使用日期、用在哪一段做了什麼、作者對正確性負全責。研究流程裡用的(篩選、萃取、寫程式)寫 Methods;潤稿、翻譯、摘要寫 Acknowledgment,且人先寫初稿;資料圖表寫 figure legend;拼字文法檢查不用寫。沒寫被抓到,退稿或刊後更正。
課前問卷的兩題直接答:用它把中文論文翻成英文,可以,人先寫初稿,Acknowledgment 寫工具、版本、日期、用在哪。把稿子跟文獻丟給它問我漏了什麼,可以,這是審閱不是代寫,同樣寫進 Acknowledgment。寫出來就沒事,藏起來才是問題。
明天早上第一句打什麼
- 只有聊天框:「先不要動手做。一次問我一題,問到你弄清楚我怎麼挑論文為止。」
- 想裝 agent:裝好後第一句:「這個資料夾裡有我的筆記,先讀一遍,告訴我你看到什麼。」安裝是最大的困難,裝完你就有一個隨時可以問的工程師。從哪開始看這篇。
- 想做系統性回顧:先把納入排除條件寫成一份檔案,再來找我。
費用與硬體一頁講完:免費網頁版就能做今天講的拷問法跟三原則;訂閱版含 agent 每月約 20 美元起,今天講的所有事都做得到;本地模型要買硬體,只有資料不能出本機時才有理由。一般筆電就夠,agent 跑的是你的電腦,吃力的計算在對方那邊。
課堂上沒答完的問題
側欄留言收了不少問題,當天沒答完的補在這裡。
- 被 reject 的修改紀錄,能不能變成審稿對手? 可以,就是上面「從對話紀錄反推判準」那招:把歷次審稿意見跟你的修改整理成一份檔案,叫它每次投稿前用這份先審一輪。網頁版也做得到,agent 只是省掉複製貼上。
- Claude Code 跟 Codex 差在哪? 兩家都成熟,選你訂閱的那家,做法一樣。真的要比,同一件事兩家各跑一次,留答對的,訓練方向不同,錯的地方也不同。
- 連圖書館資料庫抓文獻要注意什麼? 館藏那一層走的是機構 IP 的遠端認證,擋的是程式行為:序列抓取、間隔至少十幾秒、被拒就自動退避,這些都寫在 paper-fetch 的 README。另外要有文件跟紀錄,抓了什麼、什麼時候抓的,查得到。
- Claude 標記自己生成的內容,有什麼影響? 對正常使用沒有影響。它要抓的是整篇論文交給 AI 生成、一個字沒改的人,還有把 AI 協助藏起來不揭露的人。你有揭露,就沒有事。
- 互動系統是自己做的嗎,怎麼下指令? 是。方法跟排班一樣:手機錄音十分鐘,當個慣老闆把你想要的全部講給它聽,它整理好你對一遍,加一句「你覺得我哪裡沒講清楚」,再叫它做。不用一開始就做到最好。
後記
這場的投影片、互動側欄、課前問卷分析到這篇整理,都是跟 AI 一起做的,錄音回放逐字稿也是它轉的。研究部同仁回饋最多的是「希望有實作」,這篇先把段落補完整,實作的部分之後想辦法~
三套工具都在 GitHub:paper-radar、paper-fetch、paper-review-and-digest。有單位想聽類似的內容,歡迎來問我喔~