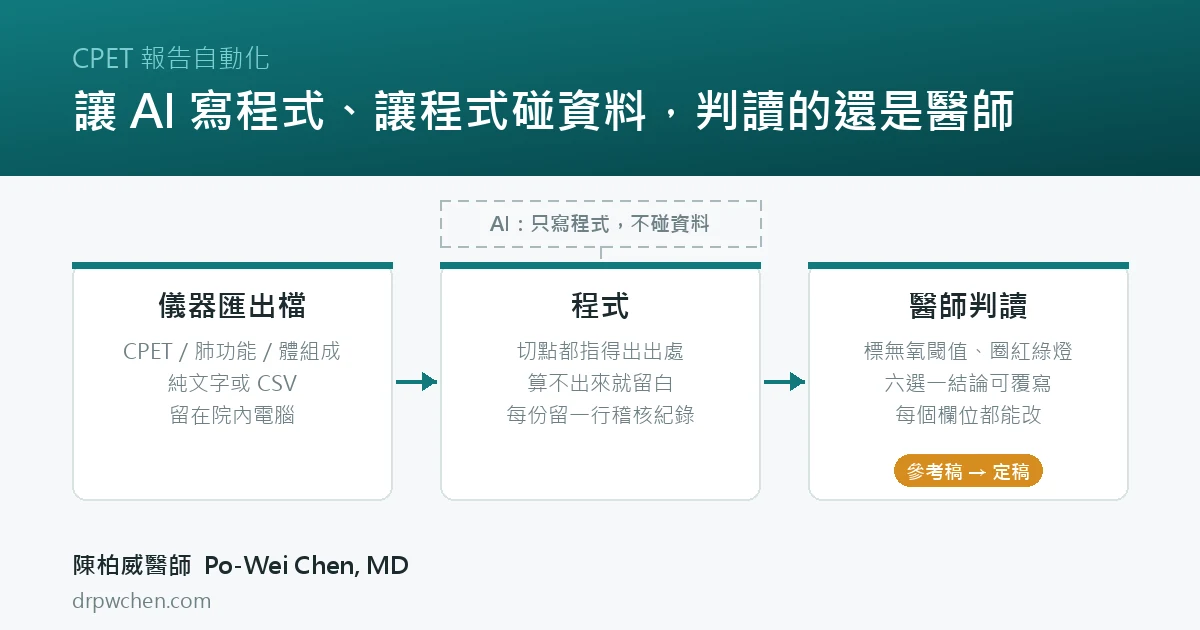
之前做了心肺運動測試(cardiopulmonary exercise testing, CPET)自動判讀的工具,做得有點慢🤣,但也因為慢,有些事情想得比較清楚。這篇把整套做法攤開來講:AI 在哪裡、程式在哪裡、醫師在哪裡,還有為什麼這三個位置不能換。
先講清楚:它產出的是參考稿,不是自動判讀
- 無氧閾值(AT/VT1)、呼吸代償點(RCP/VT2)、peak 的時間點,由醫師標,程式不猜
- AACVPR 風險分層的紅綠燈沒圈完,程式擋住不讓產生報告;真的判不出來才走頁內二次確認,而且會記進稽核
- 結論是照院內模板的六選一固定選單加一項「都不適用」,引擎只給建議、理由和出處,醫師可以覆寫
- 報告上每一個欄位都可以手動修改。機器負責把數字備妥,判讀的還是人
第一條原則:AI 不進醫院的電腦
跟醫院的資料對接,第一件要想的事情是病人安全。
我的做法是:用 AI 來設計程式,再用程式去跑醫院的資料,而不是把 AI 直接接到醫院的電腦裡面,讓它自己去讀。畢竟那台電腦裡有太多不該被讀到的東西。(病歷要貼給 AI 之前該先做什麼,之前在《病歷不能就這樣貼給 AI》寫過一篇。)
所以我給 AI 的,是「報告做完之後會產出哪些資料」這件事本身。CPET 儀器匯出時會同時吐出幾份表格檔,肺功能一份、體組成一份,都是能快速讀取的純文字或 CSV。把這些檔案的結構、我自己判讀過程的筆記、還有科內既有的報告模板一起給它,它就能把「這份報告到底是怎麼判讀出來的」重建成一支程式。
規則講清楚,電腦就有機會替我們跑完。這其實就是把我們平常在腦子裡做的資料判讀,外部化成一份看得見的東西。
一個插曲
一開始以為只能靠 OCR 讀 PDF 報告,操作者要手填 18 個欄位。後來發現儀器匯出時其實同時產生了一份純文字的
.xls,改成直讀之後,需要人工填的欄位剩 5 個。工具做慢一點的好處之一,就是有時間回頭看資料源。
每一條切點都要指得出出處
外部化的好處是,規則被攤開來看,就會發現有些地方需要對答案。
引擎裡每一條判讀切點,我都要求指得出來源:這條印在哪份報告模板的第幾節、那條出自教科書哪一版。科內五份報告模板(心肌梗塞、心衰竭、COPD、氣喘、心臟移植)是所有切點的唯一真相源。像是 AACVPR 的風險分層切點,有新舊兩版,過程中就要每條確認好是使用 2021 年第六版。
還有一條原則我覺得比切點本身更重要:算不出來的欄位就留白,不猜,也不預設為正常。空著的欄位人看得到,會去補;自動填成「正常」的欄位,沒有人會再看第二眼。
(規則先寫清楚再叫 AI 做,跟《先講清楚,再叫 AI 做:規格驅動開發》講的是同一件事,只是這次的規格是醫學上的切點。)
機器出的錯,常常很安靜
同一套匯出格式,不同單位吐出來的檔案,實測值跟預測值的欄位順序居然是相反的。程式一開始寫死讀第一欄,就把預測值當成了實測值。breathing reserve 從 −62% 變成 +41%,整份報告的結論會翻面。
這種錯不會跳出紅字,它會安安靜靜地產出一份看起來很正常的報告。所以人必須留在迴圈裡:判讀表單上每一個欄位都可以手動修改,機器只負責把數字備妥。
讓每一次判讀都留下紀錄
上面那件事讓我想到一個問題:安靜的錯,要怎麼被發現?
靠人記得是不行的。所以我把整套系統加了一層稽核紀錄:每產生一份報告,就在本機留下一行,記錄這一次判讀的完整經過。
不只是記「人改了什麼」,我最後記了七件事:
- 人工修改:哪一欄、機器判什麼、人最後填什麼,還分成「改值/補填/清空」三種動作
- 資料來源與備援:這次的 MVV 是用實測還是 FEV1×35 推的?HR recovery 是機器給的還是我自己從原始表算的?肺功能檔的欄位順序判成哪一種?
- 警示有沒有被理會:跳出來一百次都沒人動的警示,其實應該刪掉,這份紀錄就是刪它的依據
- 無氧閾值的判定:機器標的位置,跟我最後選的時間點差多少
- 留白的欄位:某一欄如果十份有九份都是空的,那是資料來源缺了,不是技師偷懶
- 解析失敗與不認得的檔案:以前這些只閃在畫面上,重整就消失了
- 當下的程式版本:這條我覺得最容易被忽略。沒有版本號,半年後回頭看那些修改紀錄,會不知道當時的規則長什麼樣,整份紀錄就等於作廢
紀錄留在本機,跟病人資料同一個等級,不進版本控制也不外傳。要拿出去討論的時候,另外有一個匯出指令,產生的摘要只有次數和比率,沒有病歷號、沒有姓名、也沒有任何生理數值。連警示文字裡技師手打的那一段都會被截掉,因為那裡可能出現人名。
上線第一天就抓到一個 bug
紀錄功能寫完,我拿一份舊資料跑第一次,畫面跳出來:這次判讀有 27 個欄位被「清空」。
我只改了兩個地方,怎麼會有 27 個?
去追才發現,判讀表單上只有一部分欄位可以填,另外一些是機器讀進來、但表單上沒有位置的數值。按下「產生報告」的時候,程式是拿表單上的欄位重新組一份資料,於是那些沒出現在表單上的值,就被安安靜靜地清成空的了。
裡面包括運動中最低血氧、休息時的死腔比、運動中最低收縮壓。這幾個都會影響判讀結論。也就是說,載入時自動產生的那份報告,跟我校核完按下產生的那份,判讀可能是不一樣的。
這個 bug 存在多久我不知道,但沒有這條紀錄,我大概還會再跟它相處很久。已經修好了,也補了一支回歸測試釘住它。
這件事讓我想通的一點
我原本以為這些紀錄要累積幾十份才有用,結果第一份就派上用場了。紀錄的價值不只在事後分析,它會立刻讓你看見自己看不見的東西。
目前的成品,跟下一步
現在已經有一支可以放在科內電腦裡的網頁程式,選一個病人資料夾丟進去,它會自動抓好,生成我們平常習慣的報告格式,HTML、PDF、可以直接貼進院內系統的純文字三種都有。
省下來的,是以前要一直謄打數字的時間;多出來的,是可以馬上看到報告,方便印成運動處方單,或是印一份適合給民眾帶回家的版本。醫療的品質跟效率,我覺得是可以一起往上走的。
至於那份稽核紀錄,等累積個幾十份,我打算把去識別化的摘要拿去請 AI 幫忙看:哪些欄位最常被我改?是不是代表那條切點訂得不對?整個過程 AI 都不會碰到病人的檔案,我們卻能一路把軟體養得更好。
程式本身是科內共用的,沒有開源。但做法是可以複製的:把你們自己的報告模板、儀器匯出檔的格式、還有你判讀時腦子裡那套規則交給 AI,讓它寫一支只跑在院內電腦的程式,然後把「最後一步是人」這件事用閘門擋死。有在做類似事情的朋友,也很歡迎留言聊聊你們是怎麼處理這一段的~