這裡是完整的文章列表。比起「筆記」偏向單一主題的結構化整理,這裡的文章多半是一件事從頭講到尾——臨床上遇到的問題、做研究踩過的坑,或是我怎麼把一個麻煩寫成一個工具。
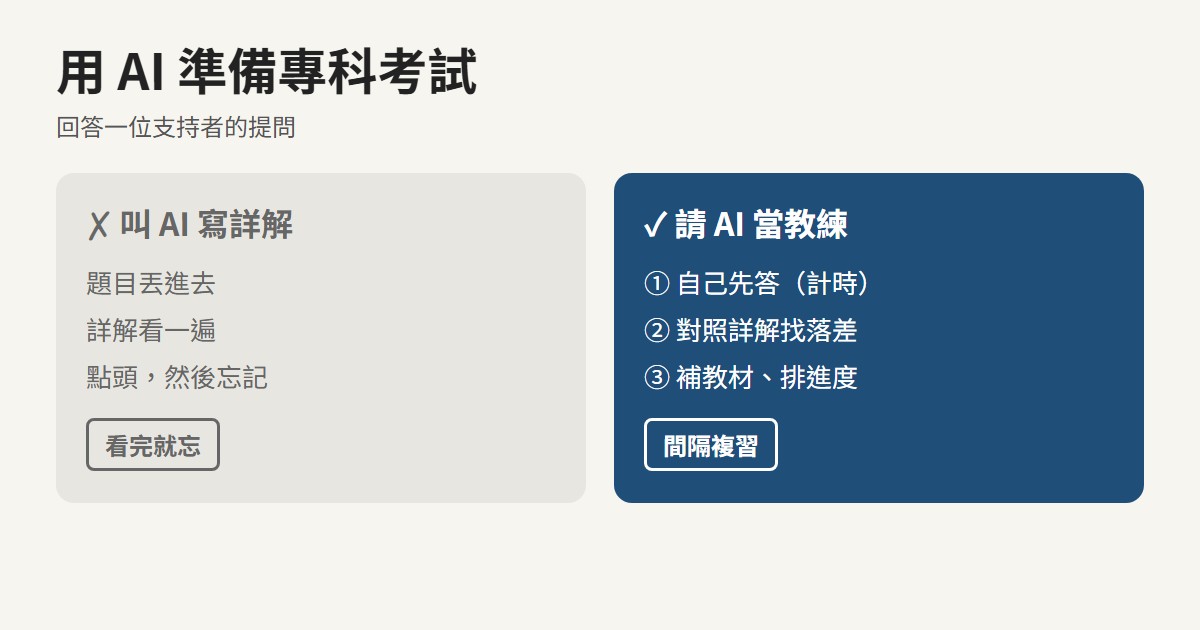
用 AI 準備專科考試:不是叫它寫詳解,是請它當私人教練
一位支持者問:怎麼用 AI 快速找到專科考題的解答?我的回答是:找答案很快,但詳解本身幫不了學習。這篇把教科書資料庫、間隔複習、口試模擬、詳解查核串成一套私人教練的做法。
這裡是完整的文章列表。比起「筆記」偏向單一主題的結構化整理,這裡的文章多半是一件事從頭講到尾——臨床上遇到的問題、做研究踩過的坑,或是我怎麼把一個麻煩寫成一個工具。
一位支持者問:怎麼用 AI 快速找到專科考題的解答?我的回答是:找答案很快,但詳解本身幫不了學習。這篇把教科書資料庫、間隔複習、口試模擬、詳解查核串成一套私人教練的做法。
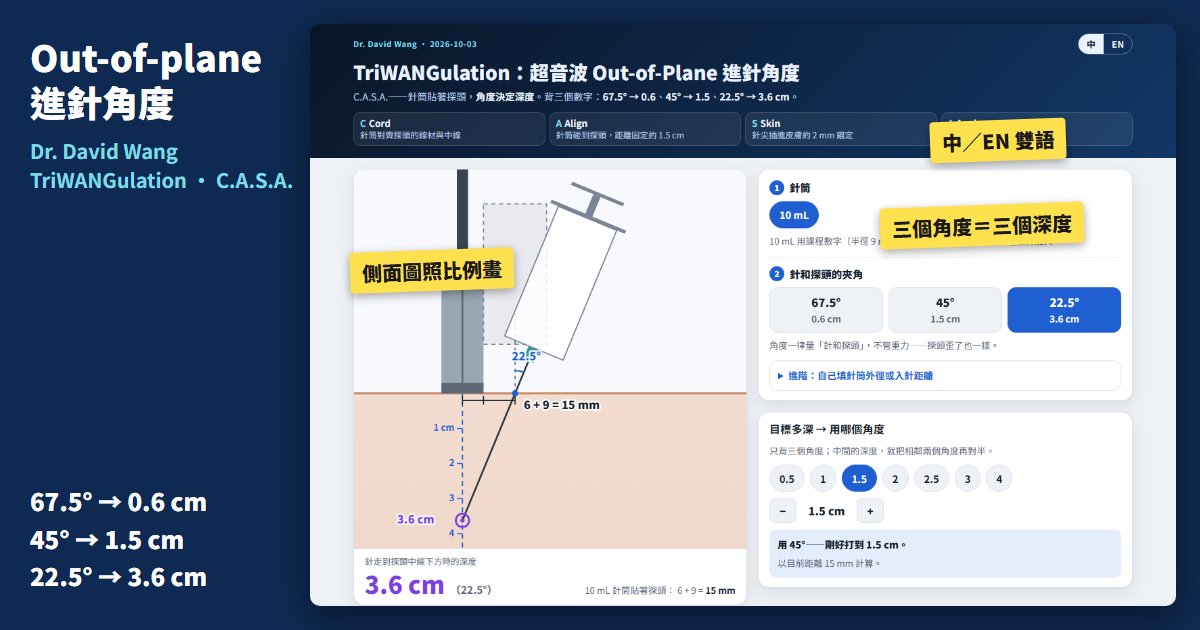
增生療法義診我從 2023 年開始每年參加。今年(2026-10-03)Dr. David Wang(David C. Wang, DO,Virtuosity Physical Medicine 負責人,美國維吉尼亞州 Reston)講了一段 out-of-plane 進針法,整套方法只要背 三個角度、三個數字,我聽完就想把它做成一個隨時拿出來查的東西。 所以回來之後把錄音整理成筆記(用的是之前開源的 lecture-to-notes),再做成一個網頁,中英雙語、手機優先: 打開進針角度網頁 →中英雙語・手機可用・不用安裝 Out-of-plane 為什麼難? 因為針在超音波上只是一個亮點,你看不到它從哪裡來,只能猜它會在多深的地方出現。 David Wang 醫師說,在美國大概 90–95% 的醫師只做 in-plane,原因很簡單:沒有人教 out-of-plane。但 out-of-plane 通常比較快、可以用更細的針,病人也比較不痛。他的解法是把「猜」拿掉,讓深度變成可以算的東西。 C.A.S.A.:先把三個方向變成一個 先把左右、前後兩個方向固定住,最後只剩深度要處理。 這是他和 Dr. Sean Hessler, ND 一起發展的四個步驟: Cord(對線):針筒對齊探頭的線材與探頭中線,針就永遠在探頭正中間。 Align(貼靠):針筒真的碰到探頭。探頭中線到側緣約 6 mm,10 cc 針筒半徑約 9 mm,所以入針點離超音波束固定是 約 1.5 cm。 Skin(淺插):沿著探頭往下滑,針尖插進皮膚約 2 mm 先錨定,參考點才不會跑掉。 Angle(定角):最後才調針和探頭的夾角,這個角度決定深度。 TriWANGulation:三個角度就夠了嗎? 夠。距離固定 1.5 cm 之後,深度只看角度: 針和探頭的夾角 針走到探頭中線下方的深度 67.5° 0.6 cm 45° 1.5 cm 22.5° 3.6 cm 為什麼挑這三個角度?他的說法很實際:人很會判斷 0° 和 90°,45° 也不難,再把 45° 對半切成 22.5°、或是切在 45° 和 90° 中間的 67.5°,一般人都做得到。像 26.57° 這種「算得出來」的角度,沒有人能準確比出來。 ...
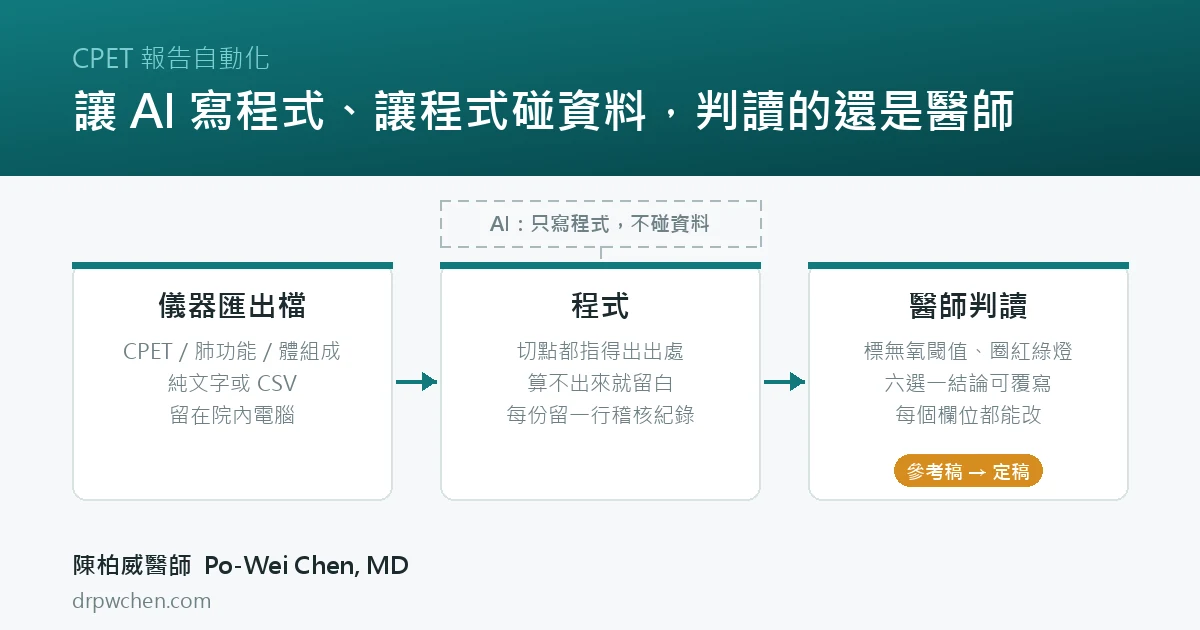
之前做了心肺運動測試(cardiopulmonary exercise testing, CPET)自動判讀的工具,做得有點慢🤣,但也因為慢,有些事情想得比較清楚。這篇把整套做法攤開來講:AI 在哪裡、程式在哪裡、醫師在哪裡,還有為什麼這三個位置不能換。 先講清楚:它產出的是參考稿,不是自動判讀 無氧閾值(AT/VT1)、呼吸代償點(RCP/VT2)、peak 的時間點,由醫師標,程式不猜 AACVPR 風險分層的紅綠燈沒圈完,程式擋住不讓產生報告;真的判不出來才走頁內二次確認,而且會記進稽核 結論是照院內模板的六選一固定選單加一項「都不適用」,引擎只給建議、理由和出處,醫師可以覆寫 報告上每一個欄位都可以手動修改。機器負責把數字備妥,判讀的還是人 第一條原則:AI 不進醫院的電腦 跟醫院的資料對接,第一件要想的事情是病人安全。 我的做法是:用 AI 來設計程式,再用程式去跑醫院的資料,而不是把 AI 直接接到醫院的電腦裡面,讓它自己去讀。畢竟那台電腦裡有太多不該被讀到的東西。(病歷要貼給 AI 之前該先做什麼,之前在《病歷不能就這樣貼給 AI》寫過一篇。) 所以我給 AI 的,是「報告做完之後會產出哪些資料」這件事本身。CPET 儀器匯出時會同時吐出幾份表格檔,肺功能一份、體組成一份,都是能快速讀取的純文字或 CSV。把這些檔案的結構、我自己判讀過程的筆記、還有科內既有的報告模板一起給它,它就能把「這份報告到底是怎麼判讀出來的」重建成一支程式。 規則講清楚,電腦就有機會替我們跑完。這其實就是把我們平常在腦子裡做的資料判讀,外部化成一份看得見的東西。 一個插曲 一開始以為只能靠 OCR 讀 PDF 報告,操作者要手填 18 個欄位。後來發現儀器匯出時其實同時產生了一份純文字的 .xls,改成直讀之後,需要人工填的欄位剩 5 個。工具做慢一點的好處之一,就是有時間回頭看資料源。 每一條切點都要指得出出處 外部化的好處是,規則被攤開來看,就會發現有些地方需要對答案。 引擎裡每一條判讀切點,我都要求指得出來源:這條印在哪份報告模板的第幾節、那條出自教科書哪一版。科內五份報告模板(心肌梗塞、心衰竭、COPD、氣喘、心臟移植)是所有切點的唯一真相源。像是 AACVPR 的風險分層切點,有新舊兩版,過程中就要每條確認好是使用 2021 年第六版。 還有一條原則我覺得比切點本身更重要:算不出來的欄位就留白,不猜,也不預設為正常。空著的欄位人看得到,會去補;自動填成「正常」的欄位,沒有人會再看第二眼。 (規則先寫清楚再叫 AI 做,跟《先講清楚,再叫 AI 做:規格驅動開發》講的是同一件事,只是這次的規格是醫學上的切點。) 機器出的錯,常常很安靜 同一套匯出格式,不同單位吐出來的檔案,實測值跟預測值的欄位順序居然是相反的。程式一開始寫死讀第一欄,就把預測值當成了實測值。breathing reserve 從 −62% 變成 +41%,整份報告的結論會翻面。 這種錯不會跳出紅字,它會安安靜靜地產出一份看起來很正常的報告。所以人必須留在迴圈裡:判讀表單上每一個欄位都可以手動修改,機器只負責把數字備妥。 讓每一次判讀都留下紀錄 上面那件事讓我想到一個問題:安靜的錯,要怎麼被發現? 靠人記得是不行的。所以我把整套系統加了一層稽核紀錄:每產生一份報告,就在本機留下一行,記錄這一次判讀的完整經過。 不只是記「人改了什麼」,我最後記了七件事: 人工修改:哪一欄、機器判什麼、人最後填什麼,還分成「改值/補填/清空」三種動作 資料來源與備援:這次的 MVV 是用實測還是 FEV1×35 推的?HR recovery 是機器給的還是我自己從原始表算的?肺功能檔的欄位順序判成哪一種? 警示有沒有被理會:跳出來一百次都沒人動的警示,其實應該刪掉,這份紀錄就是刪它的依據 無氧閾值的判定:機器標的位置,跟我最後選的時間點差多少 留白的欄位:某一欄如果十份有九份都是空的,那是資料來源缺了,不是技師偷懶 解析失敗與不認得的檔案:以前這些只閃在畫面上,重整就消失了 當下的程式版本:這條我覺得最容易被忽略。沒有版本號,半年後回頭看那些修改紀錄,會不知道當時的規則長什麼樣,整份紀錄就等於作廢 紀錄留在本機,跟病人資料同一個等級,不進版本控制也不外傳。要拿出去討論的時候,另外有一個匯出指令,產生的摘要只有次數和比率,沒有病歷號、沒有姓名、也沒有任何生理數值。連警示文字裡技師手打的那一段都會被截掉,因為那裡可能出現人名。 ...
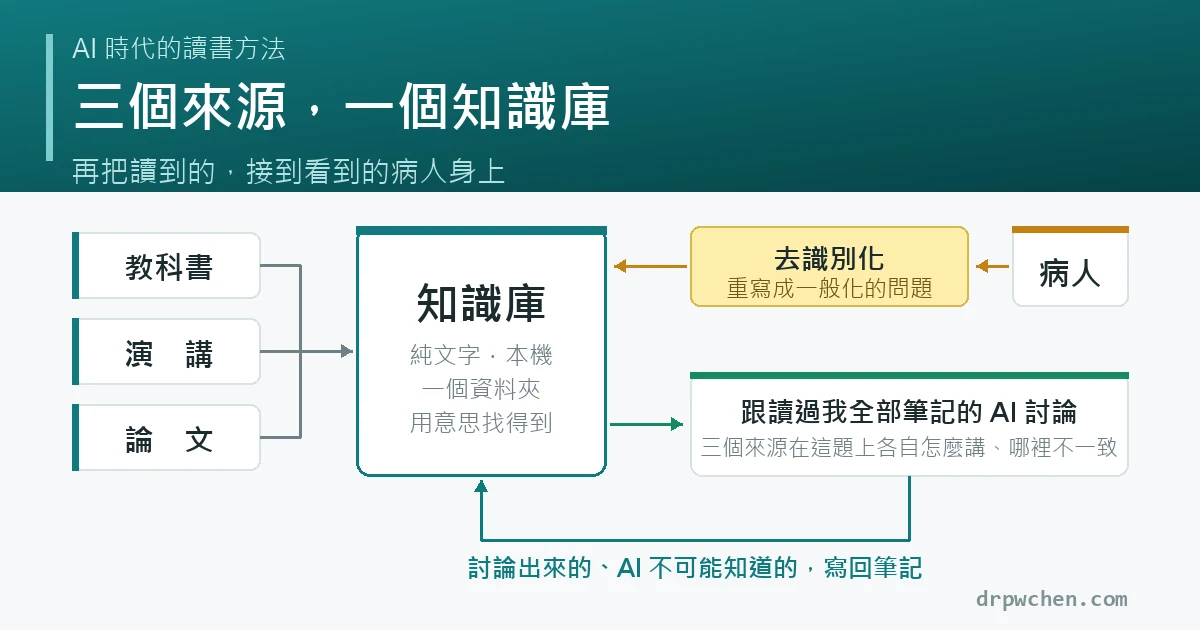
教科書、演講、論文三條產線各自寫過了,這篇講它們合起來是什麼:一個 AI 讀得動的知識庫。庫建好之後,門診遇到的病人狀況經過去識別化轉譯,就能拿來跟 AI 討論,把讀到的接到看到的病人身上。最後講用 AI 學習的那條界線:哪些可以外包、哪些不能,該記什麼、怎麼跟它一起維護筆記。
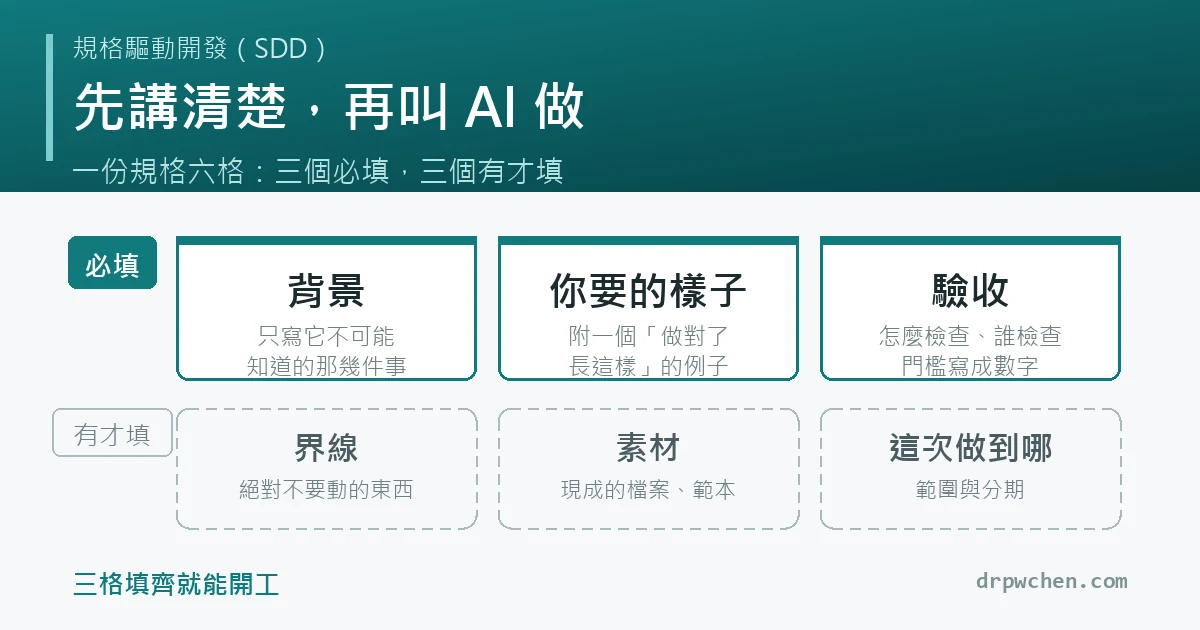
東西大到一句話交代不完,開工前要先寫好什麼?什麼時候不用寫、需求的三個必填零件、含糊一句對上清楚五句、一份可以直接複製的規格範本、改需求先改規格、用程式把這條擋成硬規則,還有為什麼錯的規格錯得很有權威。
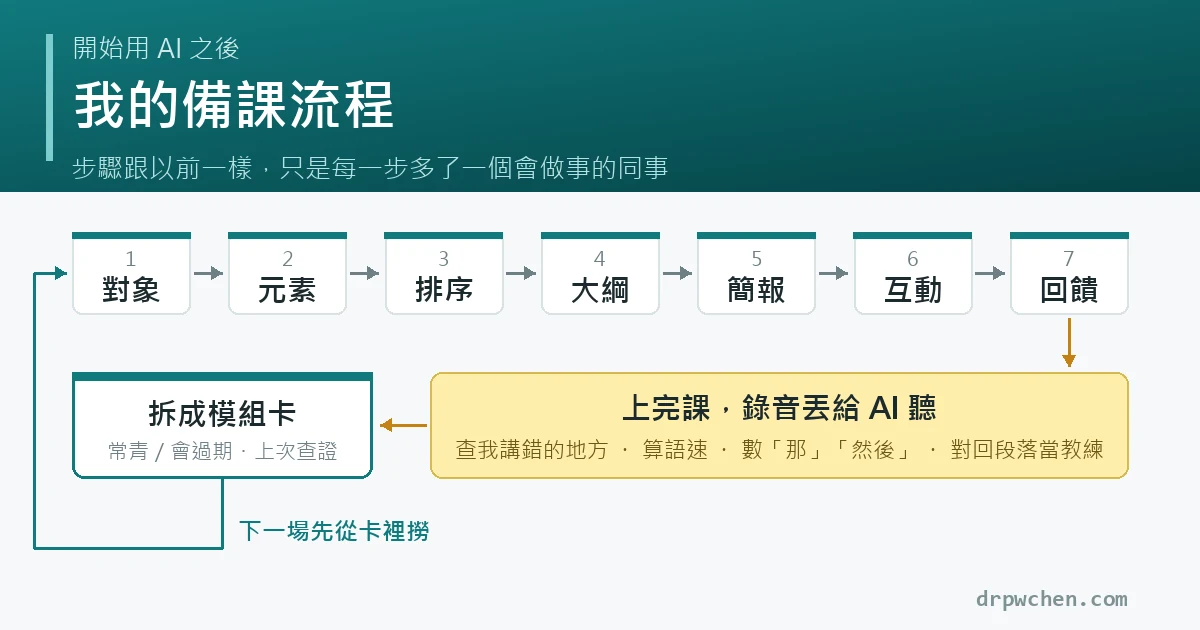
備課的步驟跟沒有 AI 的時候一模一樣,差別是每一步多了一個會做事的同事。這篇把七個步驟攤開來講:對象、元素、排序、大綱、簡報、互動、回饋,每一步我做什麼、他做什麼。最後講上完課之後的事:錄音讓他聽、抓我講錯的地方、算語速、數贅字,然後把這堂課拆成下一場的零件。
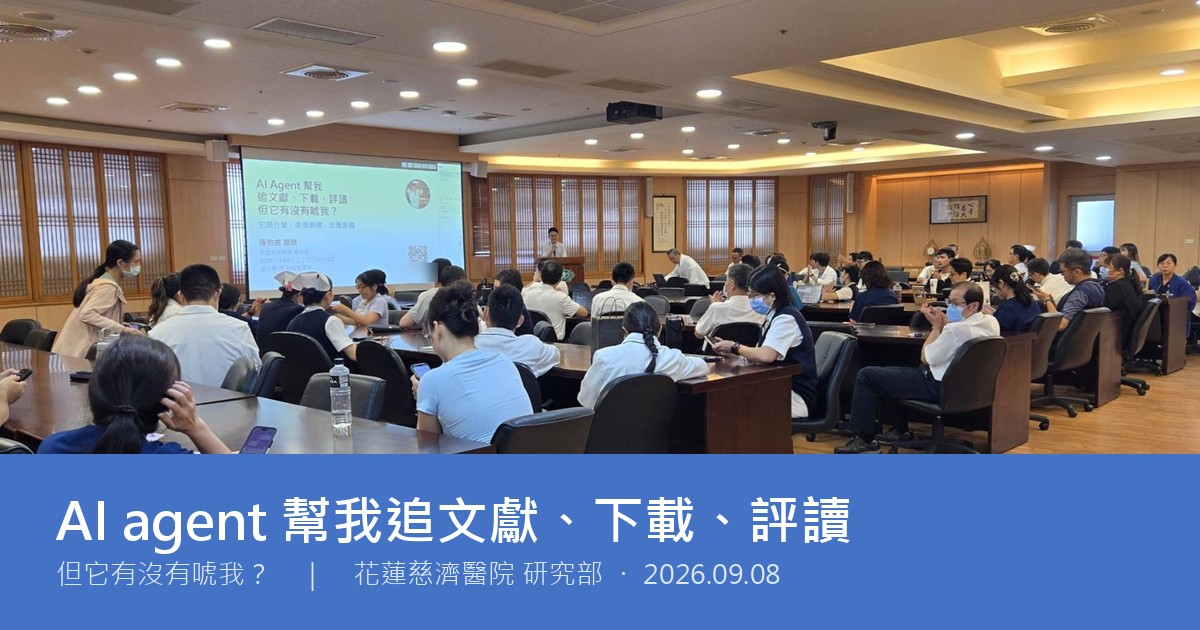
謝謝花蓮慈濟研究部的邀約,九月八號中午在協力樓和氣會議室講了一場 AI agent。中午時段還來了九十位左右,研究部、醫師、醫事人員、行政同仁都有,課前問卷收了 89 份,最擔心的三件事是「它講錯而我沒發現」、「個資會不會外洩」、「用了 AI 論文裡要怎麼寫」。所以這場就繞著這三件事排。 這篇把當天講的內容整理成文字版,給來聽的人回看,也給沒來的人一份完整版。課堂上有幾段因為時間被壓短了,這裡補完整。 AI agent 到底是什麼 用 AI 有三個層次。第一層是聊天框,把問題或論文貼給它,它回答你,資料要自己收集好、自己貼。第二層是 NotebookLM 這類,可以把一疊資料丟給它,它從固定的來源找答案。第三層才是 agent:它有手,可以開你電腦裡的檔案、跑程式、上網查、把結果存回你的資料夾。聊天框只能給你答案,agent 可以把事情做完。 它住在你的電腦上,只拿得到你給它的那個資料夾,每一個動作都可以要求它先問過你再做。所以「怕它控制我的電腦」這件事,答案是權限是你給的,可以只給一個資料夾。 整場最重要的一句話:AI 是人,它操作的是電腦。把它當一個人相處,很多規矩自己就推得出來。 跟它合作的四個原則 後面每一條規矩都從這四條來,記住這四件事,細節忘了也推得回來。 一、AI 是人,它操作的是電腦。 人接得住模糊、需要判斷的事,但慢、要花錢、每次講的話都不太一樣。程式是電腦,快、不花錢、給 A 永遠出 A,但只做你寫死的那件事。所以模糊的交給它,重複而確定的,叫它寫成程式再交給電腦跑。課前有人問「每個月統計醫院發表篇數」,這就是典型:叫 AI 寫一次程式,以後每個月都是電腦在跑,不要每個月叫 AI 算一次,它會算錯、算很久、又花錢。當天這題現場投票,四十一個人全部選對。 二、生成便宜,修補昂貴。 以前寫程式很貴,所以壞了就修補。現在生成很快,重做常常比修補簡單。所以計畫書比以前更重要:先寫清楚,再開工。工程界叫這個 SDD(Spec Driven Development),把這個字記下來回去問你的 AI 就好。 三、它會漂,但有錨就拉得回來。 每一步 95 分,做十步之後 0.95 的十次方剩 60 分。所以要有一份寫下來的計畫書,叫它每一步回去對「這一步對得上第幾條」。寫下來的那份就是錨。 四、AI 不碰原始資料,程式才碰。 在你自己的電腦上,用 AI 設計程式、寫程式、用假資料測程式;在醫院的電腦上,用程式跑病歷資料,AI 不在場。程式是在本機運算的,不會把東西送出去。這條在醫院一定要講。相關的法規我之前查過一輪,寫在這篇。 學術工作上,它已經能走完哪幾步 每一件事都用同樣的三拍講:我原本怎麼做、現在交出去哪幾步、我還留著哪一步。留著的會越來越少,因為連判斷都拆得開。 一、每個月追新文獻 原本:訂期刊通知信、掃標題、存進待讀清單。待讀清單越積越長,最後沒有人讀。 交出去:它每天掃新文獻,照我的興趣排序,放上一個網頁。「我的興趣」是一份寫下來的檔案,不是它猜的,所以排序會跟著我的興趣改。 我留著:勾哪幾篇真的要讀。一週看一次,五分鐘。工具是論文雷達。 二、抓回全文 原本:一篇一篇進圖書館系統點。 交出去:勾好之後它自己去抓,走四層階梯,只走合法的路:①免費全文(Unpaywall、PubMed Central)②出版社授權的文字探勘 API,用自己申請的金鑰 ③醫院館藏,走圖書館的遠端認證,嚴格限速 ④程式驗抓到的是不是「那一篇」,比 DOI、比標題,不是就退件。 這裡要特別講一下,也是圖書館同仁最擔心的事:用 AI 大量下載文獻,違反圖書館跟出版商簽的合約,會讓全院的 IP 被封。所以每一層都有節流,一次一篇、間隔幾秒、被拒就退避。工具是我自己寫的,程式碼公開在 paper-fetch,節流那一段請照抄。 ...
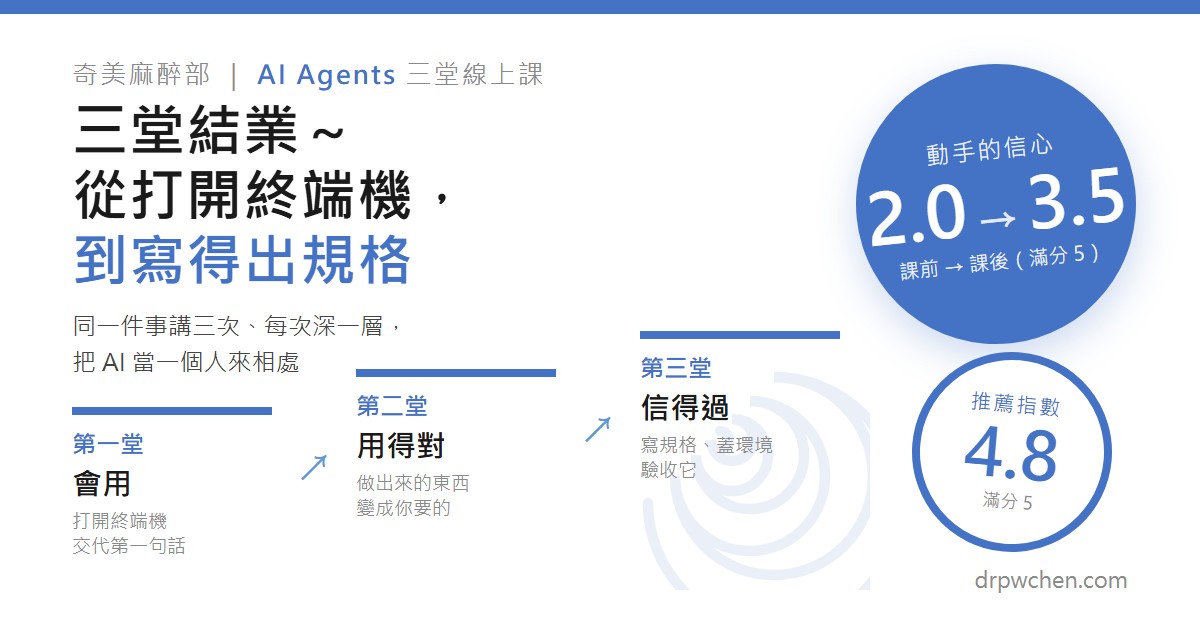
三個週二晚上,每堂一小時再加討論。謝謝奇美麻醉部的鄧醫師邀約,讓我來把一整套課從頭講到尾。 這篇想講三件事:這三堂為什麼這樣排、大家學到了什麼,還有我自己最感恩的一件事。 為什麼拆成三堂、每週一堂 醫學生時代去上過 AMEE 的 ESME(Essential Skills in Medical Education),裡面講到醫學的學習是螺旋式的:同一件事,基礎的時候碰一次,進階再碰一次,一圈一圈繞上去,越繞越熟。 學 AI agent 對醫師來說也是踏進一個陌生的領域,所以這次照同樣的方式排。有些東西三堂都會講到,每次多講深一層,看過三次就不陌生了。 中間刻意隔一週,讓大家回去能夠試作看看,有時做過才知道哪邊會遇到問題、往更深的地方走。 每堂都有課前單、回家作業、課後單,因為也是第二次講這個題目,希望能貼合大家的程度。用的太久太自然,會忘記第一次接觸的人卡在哪裡,這種知識的詛咒只能靠問卷來對齊,第二堂、第三堂的內容都是從上一堂的問卷長出來的。 三堂串起來的一句話:AI 是人 這句話是整套課的脊椎。把 AI 當成一個人:記憶力有限,聊久了會忘記前面講的;現在的個性是會字面解讀你的意思;會犯錯,要核對。把它當人相處,就不會覺得很難,也不會太相信它。 三堂就是繞著這個人轉三圈。 第一堂|會用 怎麼開機、怎麼交代第一句話。三層框架(聊天框、給它檔案、整個資料夾交給它),現場帶著大家打開終端機、整理一個亂資料夾、把 WHO 手術安全查核表轉成筆記。也講了它的記憶是怎麼運作的、為什麼要常常清空對話、怎麼知道它在唬你。 第二堂|用得對 讓它做出來的東西變成你要的東西。跟人講話一樣,要給背景、講要的樣子、畫界線、說怎麼驗收。這堂也講了醫療端的法規:授權範圍、去識別化的門檻、地端跟雲端的差別、衛福部的生成式 AI 指引講了什麼、沒講什麼。然後把自己開發的工具拆給大家看:排班系統從碎碎唸十分鐘到成品的過程,教科書變筆記的工具(textbook-to-note)裡面到底怎麼運作。 第三堂|信得過 怎麼知道它有沒有唬你。主題是 SDD(Spec Driven Development),學習用工程師的角度把東西設計好、維護好。AI 幫你從 0 到 1 很快,1 到 100 要靠規格跟維護。講規格怎麼寫、環境怎麼蓋、怎麼驗收,還有幻覺跟安全性的事。最後再繞到我自己覺得AI時代怎麼學習。 大家有開始實作 CLI 課前跟課後都問了同一題:用終端機跟 AI 一起做事,信心幾分(1 到 5)。課前平均 2.0 分,課後進步到 3.5 分。看起來逐漸入門了~大家應該都有順利做出想要的筆記,還有人自製臨床/讀書/研究工具等。我想最重要的是,產生一個跟AI互動的默契,能在互動中成長出自己的系統。 最感恩的一件事 課排在晚上八點半到九點半,討論常常到快十點。這個時間大家下了班、吃完飯、還要開電腦,第一堂線上四十幾位,第二堂、第三堂還有三十五位。中間當然有人覺得太難或有別的事離開,但留到最後的人這麼多很讓人開心! 後記 那當然這三堂都大量用 AI 來備課,逐字稿回放、問卷分析、投影片改版也都靠它,這個流程蠻好玩的,下一篇單獨寫~ 很喜歡這樣看到大家長出不同的東西,分享這種像在玩電玩的快樂😁 如果有單位想開類似的課,或是三五好友揪一揪,也歡迎來問我喔~
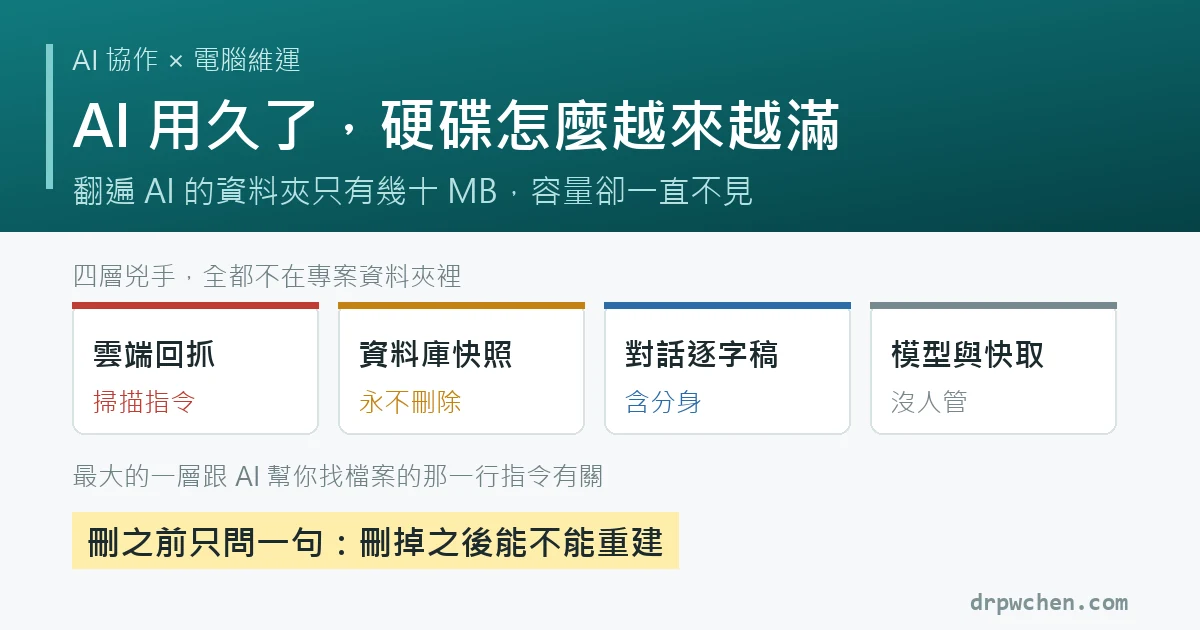
這個題目是訂閱區的歐陽醫師許願的。他說得很準:認真看 AI 運行的資料夾,好像都才幾十 MB,但是電腦容量就是被吃掉一大半。 這件事我自己也遇到很多次了。我的 C 槽 953 GB,過去一個多月每隔幾週就快滿一次,每次都是跟 Claude 說「幫我清理」,清完過陣子又滿回來。這次我們不清了,改成把一個多月來每一次清理的對話全部翻出來對帳,算清楚是誰一直長回來。 查出來四層,照體積排序。其中一層是我們自己開源出去的工具,這個下面會老實講。 一、雲端同步:檔案被讀一次,就永久回到你的電腦 這台電腦的 OneDrive 雲端有大約 400 GB。檔案設成「僅雲端」之後,檔名在、圖示在,不佔空間。但只要有任何程式打開那個檔案,同步軟體就會把它下載回本機,而且除非你自己把它釋放回雲端,它就會一直佔著空間。 八月十七號那次大掃除清出 382 GB。四天後回頭看少了 56 GB,其中課本 PDF 那幾個資料夾自己回到本機 45 GB。 這件事的怪,怪在因果被切斷了。吃掉容量的那個動作,跟長出來的那些檔案,看起來完全沒關係。你翻遍 AI 的資料夾,當然只有幾十 MB。 我們怎麼把它抓出來的 這一段是這篇最想分享的:不是我自己會查,是我跟 Claude 一起把範圍縮小的過程。 第一步,先問清楚機制。 我請他上網查「OneDrive 在什麼情況下會自動把僅雲端的檔案下載回本機」。查回來的答案是:只要有程式開啟那個檔案就會,不必真的讀內容。這一句話後來就是破案關鍵。 第二步,一個一個排除。 每關掉一個嫌疑犯就重新量一次本機佔用: Windows 搜尋索引:停掉六分鐘,佔用沒變化 檔案總管縮圖、防毒掃描、Google Drive、iCloud、Synology Drive:都排除 OneDrive 自己重抓:手動把二十個檔案標成「釋放空間」,六分鐘內一個都沒有被抓回來 排到這裡,OneDrive 本身的嫌疑就洗清了。它只是執行者,不是發動者。 第三步,我提了一句話,方向就轉了。 當下我們一直在找「現在正在跑的東西」,可是我想到:這些下載搞不好是幾個小時前下的指令留下來的,那支程式可能還活著,只是沒人注意。 我把這句話丟給他,他回頭去翻還在執行中的舊程序,當場抓到兩支: 下午五點二十某個 AI session 下的 find 指令,尾巴接了 head,本來只要前二十筆。head 拿夠了自己結束,前面的 find 卻沒有跟著死,一路跑了五個小時,回抓 19 GB 抓它的同時,另一個 session 又下了一支掃全機的 find,三分鐘再吃掉 6 GB 兩支都殺掉之後,回抓當場歸零。 ...
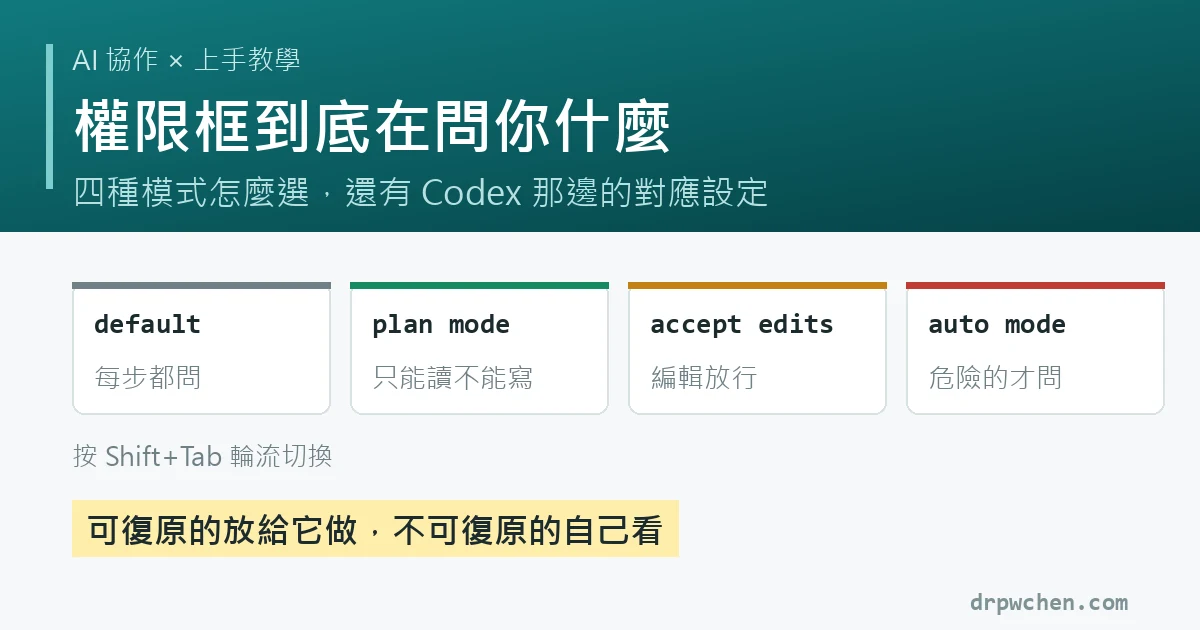
上週幫一群麻醉科的醫師朋友上了一堂 AI agent 上手課。課後回饋很有意思:「權限框與 auto mode」同時出現在兩張名單的前段,投「最有收穫」的人很多,投「沒聽懂」的人也很多。代表這東西重要,但一堂課的節奏講不完。這篇把它一次講完整。 還沒裝起來的朋友,可以先看從零開始用 AI agent那篇,裝好再回來。 權限框是什麼:它動手之前,先舉手 第一次叫 Claude Code 或 Codex 整理資料夾,最不習慣的就是它一直跳框問你「可以嗎?」。 這個框其實是整套系統最重要的安全設計:AI agent 要動你電腦裡的東西之前,必須先讓你點頭。框裡通常有三個部分: 它想跑的指令:一行終端機指令,像 ls、mkdir、rm 它自己的白話解釋:指令下面那一兩行,說明它想做什麼、為什麼 你的選項:同意這次、同意以後都不用問、拒絕 你不需要會終端機指令。你只需要看得懂那行白話解釋,然後判斷「合理嗎」。看不懂的時候有兩招: 看不懂它想幹嘛的兩招 直接回它:「用五歲小孩能懂的方式解釋你現在要做什麼」(英文縮寫叫 ELI5,Explain Like I’m 5,AI 都看得懂) 把那行指令複製,貼給網頁版的 AI 問「這個指令會做什麼?有風險嗎?」 四種模式:按 Shift+Tab 切換 每一步都問你,等它做完一件事你可能按了二十次同意。所以 Claude Code 提供好幾種模式,按 Shift+Tab 就能輪流切換,畫面上會顯示目前在哪個模式。日常用得到的是這四個: 模式 它會怎樣 什麼時候用 default(預設) 每個會改到東西的動作都先問你 剛開始建立信任的階段 plan mode 只能讀、不能寫,先研究再給你一份計畫 想先看它打算怎麼做;要碰重要資料的第一步 accept edits 檔案編輯自動放行,跑指令仍會問 改稿、寫筆記這類編輯密集的工作 auto mode 系統自動判斷每條指令危不危險:安全的直接放行,危險的攔下來問你 日常主力 (Claude Code 其實還有更多模式,像給無人值守環境用的 bypass permissions,那些跟日常上手無關,先不用管。) auto mode 為什麼反而比較安全:警報疲勞 臨床的人對 alarm fatigue 都不陌生:monitor 什麼都叫,叫久了大家聽到聲音只是伸手把它按掉。權限框也一樣。當每一個框都要你同意,你很快就會停止閱讀,變成反射性按同意。這時候「每步都問」給你的不是安全,是安全感。 ...