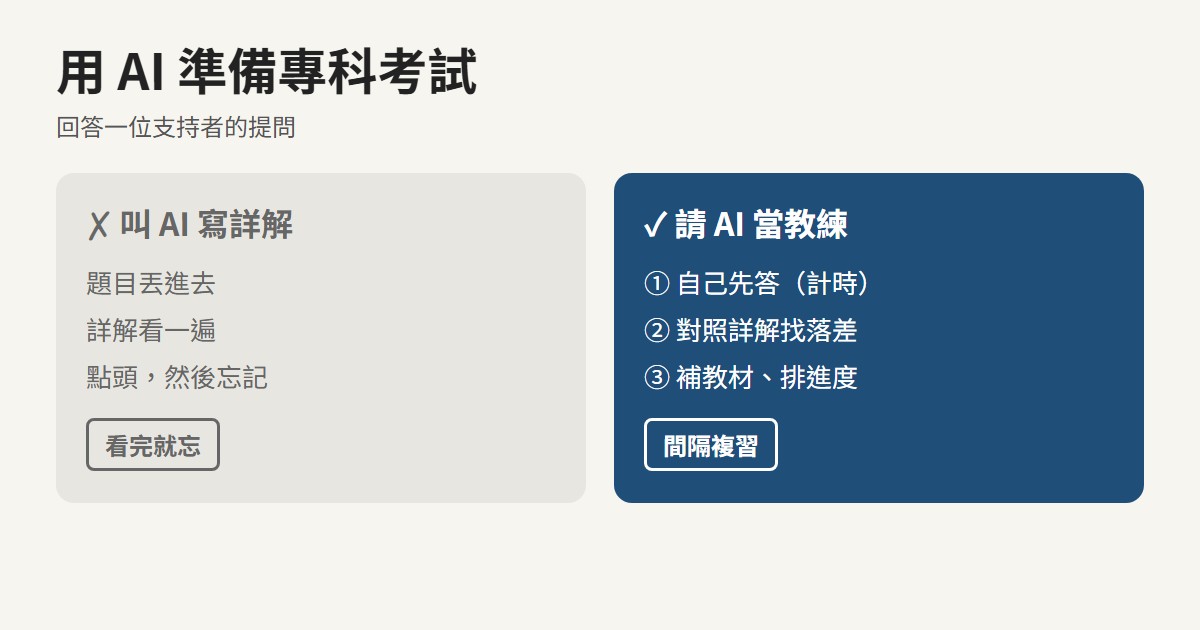
用 AI 準備專科考試:不是叫它寫詳解,是請它當私人教練
一位支持者問:怎麼用 AI 快速找到專科考題的解答?我的回答是:找答案很快,但詳解本身幫不了學習。這篇把教科書資料庫、間隔複習、口試模擬、詳解查核串成一套私人教練的做法。
一位支持者問:怎麼用 AI 快速找到專科考題的解答?我的回答是:找答案很快,但詳解本身幫不了學習。這篇把教科書資料庫、間隔複習、口試模擬、詳解查核串成一套私人教練的做法。
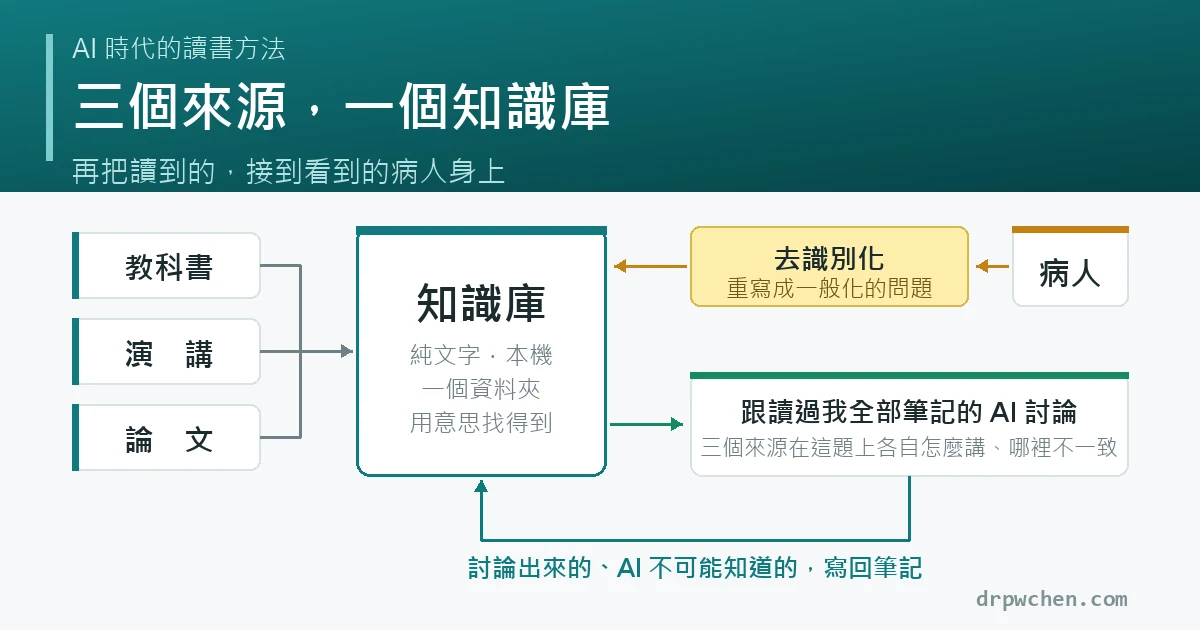
教科書、演講、論文三條產線各自寫過了,這篇講它們合起來是什麼:一個 AI 讀得動的知識庫。庫建好之後,門診遇到的病人狀況經過去識別化轉譯,就能拿來跟 AI 討論,把讀到的接到看到的病人身上。最後講用 AI 學習的那條界線:哪些可以外包、哪些不能,該記什麼、怎麼跟它一起維護筆記。
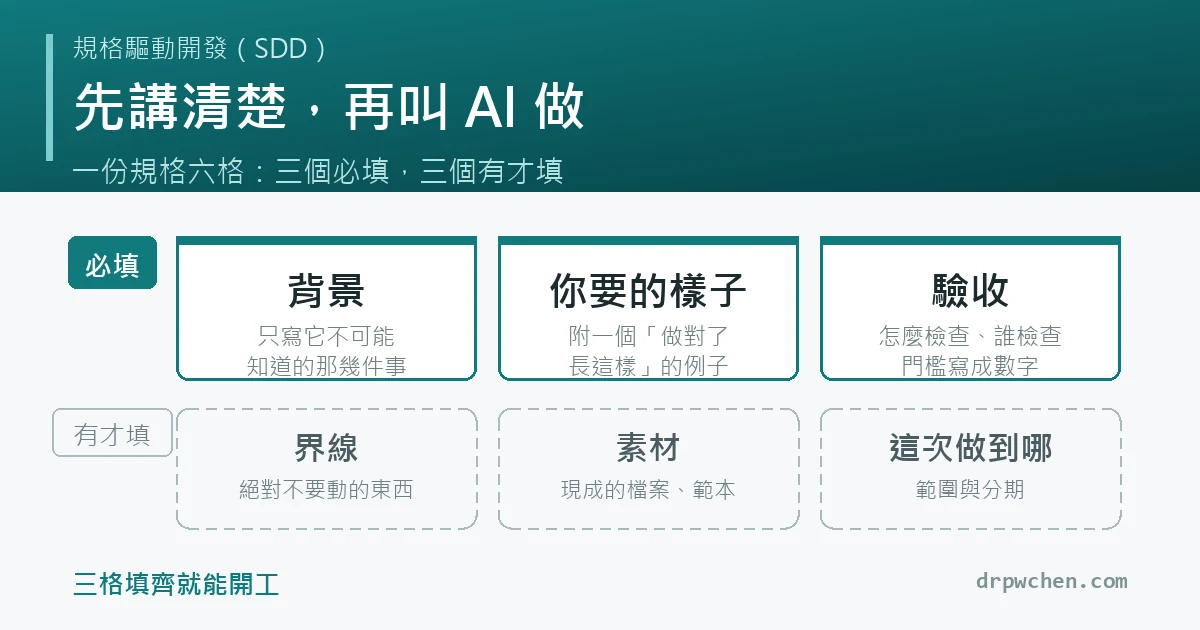
東西大到一句話交代不完,開工前要先寫好什麼?什麼時候不用寫、需求的三個必填零件、含糊一句對上清楚五句、一份可以直接複製的規格範本、改需求先改規格、用程式把這條擋成硬規則,還有為什麼錯的規格錯得很有權威。
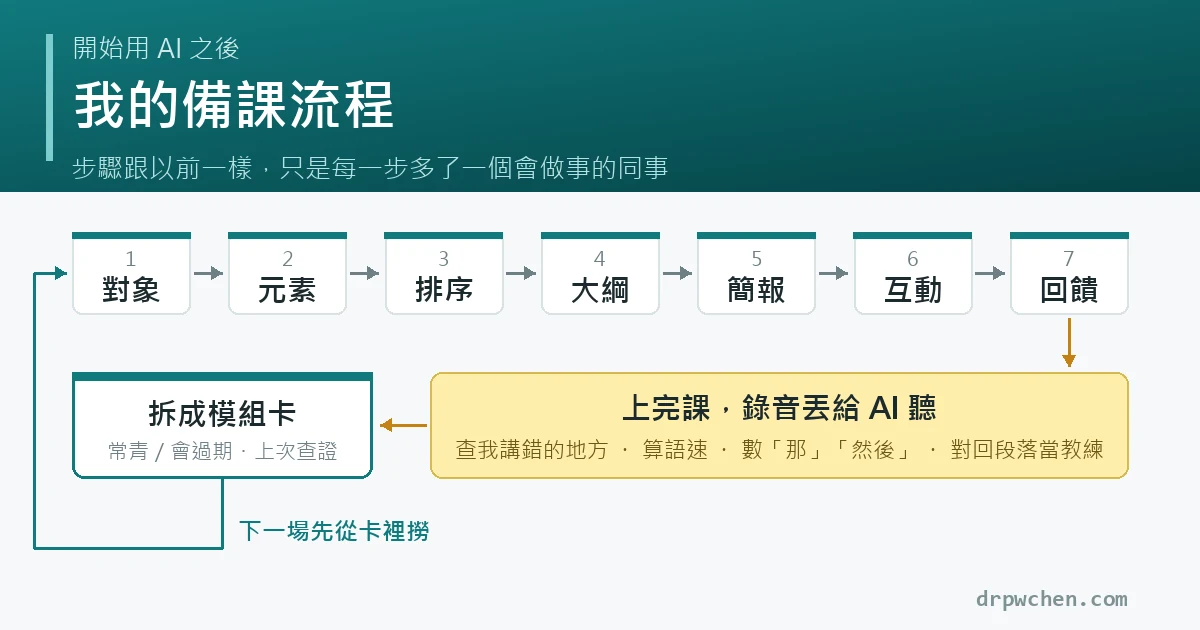
備課的步驟跟沒有 AI 的時候一模一樣,差別是每一步多了一個會做事的同事。這篇把七個步驟攤開來講:對象、元素、排序、大綱、簡報、互動、回饋,每一步我做什麼、他做什麼。最後講上完課之後的事:錄音讓他聽、抓我講錯的地方、算語速、數贅字,然後把這堂課拆成下一場的零件。
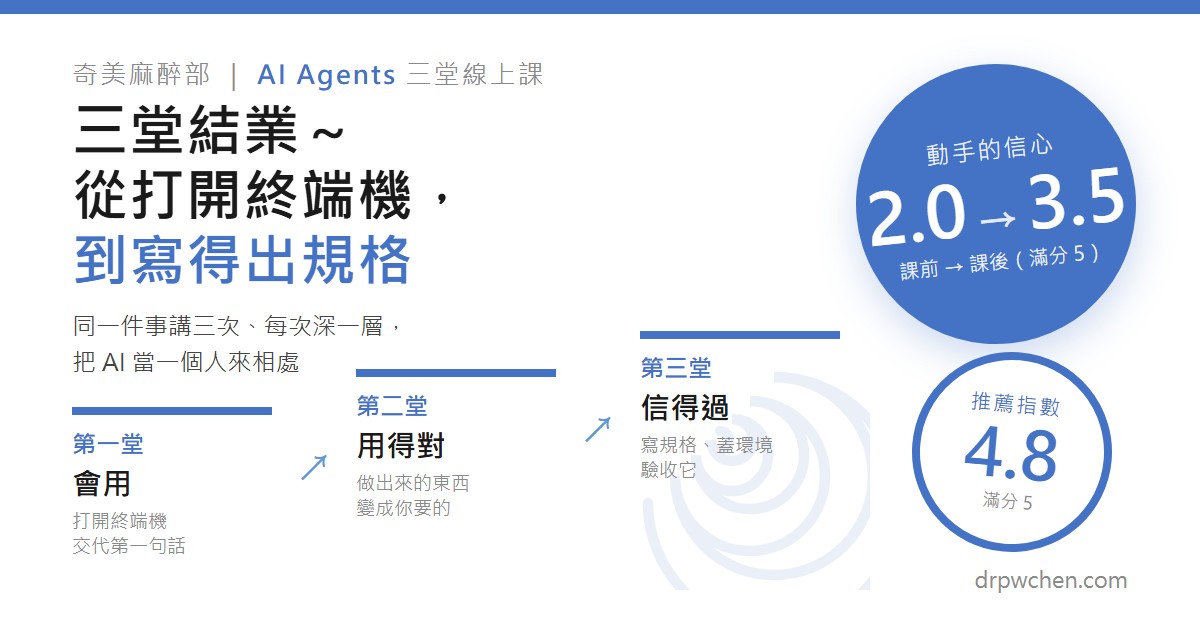
三個週二晚上,每堂一小時再加討論。謝謝奇美麻醉部的鄧醫師邀約,讓我來把一整套課從頭講到尾。 這篇想講三件事:這三堂為什麼這樣排、大家學到了什麼,還有我自己最感恩的一件事。 為什麼拆成三堂、每週一堂 醫學生時代去上過 AMEE 的 ESME(Essential Skills in Medical Education),裡面講到醫學的學習是螺旋式的:同一件事,基礎的時候碰一次,進階再碰一次,一圈一圈繞上去,越繞越熟。 學 AI agent 對醫師來說也是踏進一個陌生的領域,所以這次照同樣的方式排。有些東西三堂都會講到,每次多講深一層,看過三次就不陌生了。 中間刻意隔一週,讓大家回去能夠試作看看,有時做過才知道哪邊會遇到問題、往更深的地方走。 每堂都有課前單、回家作業、課後單,因為也是第二次講這個題目,希望能貼合大家的程度。用的太久太自然,會忘記第一次接觸的人卡在哪裡,這種知識的詛咒只能靠問卷來對齊,第二堂、第三堂的內容都是從上一堂的問卷長出來的。 三堂串起來的一句話:AI 是人 這句話是整套課的脊椎。把 AI 當成一個人:記憶力有限,聊久了會忘記前面講的;現在的個性是會字面解讀你的意思;會犯錯,要核對。把它當人相處,就不會覺得很難,也不會太相信它。 三堂就是繞著這個人轉三圈。 第一堂|會用 怎麼開機、怎麼交代第一句話。三層框架(聊天框、給它檔案、整個資料夾交給它),現場帶著大家打開終端機、整理一個亂資料夾、把 WHO 手術安全查核表轉成筆記。也講了它的記憶是怎麼運作的、為什麼要常常清空對話、怎麼知道它在唬你。 第二堂|用得對 讓它做出來的東西變成你要的東西。跟人講話一樣,要給背景、講要的樣子、畫界線、說怎麼驗收。這堂也講了醫療端的法規:授權範圍、去識別化的門檻、地端跟雲端的差別、衛福部的生成式 AI 指引講了什麼、沒講什麼。然後把自己開發的工具拆給大家看:排班系統從碎碎唸十分鐘到成品的過程,教科書變筆記的工具(textbook-to-note)裡面到底怎麼運作。 第三堂|信得過 怎麼知道它有沒有唬你。主題是 SDD(Spec Driven Development),學習用工程師的角度把東西設計好、維護好。AI 幫你從 0 到 1 很快,1 到 100 要靠規格跟維護。講規格怎麼寫、環境怎麼蓋、怎麼驗收,還有幻覺跟安全性的事。最後再繞到我自己覺得AI時代怎麼學習。 大家有開始實作 CLI 課前跟課後都問了同一題:用終端機跟 AI 一起做事,信心幾分(1 到 5)。課前平均 2.0 分,課後進步到 3.5 分。看起來逐漸入門了~大家應該都有順利做出想要的筆記,還有人自製臨床/讀書/研究工具等。我想最重要的是,產生一個跟AI互動的默契,能在互動中成長出自己的系統。 最感恩的一件事 課排在晚上八點半到九點半,討論常常到快十點。這個時間大家下了班、吃完飯、還要開電腦,第一堂線上四十幾位,第二堂、第三堂還有三十五位。中間當然有人覺得太難或有別的事離開,但留到最後的人這麼多很讓人開心! 後記 那當然這三堂都大量用 AI 來備課,逐字稿回放、問卷分析、投影片改版也都靠它,這個流程蠻好玩的,下一篇單獨寫~ 很喜歡這樣看到大家長出不同的東西,分享這種像在玩電玩的快樂😁 如果有單位想開類似的課,或是三五好友揪一揪,也歡迎來問我喔~
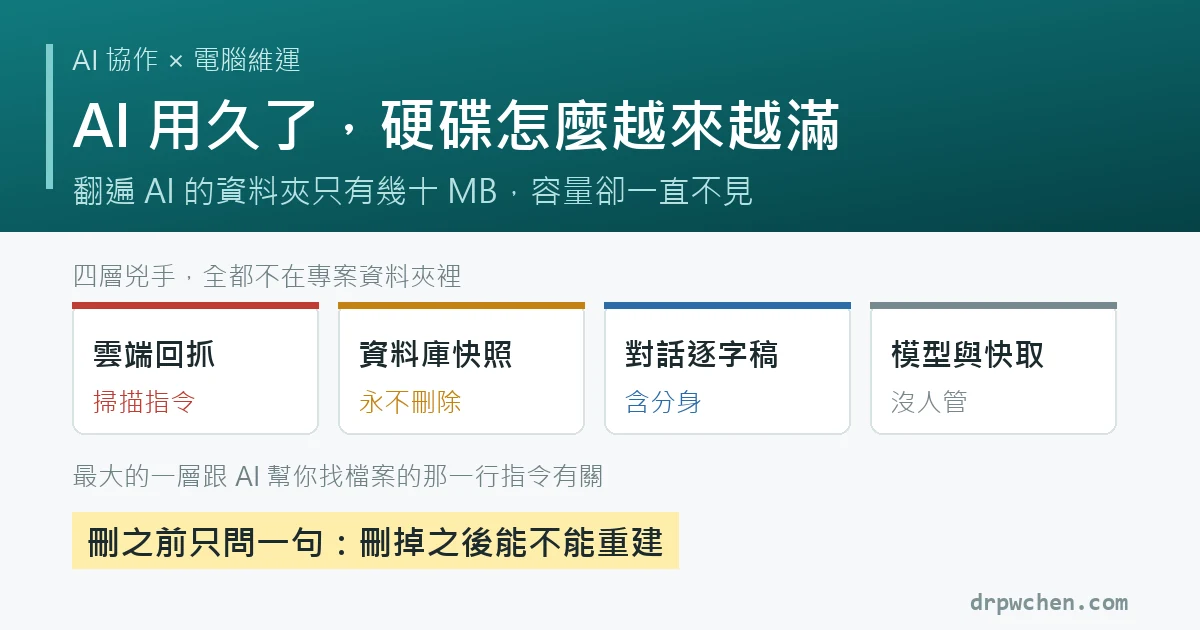
這個題目是訂閱區的歐陽醫師許願的。他說得很準:認真看 AI 運行的資料夾,好像都才幾十 MB,但是電腦容量就是被吃掉一大半。 這件事我自己也遇到很多次了。我的 C 槽 953 GB,過去一個多月每隔幾週就快滿一次,每次都是跟 Claude 說「幫我清理」,清完過陣子又滿回來。這次我們不清了,改成把一個多月來每一次清理的對話全部翻出來對帳,算清楚是誰一直長回來。 查出來四層,照體積排序。其中一層是我們自己開源出去的工具,這個下面會老實講。 一、雲端同步:檔案被讀一次,就永久回到你的電腦 這台電腦的 OneDrive 雲端有大約 400 GB。檔案設成「僅雲端」之後,檔名在、圖示在,不佔空間。但只要有任何程式打開那個檔案,同步軟體就會把它下載回本機,而且除非你自己把它釋放回雲端,它就會一直佔著空間。 八月十七號那次大掃除清出 382 GB。四天後回頭看少了 56 GB,其中課本 PDF 那幾個資料夾自己回到本機 45 GB。 這件事的怪,怪在因果被切斷了。吃掉容量的那個動作,跟長出來的那些檔案,看起來完全沒關係。你翻遍 AI 的資料夾,當然只有幾十 MB。 我們怎麼把它抓出來的 這一段是這篇最想分享的:不是我自己會查,是我跟 Claude 一起把範圍縮小的過程。 第一步,先問清楚機制。 我請他上網查「OneDrive 在什麼情況下會自動把僅雲端的檔案下載回本機」。查回來的答案是:只要有程式開啟那個檔案就會,不必真的讀內容。這一句話後來就是破案關鍵。 第二步,一個一個排除。 每關掉一個嫌疑犯就重新量一次本機佔用: Windows 搜尋索引:停掉六分鐘,佔用沒變化 檔案總管縮圖、防毒掃描、Google Drive、iCloud、Synology Drive:都排除 OneDrive 自己重抓:手動把二十個檔案標成「釋放空間」,六分鐘內一個都沒有被抓回來 排到這裡,OneDrive 本身的嫌疑就洗清了。它只是執行者,不是發動者。 第三步,我提了一句話,方向就轉了。 當下我們一直在找「現在正在跑的東西」,可是我想到:這些下載搞不好是幾個小時前下的指令留下來的,那支程式可能還活著,只是沒人注意。 我把這句話丟給他,他回頭去翻還在執行中的舊程序,當場抓到兩支: 下午五點二十某個 AI session 下的 find 指令,尾巴接了 head,本來只要前二十筆。head 拿夠了自己結束,前面的 find 卻沒有跟著死,一路跑了五個小時,回抓 19 GB 抓它的同時,另一個 session 又下了一支掃全機的 find,三分鐘再吃掉 6 GB 兩支都殺掉之後,回抓當場歸零。 ...
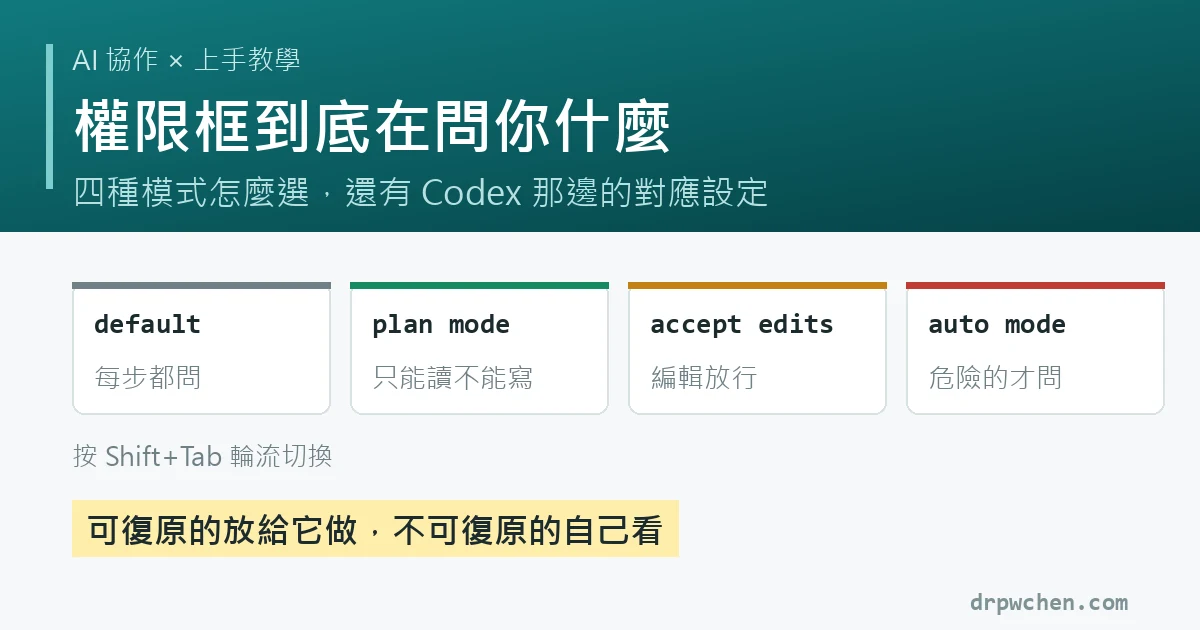
上週幫一群麻醉科的醫師朋友上了一堂 AI agent 上手課。課後回饋很有意思:「權限框與 auto mode」同時出現在兩張名單的前段,投「最有收穫」的人很多,投「沒聽懂」的人也很多。代表這東西重要,但一堂課的節奏講不完。這篇把它一次講完整。 還沒裝起來的朋友,可以先看從零開始用 AI agent那篇,裝好再回來。 權限框是什麼:它動手之前,先舉手 第一次叫 Claude Code 或 Codex 整理資料夾,最不習慣的就是它一直跳框問你「可以嗎?」。 這個框其實是整套系統最重要的安全設計:AI agent 要動你電腦裡的東西之前,必須先讓你點頭。框裡通常有三個部分: 它想跑的指令:一行終端機指令,像 ls、mkdir、rm 它自己的白話解釋:指令下面那一兩行,說明它想做什麼、為什麼 你的選項:同意這次、同意以後都不用問、拒絕 你不需要會終端機指令。你只需要看得懂那行白話解釋,然後判斷「合理嗎」。看不懂的時候有兩招: 看不懂它想幹嘛的兩招 直接回它:「用五歲小孩能懂的方式解釋你現在要做什麼」(英文縮寫叫 ELI5,Explain Like I’m 5,AI 都看得懂) 把那行指令複製,貼給網頁版的 AI 問「這個指令會做什麼?有風險嗎?」 四種模式:按 Shift+Tab 切換 每一步都問你,等它做完一件事你可能按了二十次同意。所以 Claude Code 提供好幾種模式,按 Shift+Tab 就能輪流切換,畫面上會顯示目前在哪個模式。日常用得到的是這四個: 模式 它會怎樣 什麼時候用 default(預設) 每個會改到東西的動作都先問你 剛開始建立信任的階段 plan mode 只能讀、不能寫,先研究再給你一份計畫 想先看它打算怎麼做;要碰重要資料的第一步 accept edits 檔案編輯自動放行,跑指令仍會問 改稿、寫筆記這類編輯密集的工作 auto mode 系統自動判斷每條指令危不危險:安全的直接放行,危險的攔下來問你 日常主力 (Claude Code 其實還有更多模式,像給無人值守環境用的 bypass permissions,那些跟日常上手無關,先不用管。) auto mode 為什麼反而比較安全:警報疲勞 臨床的人對 alarm fatigue 都不陌生:monitor 什麼都叫,叫久了大家聽到聲音只是伸手把它按掉。權限框也一樣。當每一個框都要你同意,你很快就會停止閱讀,變成反射性按同意。這時候「每步都問」給你的不是安全,是安全感。 ...
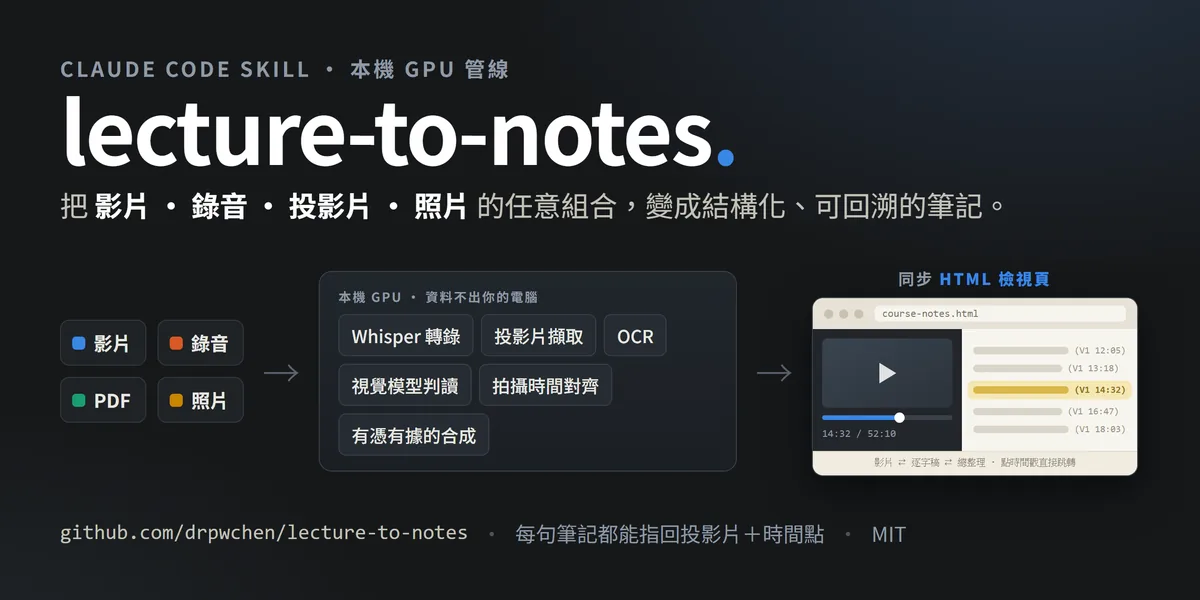
前陣子在臉書分享過用 AI 整理課程影片的成果,收到超乎想像的迴響,也一直有人問工具什麼時候放出來。整理了一陣子,今天正式開源:lecture-to-notes。 這篇的重點 為什麼課程錄影大家都在錄,卻沒有人回去看完 筆記不必是「文字+圖」的形狀:影片、逐字稿、總整理同步在一頁 手上有什麼就帶什麼來:錄影、錄音、投影片、照片,全部接上同一條時間軸 技術上堅持的幾件事:逐字稿永不自動改字、對時用證據不用猜 為什麼只有 OCR 不夠:沒有字的流程圖與超音波,怎麼判斷它重不重要 沒有 NVIDIA 顯卡也能跑的退階方案 教室後面的腳架森林 從以前就覺得復健科的課程很難做筆記。徒手治療、超音波掃描這種課,知識藏在「動作」裡,文字怎麼抄都抄不起來。所以現場永遠是滿滿的腳架,大家都在錄影,打算回去配飯複習。 但幾小時的影片,實際上根本不會回去看完。 想通的一個轉折:筆記不必是「文字+圖」的形狀 有了 AI 之後,我原本的思路是教它精準截圖,把影片塞回傳統「文字+圖片」的筆記形式。後來想通了:筆記不必拘泥於那個形狀。 直接做一個網頁,把影片跟逐字稿對上,想看哪段就跳到哪段。畢竟真正想知道的,是那個動作到底怎麼做——那只存在於影片裡。 所以最後的成品是三個層次疊在同一頁: 總整理拿來讀:結構化的重點筆記,配上當時的投影片 逐字稿拿來驗證:每句話都有時間戳 影片永遠在一鍵之外:影片播到哪,筆記自動高亮;點筆記的時間戳,影片直接跳過去 同一份內容還會輸出 markdown 進 Obsidian 筆記庫(之後語意搜尋找得到),以及 PDF 給不用這些工具的人。一堂課,三種耐久形態。 (截圖是一場頸椎超音波工作坊的實際輸出,日期與講者已馬賽克。) 手上有什麼就帶什麼來 真實的課程從來不會只有一支乾淨的錄影:有的講題錄了影、有的只錄到音、有的只用手機拍了投影片,會後主辦單位又補發一份 PDF 講義。 這個工具把資料夾原樣吃進去,自動判斷每個檔案扮演什麼角色,再把所有來源接上同一條時間軸——就算某張投影片從頭到尾沒出現在影片畫面裡,筆記引用到它的那一刻仍然指得回正確的時間點。 技術上堅持的幾件事 這個工具的設計目標不是「摘要一支影片」,而是可回溯(traceability):筆記裡每句話都要能指回逐字稿的某個時間點、以及當下螢幕上那張投影片。幾個為此堅持的設計: 貴的事情全部在本機跑 Whisper 轉錄、抽幀、OCR、投影片語意判讀,全部在自己的 GPU 上跑完,零 API 費用。大型語言模型只在最後一步負責「寫」,而且只能根據前面各階段已經組好的證據寫。就算不跑最後一步,你也已經拿到逐字稿、去重後的投影片集、和兩者的對應關係。 逐字稿永遠不自動改字 自動改錯字聽起來很誘人,我們實際做了兩版、量測、然後全部退役。現在可疑的詞只會被「標記」出來,逐字稿本身一個 byte 都不動。每個標記是一個問題,不是一個替換——因為改錯了你永遠不會發現。 對時:檔案時間是假說,交叉比對才是證據 一場演講常常不只一個裝置在錄:主錄影、手機片段、照片。要拼回同一條時間軸,最直覺的做法是相信每個檔案自己的拍攝時間——而手機時鐘會漂移、有些檔案只剩修改時間、按過暫停的錄影會謊報自己的開始時間。 所以管線把兩件事分開:拍攝時間當「主張」,重疊音訊的交叉比對當「證據」。兩者差超過 5 秒,就標記衝突並停下來問人,絕不自動修正。這擋掉的是「44 分鐘對錯位、但每一頁輸出看起來都很正常」的災難。 缺工具就大聲說,不悄悄降級 選用的模型都經過自己資料的評測(repo 裡附了 OCR 引擎的 A/B 測試架)。可選的套件沒裝,功能會關掉並明講你少了什麼——絕不悄悄換一個比較差的方法。悄悄降級產生的是「錯的輸出」而不是「少的輸出」,那是最貴的一類 bug。 那張投影片上沒有半個字,怎麼辦? 貼文發出來之後,有位朋友留言問:「請問您是把螢幕上的 PPT 以 OCR 方式彙整進入資料庫嗎?」這個問題剛好戳中我卡最久的一段,值得展開講。 ...
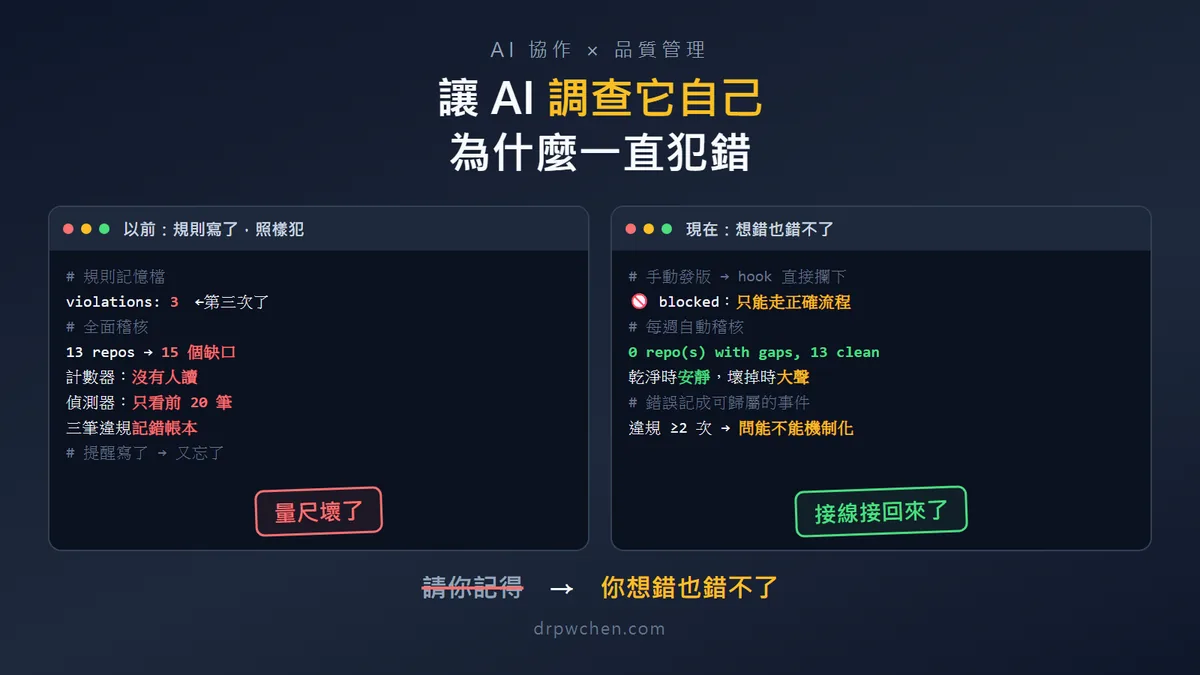
用 AI 工作一陣子的人,大概都遇過這件事:同一個錯,你講過了,規則也請它記下來了,過幾天它又犯一次。 而且我不是沒有防:規則寫進了它的記憶檔、違規有計數器、還有每月的定期檢視,該有的機制都在。但七月底,我看著我的 AI 助理第三次犯下同一個錯(最後兩次只隔一天),才認真面對一個事實:「記得」跟「會做」是兩回事。而更意外的是,後來的調查發現,問題甚至不在它不記得,是我們整套「記錯誤」的系統,量尺本身壞掉了。 這篇想分享的,就是我們最後長出來的一套「AI 自我糾錯系統」的設計,以及中間最有趣的一段:我讓 AI 自己調查自己,還特別交代它「不要相信寫交班單的那個 AI」。 事情是怎麼爆開的 這陣子我陸續把一些自己做的工具開源(工具箱總整理裡的那些)。發布開源軟體有一套禮儀:改了什麼要寫進更新紀錄(CHANGELOG)、打版本標籤(tag)、在 GitHub 上建立正式的發布頁(release)。這些規則早就寫在 Claude 的記憶檔裡。 七月底某天,我點開一個剛發布新版的 repo,首頁看起來什麼都沒有。我第一反應是「你沒寫 CHANGELOG」。它查了之後回報:CHANGELOG 其實寫了,tag 也打了,漏的是最後一步「建立 release」,而那恰好是訪客唯一看得到的一步。回頭一查,前兩個版本也都一樣。 隔天我請它把我全部十三個公開 repo 掃一遍,結果挖出十五個同樣的缺口。更妙的是,就在稽核到一半的時候,它又犯了第三次同型的錯。規則就寫在它的記憶裡,它也讀得到,然後照樣犯。 關鍵的一問:「你以後真的會用嗎?」 它的第一個提案很自然:寫一支腳本,把正確的發版流程整個包起來。 我問了一句:「你以後會固定呼叫這支腳本嗎?」 它想了一下,誠實地說:不會。腳本跟記憶檔的失效模式一模一樣,都要它先「想起來」才有用。這個答案讓我們改變了做法:與其多一個要記得的東西,不如加一道攔截(hook,上手系列第二篇講過的關卡概念):只要它想手動跑發版指令,動作會在當下直接被擋下來,只剩包好的正確流程能走。從「請你記得」變成「你想錯也錯不了」。 讓它調查自己,但不准相信自己 前面說過,揪錯的零件一直都在。所以問題比「沒有機制」更刁鑽:零件都在,錯還是溜過去了,到底卡在哪? 這裡我們用了一個我很喜歡的設計。當天犯錯的那個 AI session 把來龍去脈寫成一份調查交班單,但裡面明白寫著一條: 交班單裡的自我迴避條款 「不要把我的假設當成計畫——這份文件是犯錯者本人寫的,幾乎必然被它的立場影響。請先獨立驗證診斷,再決定要不要建任何東西。」 接著換一個全新的 session 接手調查,手上只有可以重跑的驗證指令,沒有前一位的結論。 做過品質改善的人應該覺得眼熟:根本原因分析(root cause analysis)的調查,本來就不該由事件當事人自己主導。當局者迷這件事,對 AI 一樣成立。 調查結果:推翻了兩個前提 獨立調查翻出來的東西,跟交班單猜的不一樣。 第一,AI 並沒有隱瞞錯誤。我原本合理懷疑:違規次數是它自己記的,它會不會少記?結果翻遍紀錄,低報只有零星幾筆,而且是「自首了但記錯地方」。其中一個規則檔裡,它老老實實記了十二次違規,好幾次我根本沒發現。誠實度不是問題。 第二,問題出在量測層。幾個具體的發現: 計數無法歸屬:違規次數記在「檔案」上,但一個檔案裡合併了十幾條規則。帳面上的「違規 4 次」,追不回是哪一條規則的 4 次,這個數字沒有行動意義。 偵測器本身有 bug:負責從歷史對話裡撈「使用者糾正過什麼」的程式,寫死了只看最近二十筆,而且漏看一整類訊息格式。回頭驗證時發現,最關鍵的那筆證據,它從結構上就不可能抓到。 記錯帳本:有三筆真正的違規,被寫進了另一本記「工具摩擦」的帳,正好躲過所有檢查。 還有一個反轉:交班單斷言「這些計數完全沒有版本紀錄,無從稽核」。錯了——記憶目錄其實一直有自己的 git 版本庫,一千多筆自動存檔,稽核軌跡從頭到尾都在,只是被上層設定蓋住,連 AI 自己都不知道。 換句話說:這個系統不缺零件,缺的是接線。計數器沒有人讀、偵測器壞著、帳本記錯棚。在量尺壞掉的情況下加更多自動化,只是把錯的數字算得更快而已。所以後面的修法幾乎沒有新建什麼大東西,都是把既有的零件接起來。 最後的設計:四條原則 修完之後,整套系統收斂成四條原則。它們不是 AI 專用的,你會發現每一條在醫院的品質管理裡都有對應物。 一、錯誤要記成「可歸屬的事件」,不是一個數字。每次違規記一行:日期+哪一條規則+一句事實。計數是用數的,不是用手改的。(對應:異常事件通報寫事件經過,不是只在統計表上加一。) ...
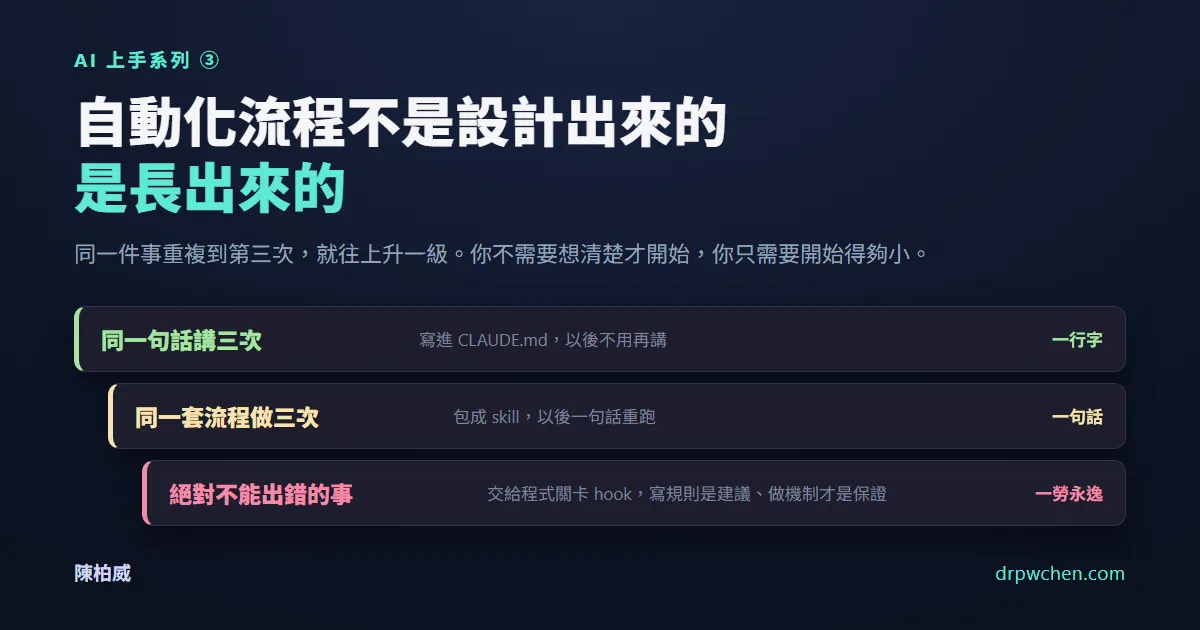
這是 AI 上手系列的第三篇。第一篇講怎麼裝起來,第二篇講怎麼跟它講話、怎麼設關卡。 第二篇的結尾我說:難的從來不是「怎麼問」,是「怎麼設計流程」。 這篇要把那句話收掉。答案可能跟你想的相反:流程不是設計出來的,是長出來的。 最常見的卡點:「我不知道要怎麼開始規劃」 我被問過很多次類似的問題:「你那套自動化好厲害,我要怎麼規劃我自己的?」 老實說,我從來沒有規劃過。我三月的時候只做了一件事:挑了一件每週都在重複的小事,叫它做一次。 今天回頭看,我的規則檔、十幾個 skill、一堆自動排程,沒有一個是事先設計的。每一個都是同一件事重複了幾次之後,才「升級」成現在的樣子。 所以如果你卡在「不知道怎麼開始」,好消息是:你不需要想清楚才開始,你只需要開始得夠小。 起手式:五件事講清楚,其他都不用 挑好那件小事之後,交代它的時候把這五件事講清楚。這不是我發明的,是把官方 best practices 濃縮成非工程師版本: ① 目標講清楚:你要什麼、給誰用、拿去做什麼。「幫我整理逐字稿」不如「整理成 SOAP 格式,這是要放進病歷系統的」。 ② 只補它不知道的:你們科的慣例、單位的格式、只有你知道的眉角。模型已經會的不用教:SOAP 是什麼不用解釋,你們科的 SOAP 長什麼樣才要講。每一句廢話都在稀釋它的注意力(原因寫在第二篇「為什麼它會越聊越笨」那節)。 ③ 界線先講:哪些檔案不准動、哪些事要先問過你。而且真正的紅線不要只用嘴巴講,第二篇的三層機制(hooks / permissions / CLAUDE.md)就是拿來放這個的。 ④ 訂「怎樣算做完」:這條是官方排第一優先的建議,也是我覺得投資報酬率最高的一條。給它一個它能自己跑的檢查: ❌「幫我整理這些逐字稿」 ✅「整理完自己檢查一遍:每一份都要有四段、每段都要有內容,缺的標出來給我」 ⑤ 先跑一個爛版本:不滿意再一句話改。迭代永遠比一次寫滿快。 就這樣。不用畫流程圖、不用寫規格書。 流程怎麼長大:重複第三次,就升一級 真正的重點來了。你的「流程」不是某天坐下來設計的,它是照一個很簡單的規則長出來的: 同一件事重複到第三次,就往上升一級。 你發現自己在… 升級動作 成本 同一句話講第三次(「回我繁體中文」) 寫進 CLAUDE.md 一行字 同一套多步驟流程做第三次(先轉檔、再整理、再歸檔) 包成 skill:跟它說「把剛剛這整套存成一個 skill」 一句話 發現某件事絕對不能出錯(改到原始檔、送出病人資料) 交給程式關卡(hook / permissions) 要動手設定,但一勞永逸 三層的差別在第二篇講過了,這裡只補一句:寫在規則裡是建議,做成機制才是保證。 界線越重要,就該住在越下面那層。 這個階梯還有一個隱藏的好處:每一級都是你已經驗證過的東西。你不是在憑空設計一個 skill,你是把一套「已經手動跑成功三次」的流程存起來而已。設計可能會錯,重複不會。 驗收的習慣:這篇最重要的一節 起手式的第④點(訂「怎樣算做完」)值得單獨拉出來講,因為它不是五件事之一而已。它是整套方法裡唯一「做與不做會決定你能走多遠」的習慣。 驗收有三個層次,照順序養成: 層次一:單次驗收。 每個任務交代時就附上檢查方法,讓它做完自己查(「每一份都要有四段、缺的標出來給我」)。這是起手式教的。 層次二:可重跑的驗收。 把檢查存下來,變成隨時可以再按一次的按鈕。差別很大:單次驗收保證「這次做對了」,可重跑的驗收保證「以後改東西也不會弄壞它」。工程師管這個叫回歸測試(regression test),但概念本身跟程式無關:哪怕你的檢查只是「數一數每份紀錄都有四段」,能重跑,就有資格叫驗收。 層次三:驗收先行。 這是官方 best practices 裡明講的工作流:先寫檢查、確認它現在會失敗,再叫 AI 做到通過。聽起來像工程師的儀式,翻成白話就是:開工前先給它看一個「做對了長這樣」的具體例子。它有目標可以自己迭代,你也不會做完才發現彼此想的不一樣。 ...